ScraperAPI tient ses promesses sur l’essentiel : rotation automatique des proxys, contournement des CAPTCHA et rendu JavaScript. Tu envoies une requête, tu récupères les données d’un site web, sans gérer toi-même les IP bloquées.
Les avis sont majoritairement positifs, avec une note de 4,5/5 sur Trustpilot et de très bons retours sur G2 et Capterra. Cette API de web scraping convient aussi bien à un projet perso qu’à une entreprise.
Les seuls vrais bémols concernent la tarification et les scrapings à très grande échelle.
Voici un récapitulatif des points forts et des points faibles de ScraperAPI selon les retours d’utilisateurs :
| ✅ Points forts | ❌ Points faibles |
|---|---|
| Contournement efficace des CAPTCHA | Tarification peu claire |
| Gestion automatique et efficace des proxys | Limitations occasionnelles de débit et de requêtes |
| Rendu JavaScript fiable | Peu adapté aux très gros volumes |
| Support multi-langages (Python, Node.js, PHP…) | Documentation avancée perfectible |
| Intégration facile et API simple |
Avis global sur ScraperAPI
Les utilisateurs résument ScraperAPI en trois mots : rapide, fiable, efficace.
D’après les avis récoltés sur Trustpilot, G2 et Capterra, la note moyenne tourne autour de 4,5/5. Ces notes bougent souvent, pense à les vérifier au moment de ton check.
| Plateforme | Note sur 5 |
|---|---|
| Trustpilot | 4,5(sur environ 42 avis) |
| G2 | 4,3/5 |
| Capterra | 4,6/5 (note service client) |
Les points forts qui reviennent le plus souvent dans les avis :
- Fiabilité et efficacité du scraping, même sur des sites complexes.
- Facilité d’intégration : une simple clé API suffit pour démarrer.
- Support client réactif et bien noté.
- Bon rapport qualité-prix pour un usage régulier.
- Fonctionnalités avancées comme la rotation d’IP et le rendu JavaScript.
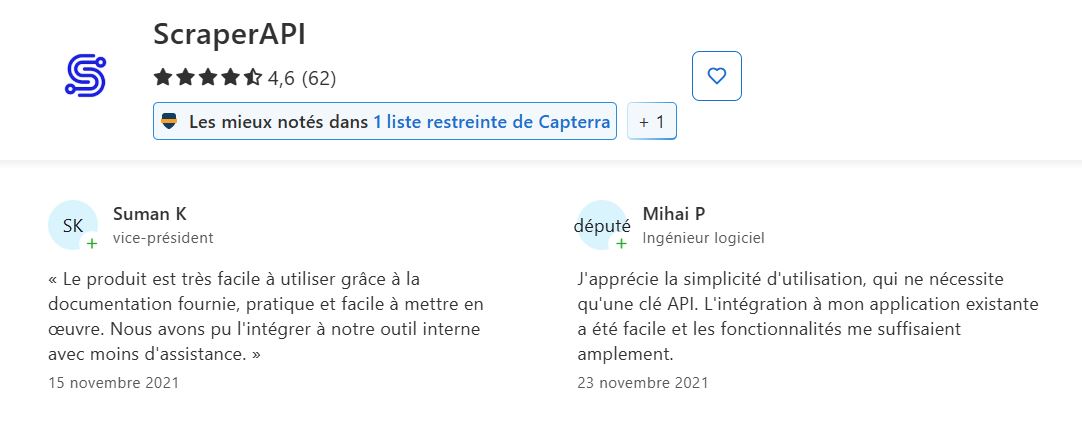
Selon Suman K et Mihai P sur Capterra :
« Le produit est très facile à utiliser grâce à la documentation fournie, pratique et facile à mettre en œuvre… »
« J’apprécie la simplicité d’utilisation, qui ne nécessite qu’une clé API. L’intégration à mon application existante a été facile et les fonctionnalités me suffisaient amplement. »
Akif confirme sur Trustpilot :
« Leur service client est excellent… »

Muhammad H. sur G2 insiste sur le gain de temps face aux problèmes techniques :
« Il simplifie le web scraping en gérant la gestion des proxys, les CAPTCHAs et le rendu du navigateur, me permettant de me concentrer sur l’extraction de données plutôt que sur les problèmes techniques. L’API s’intègre parfaitement dans mon code existant, et la vitesse est impressionnante, même pour des projets à grande échelle. »

Côté défauts, les utilisateurs pointent surtout ceci :
- Clarté de la tarification : le système de crédits, avec ses multiplicateurs selon le type de requête, laisse parfois les gens perplexes.
- Documentation à approfondir pour les fonctionnalités les plus avancées.
- Quelques échecs de requêtes ou limitations de débit occasionnels.
- Un support jugé inégal selon les cas.
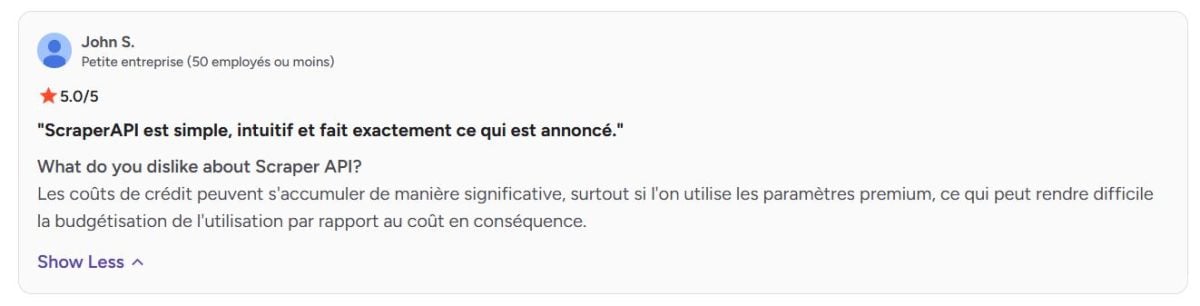
Selon John S. sur G2, la note de crédits monte vite dès que tu actives les options premium :
« Les coûts de crédit peuvent s’accumuler de manière significative, surtout si l’on utilise les paramètres premium, ce qui peut rendre difficile la budgétisation de l’utilisation par rapport au coût en conséquence. »
Avis sur les services proposés par ScraperAPI
Voici le détail des services clés de ScraperAPI et ce que les utilisateurs en retiennent vraiment, service par service.
1. Rotation automatique des proxys
ScraperAPI s’appuie sur un vaste pool de proxys qu’il fait pivoter automatiquement à chaque requête. Cette rotation d’IP limite fortement les blocages quand tu enchaînes les appels vers un même site.
Le retour de Aditya Pratap Singh sur Trustpilot :
« ScraperAPI a révolutionné mes projets de web scraping. J’étais constamment aux prises avec des CAPTCHA et des blocages d’adresses IP avant de trouver ce service. Maintenant, je peux me concentrer sur l’utilisation des données au lieu de me battre pour les obtenir. La rotation du proxy est fluide et j’apprécie la gestion automatique du rendu JavaScript. »

2. Gestion du contournement des protections (Bypass)
L’outil sait contourner les mécanismes anti-bot complexes, les pare-feu et les CAPTCHA. Résultat : une extraction de données plus fluide, même sur des sites très protégés comme Google.
D’après Arun K., chercheur associé :
« Google a réussi à bloquer les requêtes programmatiques, même à des fins non commerciales et d’auto-archivage, et ScraperAPI s’est montré extrêmement efficace pour les contourner. Bien que le routage des requêtes via ScraperAPI soit beaucoup plus lent que, par exemple, via un serveur proxy gratuit. »
À noter : ce gain de fiabilité se paie parfois par un temps de réponse plus long qu’un simple proxy classique.

3. Rendu JavaScript
Grâce à un navigateur sans tête intégré, ScraperAPI peut scraper des sites dynamiques dont le contenu est chargé via JavaScript. Tu récupères ainsi le HTML réellement affiché, et pas seulement le HTML brut renvoyé par le serveur. C’est essentiel pour faire du parsing fiable sur des pages générées côté client.
Le retour de Fazt Tech sur Trustpilot :
« ScraperAPI a considérablement amélioré nos processus de scraping web. L’API est simple à intégrer et prend en charge la plupart des tâches lourdes, comme la rotation des adresses IP et la gestion des proxys, ce qui nous fait gagner un temps précieux. La gestion automatique des captchas est un atout majeur et simplifie considérablement notre collecte de données. »

4. Personnalisation des requêtes
Tu peux personnaliser tes requêtes HTTP en modifiant les en-têtes, les cookies ou le user-agent. Cela aide à simuler différents comportements et à éviter la détection sur les sites les plus stricts.
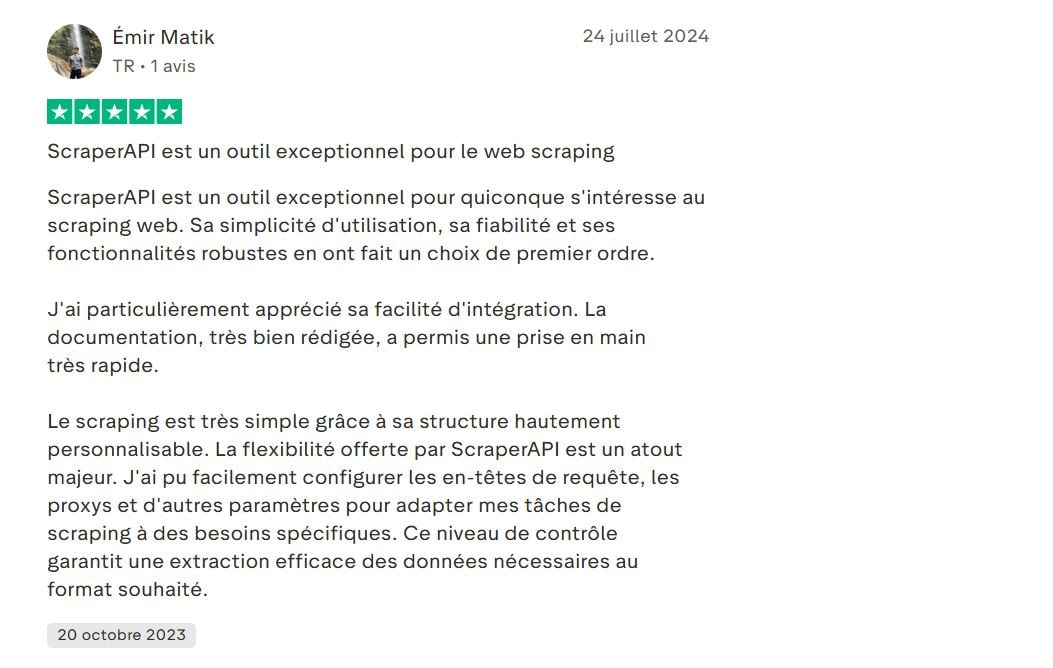
L’avis de Émir Matik sur Trustpilot :
« …Le scraping est très simple grâce à sa structure hautement personnalisable. La flexibilité offerte par ScraperAPI est un atout majeur. J’ai pu facilement configurer les en-têtes de requête, les proxys et d’autres paramètres pour adapter mes tâches de scraping à des besoins spécifiques… »
5. Géolocalisation des proxys
ScraperAPI te laisse choisir l’emplacement géographique des proxys, par pays. Ce géociblage est utile pour récupérer des données localisées ou tester des résultats propres à une région, par exemple des prix qui varient selon le marché.
Le retour de Melih Krs sur Trustpilot :
« …De plus, sa prise en charge du rendu JavaScript et de la géolocalisation IP a été précieuse… »

6. Tableau de bord et statistiques
Un tableau de bord complet suit ton utilisation, le nombre de requêtes, le taux de réussite et les crédits restants. Tu gardes ainsi un oeil clair sur ta consommation et tu ajustes ton plan selon la charge réelle.
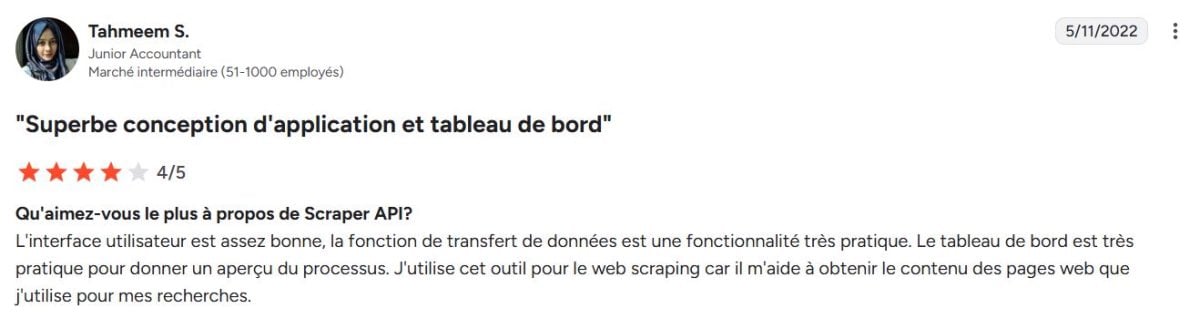
Selon Tahmeem S. sur G2 :
« L’interface utilisateur est assez bonne, la fonction de transfert de données est une fonctionnalité très pratique. Le tableau de bord est très pratique pour donner un aperçu du processus. J’utilise cet outil pour le web scraping car il m’aide à obtenir le contenu des pages web que j’utilise pour mes recherches. »
7. Intégration et support multi-langages
ScraperAPI propose une API REST simple, facile à intégrer avec la plupart des langages : Python, Node.js, PHP, Java, etc. Cette intégration rapide facilite son adoption dans des environnements variés, du petit script au projet en production.
Ce que dit Deni H. sur G2 :
« L’expérience pour l’API Scraper est probablement celle d’un développeur expérimenté en scraping web avec des connaissances de diverses technologies de scraping, y compris Python (BeautifulSoup et Selenium), JavaScript (Puppeteer ou Cheerio), et Node.js (Demand et Cheerio)… »

8. Fonctionnalités avancées pour les données
Au-delà du scraping classique, ScraperAPI pousse plus loin le traitement des données et l’automatisation à grande échelle :
- Scraping asynchrone : tu envoies des millions de requêtes en parallèle, idéal pour la collecte à très grande échelle sur de nombreux sites.
- Endpoints de données structurées : pour certains sites populaires, les données sont renvoyées directement au format JSON, prêtes à l’emploi sans étape de parsing supplémentaire. C’est particulièrement utile pour les projets de type hobby comme pour les équipes en startup qui veulent aller vite.
ScraperAPI : les alternatives
ScraperAPI n’est pas le seul acteur sur le marché du web scraping. Plusieurs alternatives se distinguent par leur approche, leurs tarifs ou leurs fonctionnalités. Voici les principales à connaître avant de choisir ton outil.
| Outil | Particularité | Avis utilisateurs | Note moyenne |
|---|---|---|---|
| ScraperAPI | Rotation automatique des proxys, rendu JavaScript, personnalisation | Fiable et simple d’utilisation, mais parfois confuse sur la tarification | 4,5 |
| Bright Data | Plateforme très complète, avec proxys premium et pipeline de données avancé | Très puissant et flexible, mais complexe à prendre en main | 4,6 |
| ScrapingBee | API simple avec rendu JS et rotation de proxys | Facile à intégrer et bon rapport qualité/prix, mais moins d’options avancées | 4,9 |
| Octoparse | Scraping visuel sans code, approche sans programmation | Idéal pour les non-techniciens, mais limité sur les gros volumes | 4,4 |
| Apify | Plateforme de développement de scrapers sur mesure | Très flexible et personnalisable, mais demande des compétences techniques | 4,8 |
Concrètement, chaque solution vise un profil différent. ScrapingBee reste le concurrent le plus proche de ScraperAPI sur les petites et moyennes charges. Octoparse parle aux non-développeurs qui veulent extraire des données sans écrire une ligne de code. Apify, lui, s’adresse aux équipes techniques qui construisent leurs propres scrapers.
Si tu as des besoins en très grande échelle, avec un pool de proxys premium et un pipeline de données poussé, Bright Data vaut le détour.
C’est la solution la plus puissante du marché, mais aussi la plus chère et la plus longue à prendre en main. Pour la majorité des cas d’usage, ScraperAPI garde un excellent rapport qualité/prix.
Niklas résume bien ce positionnement sur Capterra :
« Bright Data est un service plus cher, mais le meilleur de sa catégorie. »

FAQ
ScraperAPI est-il un outil gratuit ?
Non, ScraperAPI est payant, mais il propose quand même une offre gratuite limité, avec un petit crédit de requêtes pour tester le service avant de choisir un plan.
Combien coûte ScraperAPI ?
Les tarifs démarrent à 49$/mois (Hobby) et montent jusqu’à 1 975$/mois, avec une offre Enterprise sur devis pour les très gros volumes.. Le prix dépend du plan choisi, du volume de requêtes et des options activées comme le rendu JavaScript ou le géociblage. Il existe des plans adaptés aux projets hobby comme aux startups en croissance.
Chaque requête consomme un nombre de crédits variable. Une simple page en HTML brut coûte peu, alors qu’une requête avec proxy premium ou rendu JavaScript en consomme beaucoup plus.
C’est pour ça que les crédits d’un plan s’épuisent vite quand tu scrapes des sites complexes.
Comment fonctionne ScraperAPI ?
ScraperAPI agit comme un intermédiaire entre ton application et les sites web à scraper. Il gère automatiquement la rotation des proxys, la gestion des IP, le rendu JavaScript et le contournement des protections.
Concrètement, tu envoies une requête à l’API et tu récupères le contenu HTML de la page ciblée, sans te soucier des blocages. L’outil s’appuie sur un large pool de proxys répartis dans de nombreux pays pour récupérer les données sans blocage.
Comment utiliser ScraperAPI avec Python ?
L’intégration avec Python est simple grâce à une API REST bien documentée. Il te suffit d’envoyer une requête HTTP à l’adresse de l’API avec ta clé API et l’URL cible.
1. Définis l’URL ScraperAPI avec ta clé API et l’URL cible
import requests

url = "http://api.scraperapi.com"
params = {
    'api_key': 'TA_CLE_API',
    'url': 'https://exemple.com'
}
2. Envoie la requête
response = requests.get(url, params=params)3. Affiche le contenu de la page récupérée
print(response.text)Tu peux ensuite faire du parsing HTML avec une bibliothèque comme BeautifulSoup, ou exploiter directement les endpoints de données structurées, qui renvoient les données en JSON prêt à l’emploi.
Est-ce que ScraperAPI peut contourner les CAPTCHA ?
Oui. L’un des points forts de ScraperAPI est sa capacité à contourner automatiquement les CAPTCHA et les autres systèmes anti-bot. C’est ce qui explique son bon taux de réussite sur beaucoup de sites protégés.
ScraperAPI reste une solution performante pour automatiser la collecte de données en ligne. N’hésite pas à poser tes questions en commentaire et à partager ton expérience !







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA