ScraperAPI cumpre as suas promessas no que é essencial: rotação automática dos proxies, contornar os CAPTCHA e Renderização JavaScript. Envias um pedido, obténs os dados de um site, sem teres de gerir tu próprio os Endereços IP bloqueados.
As opiniões são, na sua maioria, positivas, com uma classificação de 4,5/5 no Trustpilot e comentários muito positivos sobre G2 e Capterra. Esta API de web scraping é adequada tanto para um projeto pessoal como para uma empresa.
Os únicos pontos negativos dizem respeito à preços e os scrapings a muito grande escala.
Eis um resumo dos pontos fortes e dos pontos fracos de ScraperAPI de acordo com os comentários dos utilizadores:
| ✅ Destaques | Pontos fracos |
|---|---|
| Contornamento eficaz dos CAPTCHA | Preços pouco claros |
| Gestão automática e eficiente de proxies | Restrições ocasionais ao débito e aos pedidos |
| Renderização fiável de JavaScript | Não é adequado para volumes muito grandes |
| Suporte a várias linguagens (Python, Node.js, PHP…) | A documentação avançada poderia ser melhorada |
| Integração fácil e API simples |
Opinião global sobre a ScraperAPI
Os utilizadores resumem ScraperAPI em três palavras: velozes, fiável, eficaz.
De acordo com as opiniões recolhidas em Trustpilot, G2 e Capterra, a nota média ronda os 4,5/5. Estas notas mudam frequentemente, por isso não te esqueças de as verificar na altura do teu check.
| Plataforma | Pontuação de 5 |
|---|---|
| Trustpilot | 4,5(com base em cerca de 42 avaliações) |
| G2 | 4,3/5 |
| Capterra | 4,6/5 (nota do serviço de apoio ao cliente) |
Os pontos fortes que mais frequentemente aparecem nas opiniões:
- Fiabilidade e eficiência da raspagem, mesmo em sites complexos.
- Facilidade de integração : basta uma simples chave API para começar.
- Apoio ao cliente reativo e com boas notas.
- Bom valor para o dinheiro para utilização regular.
- Funcionalidades avançadas como a rotação de imagens e a renderização JavaScript.
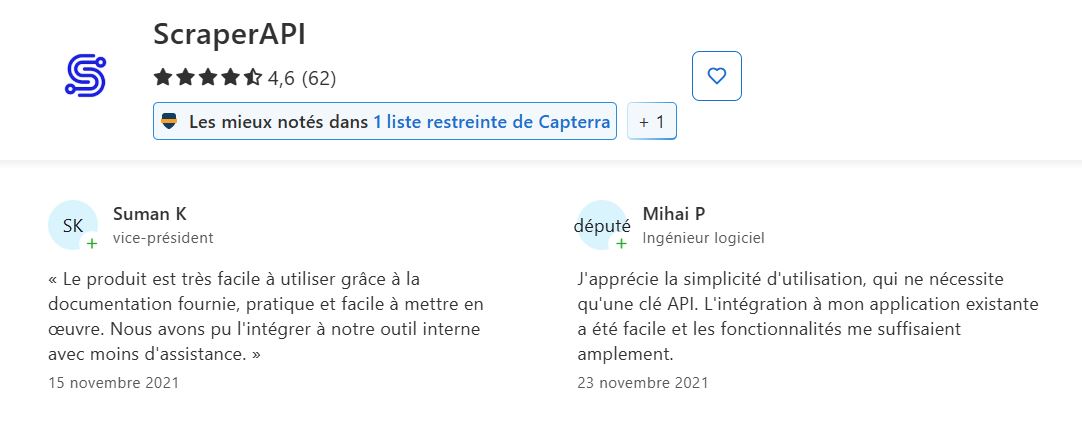
De acordo com Suman K e Mihai P sobre Capterra :
"O produto é muito fácil de utilizar graças à documentação fornecida, é prático e fácil de implementar..."
"Gosto da facilidade de utilização, que requer apenas uma chave de API. A integração com a minha aplicação existente foi fácil e a funcionalidade foi mais do que suficiente para mim."
Akif confirma em Trustpilot :
"O seu serviço de apoio ao cliente é excelente..."

Muhammad H. sobre G2 salienta a poupança de tempo face aos problemas técnicos:
"Simplifica a recolha de dados da Web através da gestão de proxies, CAPTCHAs e renderização do browser, permitindo-me concentrar-me na extração de dados e não em questões técnicas. A API integra-se perfeitamente no meu código existente, e a velocidade é impressionante, mesmo para projectos de grande escala."

No que diz respeito às falhas, os utilizadores destacam sobretudo o seguinte:
- Transparência na fixação de preços : o sistema de créditos, com os seus multiplicadores consoante o tipo de pedido, deixa por vezes as pessoas perplexas.
- Documentação a aprofundar no que diz respeito às funcionalidades mais avançadas.
- Algumas falhas nas consultas ou limitações de caudal ocasionais.
- UMA Apoio, suporte considerado desigual, dependendo dos casos.
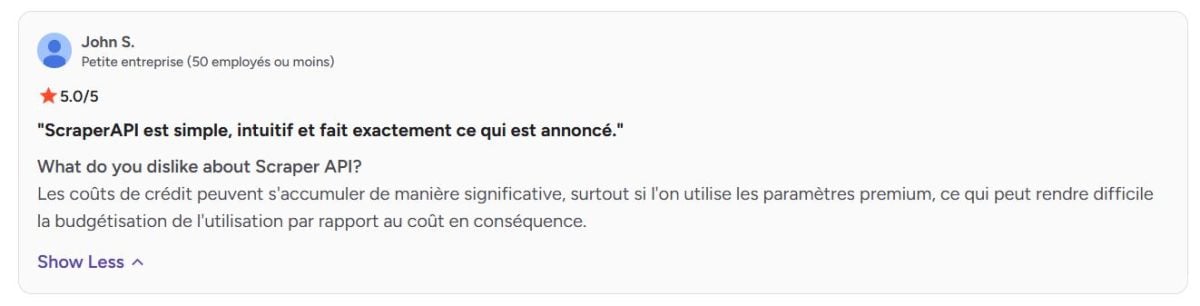
De acordo com John S. sobre G2, o valor da fatura aumenta rapidamente assim que ativares as opções premium:
"Os custos de crédito podem aumentar significativamente, especialmente se forem utilizadas definições premium, o que pode dificultar a orçamentação da utilização em função do custo."
Opinião sobre os serviços oferecidos pela ScraperAPI
Eis o detalhe dos principais serviços de ScraperAPI e o que os utilizadores realmente retêm, serviço a serviço.
1. Rotação automática de proxies
ScraperAPI baseia-se num vasto conjunto de proxies que ele gira automaticamente a cada consulta. Esta rotação de IP reduz significativamente os bloqueios quando se fazem chamadas consecutivas para o mesmo site.
O regresso de Aditya Pratap Singh sobre Trustpilot :
"O ScraperAPI revolucionou os meus projectos de recolha de dados da Web. Estava constantemente a debater-me com CAPTCHAs e bloqueios de endereços IP antes de encontrar este serviço. Agora posso concentrar-me em utilizar os dados em vez de lutar por eles. A rotação de proxy é suave e aprecio o tratamento automático da renderização de JavaScript."

2. Gestão da proteção contra desvios
A ferramenta consegue contornar as mecanismos anti-bot complexos, as firewalls e os CAPTCHA. Resultado: uma extração de dados mais fluida, mesmo em sites altamente protegidos como Google.
De acordo com Arun K., investigador associado:
"O Google tem sido bem sucedido no bloqueio de pedidos programáticos, mesmo para fins não comerciais e de auto-arquivo, e a ScraperAPI provou ser extremamente eficaz em contorná-los. Embora o encaminhamento de pedidos através da ScraperAPI seja muito mais lento do que, digamos, através de um servidor proxy gratuito."
Nota: este aumento de fiabilidade tem, por vezes, como contrapartida um tempo de resposta mais demorado do que um simples proxy clássico.

3. Renderização JavaScript
Graças a um navegador sem cabeça integrado, ScraperAPI pode extrair dados de sites dinâmicos cujo conteúdo é carregado através de JavaScript. Desta forma, obténs o HTML efetivamente apresentado, e não apenas o HTML simples enviado pelo servidor. Isto é essencial para fazer análise sintática fiável em páginas geradas do lado do cliente.
O regresso de Fazt Tech sobre Trustpilot :
"A ScraperAPI melhorou consideravelmente os nossos processos de recolha de dados da Web. A API é fácil de integrar e trata da maior parte do trabalho pesado, como a rotação de endereços IP e a gestão de proxy, poupando-nos tempo valioso. A gestão automática de captchas é uma grande vantagem e simplifica muito a nossa recolha de dados.

4. Personalizar as consultas
Podes personalizar as tuas pesquisas HTTP alterando os cabeçalhos, eles Biscoitos onde o user-agent. Isto ajuda a simular diferentes comportamentos e a evitar ser detetado nos sites mais rigorosos.
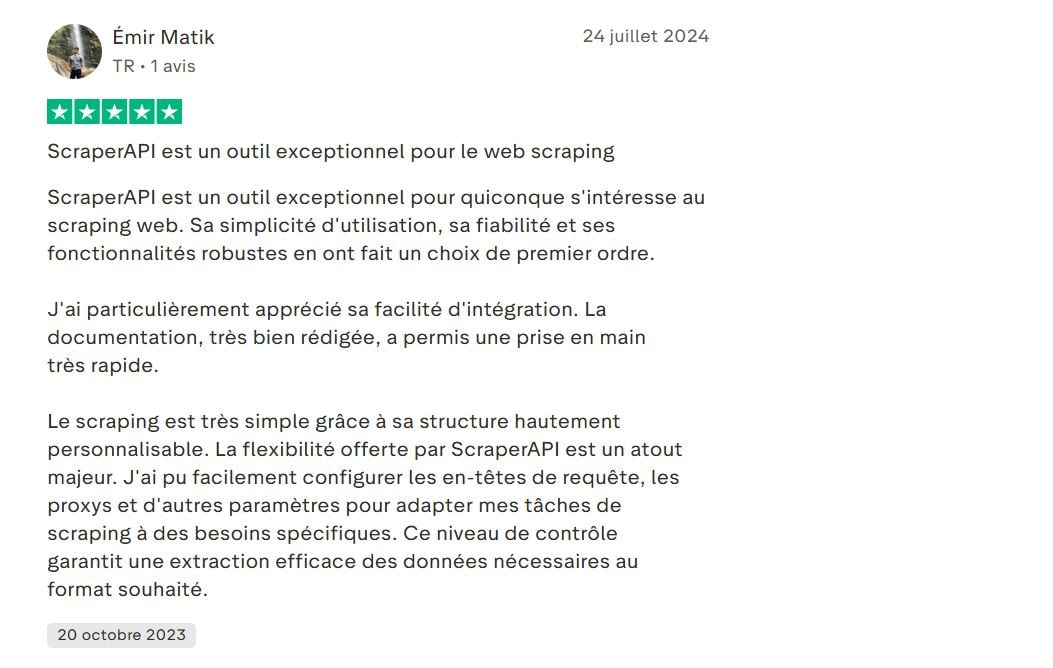
A opinião de Émir Matik sobre Trustpilot :
«…O scraping é muito simples graças à sua estrutura altamente personalizável. A flexibilidade oferecida pelo ScraperAPI é uma grande vantagem. Consegui configurar facilmente os cabeçalhos das requisições, os proxies e outros parâmetros para adaptar as minhas tarefas de scraping a necessidades específicas…»
5. Geolocalização de proxies
ScraperAPI deixa-te escolher o’localização geográfica dos servidores proxy, por país. Este segmentação geográfica é útil para recolher dados localizados ou testar resultados específicos de uma região, por exemplo, preços que variam consoante o mercado.
O regresso de Melih Krs sobre Trustpilot :
«…Além disso, o suporte que ofereceu à renderização em JavaScript e à geolocalização por IP foi inestimável…»

6. Painel de controlo e estatísticas
UMA painel de controlo completo depende da tua utilização, do número de pedidos, do taxa de sucesso e a créditos restantes. Desta forma, podes acompanhar de perto o teu consumo e ajustar o teu plano de acordo com a carga real.
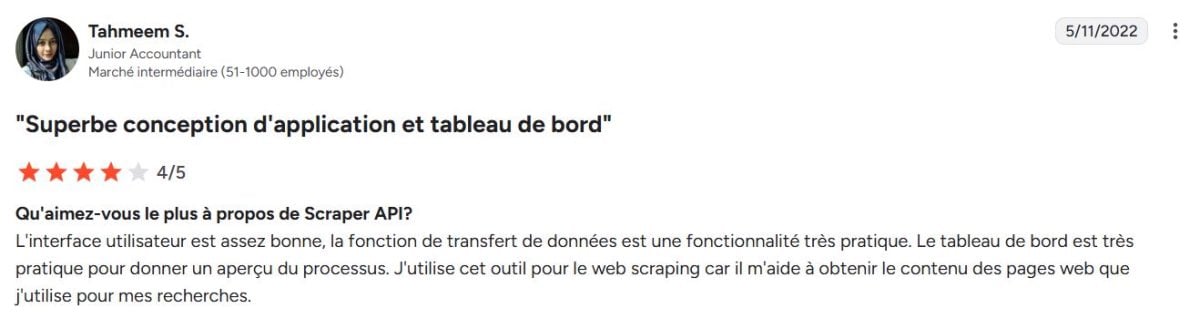
De acordo com Tahmeem S. sobre G2 :
"A interface do utilizador é bastante boa e a função de transferência de dados é uma caraterística muito prática. O painel de controlo é muito útil para dar uma visão geral do processo. Utilizo esta ferramenta para a recolha de dados da Web, uma vez que me ajuda a obter o conteúdo das páginas Web que utilizo para a minha investigação."
7. Integração e suporte multilingue
ScraperAPI proporciona uma API REST simples, fácil de integrar com a maioria das linguagens: Python, Node.js, PHP, Java, etc. Esta integração rápida facilita a sua adoção em diversos ambientes, desde um pequeno script até um projeto em produção.
O que diz Deni H. sobre G2 :
«A experiência necessária para a API Scraper é provavelmente a de um programador experiente em scraping na Web, com conhecimentos de várias tecnologias de scraping, incluindo Python (BeautifulSoup e Selenium), JavaScript (Puppeteer ou Cheerio) e Node.js (Demand e Cheerio)…»

8. Funcionalidades avançadas para dados
Para além do scraping clássico, ScraperAPI leva mais longe o tratamento de dados e a automatização em grande escala:
- Scraping assíncrono : envias milhões de pedidos em paralelo, o que é ideal para a recolha em muito grande escala em vários sites.
- Pontos de acesso a dados estruturados : no caso de alguns sites populares, os dados são devolvidos diretamente no formato JSON, prontas a utilizar sem necessidade de qualquer etapa adicional de análise sintática. Isto é particularmente útil tanto para projetos de lazer como para equipas de startups que pretendem avançar rapidamente.
ScraperAPI: as alternativas
ScraperAPI não é o único interveniente no mercado do raspagem da web. Existem várias alternativas que se distinguem pela sua abordagem, pelos seus preços ou pelas suas funcionalidades. Aqui estão as principais que deves conhecer antes de escolheres a tua ferramenta.
| Ferramenta | Características especiais | Comentários dos utilizadores | Pontuação média |
|---|---|---|---|
| API do raspador | Rotação automática de proxies, renderização JavaScript, personalização | Fiável e fácil de utilizar, mas por vezes pouco claro quanto aos preços | 4,5 |
| Dados brilhantes | Plataforma muito completa, com proxies premium e um pipeline de dados avançado | Muito poderoso e flexível, mas de utilização complexa | 4,6 |
| ScrapingBee | API simples com renderização JS e rotação de proxy | Fácil de integrar e com uma boa relação qualidade/preço, mas com menos opções avançadas | 4,9 |
| Octoparse | Visual scraping sem código, uma abordagem sem programação | Ideal para quem não tem conhecimentos técnicos, mas com limitações em grandes volumes | 4,4 |
| Apify | Plataforma para desenvolver scrapers personalizados | Muito flexível e personalizável, mas requer competências técnicas | 4,8 |
Na prática, cada solução destina-se a um perfil diferente. ScrapingBee continua a ser o concorrente mais próximo de ScraperAPI em cargas pequenas e médias. Octoparse dirige-se a quem não é programador e que pretende extrair dados sem escrever uma única linha de código. Apify, por sua vez, destina-se às equipas técnicas que desenvolvem os seus próprios scrapers.
Se tiveres necessidades em muito grande escala, com um conjunto de proxies premium e um pipeline de dados de envio, Bright Data vale a pena visitar.
É a solução mais potente do mercado, mas também a mais cara e a que demora mais tempo a dominar. Para a maioria dos casos de utilização, ScraperAPI mantém uma excelente relação qualidade/preço.
O Niklas resume bem esta posição em Capterra :
«O Bright Data é um serviço mais caro, mas o melhor da sua categoria.»

Perguntas frequentes
O ScraperAPI é gratuito?
Não, ScraperAPI é pago, mas, mesmo assim, apresenta uma proposta gratuito limitado, com um pequeno número de consultas para testar o serviço antes de escolher um plano.
Quanto custa o ScraperAPI?
Os preços começam em 49$/mês (Passatempo) e chegam até 1 975$/mês, com uma oferta Enterprise mediante orçamento para volumes muito elevados... O preço depende do plano escolhido, do volume de pedidos e opções ativadas, como a renderização em JavaScript ou a segmentação geográfica. Existem planos adequados tanto para projetos de passatempo como para startups em crescimento.
Cada consulta consome um número de créditos variáveis. Uma simples página em HTML O bruto consome poucos recursos, enquanto uma solicitação com proxy premium ou renderização em JavaScript consome muito mais.
É por isso que os créditos de um plano se esgotam rapidamente quando se faz scraping em sites complexos.
Como é que a ScraperAPI funciona?
ScraperAPI funciona como um intermediário entre a tua aplicação e os sites a rastrear. Ele gere automaticamente a rotação dos proxies, a gestão de IP, a execução de JavaScript e a contornagem das proteções.
Na prática, envias um pedido à API e obténs o conteúdo HTML da página de destino, sem te preocupares com bloqueios. A ferramenta baseia-se numa ampla conjunto de proxies distribuídos por vários países para recuperar os dados sem bloqueios.
Como é que utilizo a ScraperAPI com Python?
A integração com Python é simples graças a uma API REST bem documentada. Basta enviar um pedido HTTP para o endereço da API com a tua chave API e o URL de destino.
1. Define a URL da ScraperAPI com a tua chave API e a URL de destino
import requests

url = "http://api.scraperapi.com"
params = {
    'api_key': 'A SUA_CHAVE_API',
    'url': 'https://exemple.com'
}
2. Envia o pedido
response = requests.get(url, params=params)3. Apresenta o conteúdo da página recuperada
print(response.text)Depois, podes fazer análise de HTML com uma biblioteca como BeautifulSoup, ou explorar diretamente os pontos de acesso a dados estruturados, que enviam os dados em JSON pronto a usar.
A ScraperAPI pode contornar CAPTCHAs?
Sim. Um dos pontos fortes de ScraperAPI é a sua capacidade de contornar automaticamente os CAPTCHA e os outros sistemas anti-bot. É isso que explica o seu bom taxa de sucesso em muitos locais protegidos.
ScraperAPI fica uma solução eficaz para automatizar a recolha de dados online. Não hesites em colocar as tuas perguntas nos comentários e em partilhar a tua experiência!







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA