ScraperAPI cumple sus promesas en lo esencial: rotación automática de los servidores proxy, eludir las CAPTCHA y Representación de JavaScript. Envías una solicitud, recuperas los datos de una página web, sin tener que gestionar tú mismo los Direcciones IP bloqueadas.
Las opiniones son en su mayoría positivas, con una puntuación de 4/5 en Trustpilot y muy buenas opiniones sobre G2 y Capterra. Esta API de web scraping es adecuada tanto para un proyecto personal como para una empresa. Los únicos inconvenientes reales tienen que ver con la tarificación y los scrapings a muy a gran escala.
A continuación se ofrece un resumen de los puntos fuertes y los puntos débiles de ScraperAPI Según los comentarios de los usuarios:
| Destacados | Puntos débiles |
|---|---|
| Cómo sortear eficazmente los CAPTCHA | Precios poco claros |
| Gestión automática y eficaz de los proxies | Restricciones ocasionales de caudal y solicitudes |
| Procesamiento fiable de JavaScript | No apto para volúmenes muy grandes |
| Compatibilidad con múltiples lenguajes (Python, Node.js, PHP…) | Se podría mejorar la documentación avanzada |
| Fácil integración y API sencilla |
Opinión global sobre ScraperAPI
Los usuarios resumen ScraperAPI En tres palabras: rápido, fiable, eficaz.
Según las opiniones recopiladas en Trustpilot, G2 y Capterra, la nota media ronda los 4,3/5. Estas notas suelen cambiar, así que no te olvides de comprobarlas cuando hagas el check-in.
| Plataforma | Puntuación sobre 5 |
|---|---|
| Trustpilot | 4 (basado en unas 42 opiniones) |
| G2 | 4,4 |
| Capterra | 4,6 (nota del servicio de atención al cliente) |
Los puntos fuertes que más se mencionan en las opiniones:
- Fiabilidad y eficacia del raspado, incluso en sitios web complejos.
- Facilidad de integración : basta con una simple clave API para empezar.
- Atención al cliente reactivo y con buenas notas.
- Bueno relación calidad-precio para un uso habitual.
- Funciones avanzadas como la rotación de IP y el renderizado JavaScript.
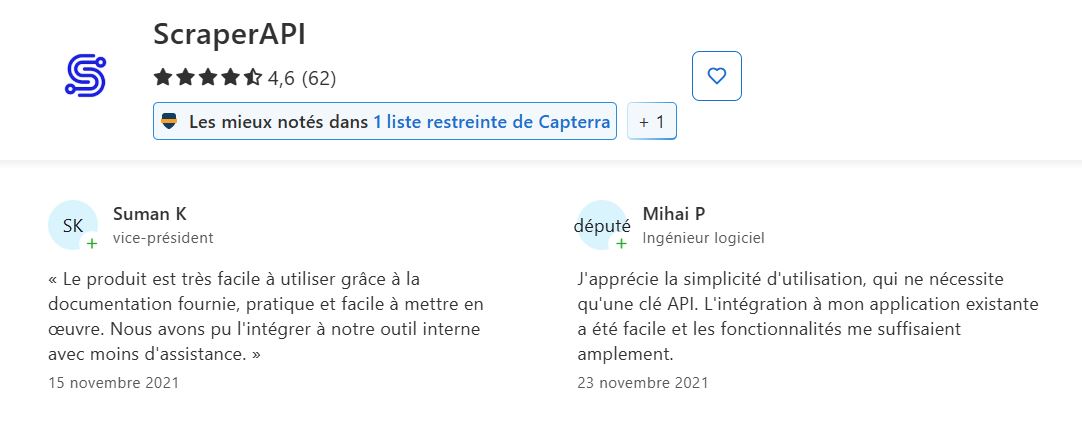
De acuerdo a Suman K y Mihai P seguro Capterra :
“El producto es muy fácil de usar gracias a la documentación proporcionada, práctica y fácil de implementar...”.”
“Me gusta lo fácil que es de usar, solo necesitas una clave API. Fue fácil integrarlo en mi aplicación y las funciones me parecieron más que suficientes”.”
Akif confirma en Trustpilot :
“Su servicio de atención al cliente es excelente...”

Muhammad H. seguro G2 destaca el ahorro de tiempo a la hora de resolver problemas técnicos:
“Simplifica el web scraping al gestionar los proxies, los CAPTCHAs y la representación del navegador, lo que me permite centrarme en la extracción de datos en lugar de en los problemas técnicos. La API se integra perfectamente en mi código existente y la velocidad es impresionante, incluso para proyectos a gran escala”.”

En cuanto a los defectos, los usuarios señalan sobre todo lo siguiente:
- Transparencia en la fijación de precios : el sistema de créditos, con sus multiplicadores según el tipo de solicitud, a veces deja a la gente perpleja.
- Documentación que hay que profundizar en ellas para las funciones más avanzadas.
- Algunos errores en las consultas o limitaciones de caudal ocasionales.
- UN apoyo se considera desigual según los casos.
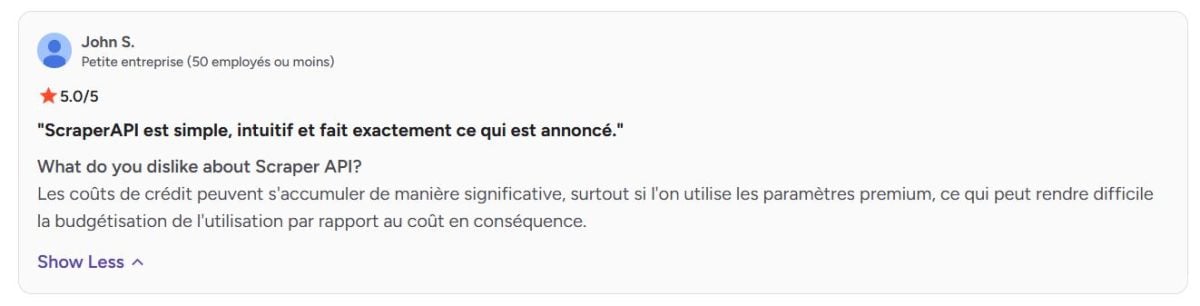
De acuerdo a John S. seguro G2, el importe de la factura aumenta rápidamente en cuanto activas las opciones premium:
“Los costes de crédito pueden acumularse de forma significativa, especialmente si se utilizan los parámetros premium, lo que puede dificultar la presupuestación del uso en relación con el coste correspondiente”.”
Opinión sobre los servicios ofrecidos por ScraperAPI
A continuación se detallan los servicios principales de ScraperAPI y lo que los usuarios realmente recuerdan, servicio por servicio.
1. Rotación automática de proxies
ScraperAPI se basa en un amplio conjunto de proxies que gira automáticamente con cada consulta. Esta rotación de IP Reduce considerablemente los bloqueos cuando realizas llamadas consecutivas a un mismo sitio web.
El regreso de Aditya Pratap Singh seguro Trustpilot :
“ScraperAPI ha revolucionado mis proyectos de web scraping. Antes de descubrir este servicio, tenía que lidiar constantemente con CAPTCHAs y bloqueos de direcciones IP. Ahora puedo centrarme en utilizar los datos en lugar de luchar por conseguirlos. La rotación del proxy es fluida y me gusta la gestión automática del renderizado de JavaScript”.”

2. Gestión de la protección de derivación
La herramienta sabe eludir las mecanismos contra los bots sistemas complejos, los cortafuegos y los CAPTCHA. Resultado: una extracción de datos más fluida, incluso en sitios web muy protegidos como Google.
Según Arun K., investigador asociado:
“Google ha logrado bloquear las solicitudes programáticas, incluso con fines no comerciales y de autoarchivo, y ScraperAPI ha demostrado ser extremadamente eficaz para eludirlas. Sin embargo, el enrutamiento de solicitudes a través de ScraperAPI es mucho más lento que, por ejemplo, a través de un servidor proxy gratuito”.”
Nota: esta mayor fiabilidad a veces tiene como contrapartida un tiempo de respuesta más largo que un simple proxy convencional.

3. Representación en JavaScript
Gracias a un navegador sin cabeza integrado, ScraperAPI puede extraer datos de sitios web dinámicos cuyo contenido se carga a través de JavaScript. De este modo, recuperas el HTML realmente mostrado, y no solo el HTML plano enviado por el servidor. Es fundamental para hacer análisis sintáctico fiable en páginas generadas del lado del cliente.
El regreso de Fazt Tech seguro Trustpilot :
“ScraperAPI ha mejorado considerablemente nuestros procesos de scraping web. La API es fácil de integrar y se encarga de la mayoría de las tareas pesadas, como la rotación de direcciones IP y la gestión de proxys, lo que nos ahorra un tiempo muy valioso. La gestión automática de captchas es una gran ventaja y simplifica considerablemente nuestra recopilación de datos”.”

4. Personalización de las consultas
Puedes personalizar tus consultas HTTP modificando los encabezados, la Galletas donde el user-agent. Esto ayuda a simular diferentes comportamientos y a evitar ser detectado en los sitios web más estrictos.
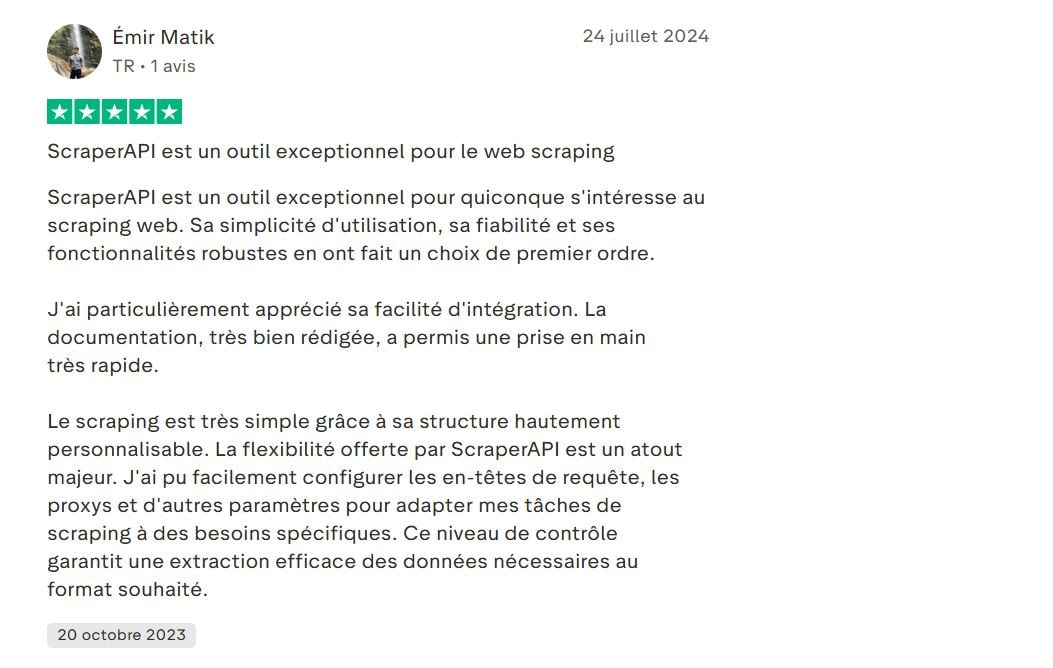
La opinión de Émir Matik seguro Trustpilot :
“…El scraping es muy sencillo gracias a su estructura altamente personalizable. La flexibilidad que ofrece ScraperAPI es una gran ventaja. He podido configurar fácilmente los encabezados de las solicitudes, los proxies y otros parámetros para adaptar mis tareas de scraping a necesidades específicas…”
5. Geolocalización de los proxies
ScraperAPI te deja elegir el’ubicación geográfica de los servidores proxy, por países. Este segmentación geográfica resulta útil para recuperar datos localizados o comprobar resultados específicos de una región, como, por ejemplo, los precios que varían según el mercado.
El regreso de Melih Krs seguro Trustpilot :
“…Además, su gestión de la ejecución de JavaScript y de la geolocalización por IP ha sido de gran ayuda…”

6. Cuadro de mandos y estadísticas
UN cuadro de mando integral depende de tu uso, del número de consultas, del porcentaje de éxito y los créditos restantes. De este modo, puedes llevar un control claro de tu consumo y ajustar tu plan en función de la carga real.
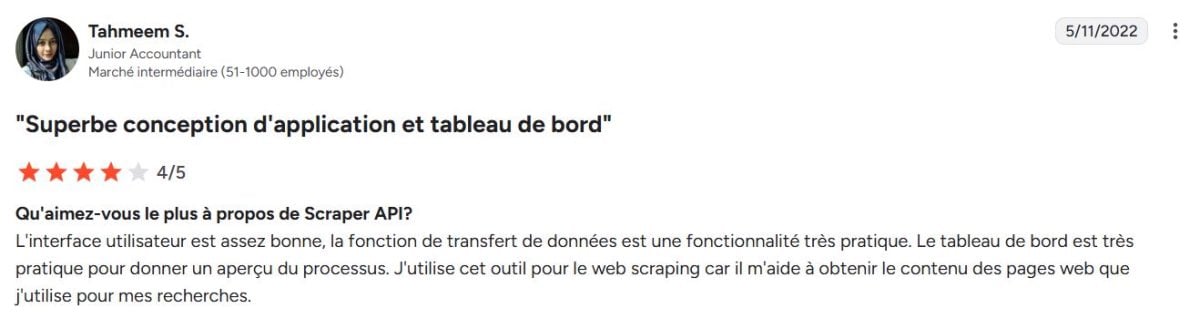
De acuerdo a Tahmeem S. seguro G2 :
“La interfaz de usuario es bastante buena, la función de transferencia de datos es muy práctica. El panel de control es muy útil para obtener una visión general del proceso. Utilizo esta herramienta para el web scraping porque me ayuda a obtener el contenido de las páginas web que utilizo para mis investigaciones”.”
7. Integración y soporte multilingüe
ScraperAPI ofrece una API REST sencillo, fácil de integrar con la mayoría de los lenguajes: Python, Node.js, PHP, Java, etc. Esta rápida integración facilita su adopción en diversos entornos, desde un pequeño script hasta un proyecto en producción.
Lo que dice Deni H. seguro G2 :
“La experiencia requerida para la API Scraper es probablemente la de un desarrollador con experiencia en scraping web y conocimientos de diversas tecnologías de scraping, incluyendo Python (BeautifulSoup y Selenium), JavaScript (Puppeteer o Cheerio) y Node.js (Demand y Cheerio)…”

8. Funciones avanzadas para datos
Más allá del scraping clásico, ScraperAPI lleva más allá el tratamiento de datos y la automatización a gran escala:
- Scraping asíncrono : envías millones de solicitudes en paralelo, lo que resulta ideal para la recopilación de datos a gran escala en numerosos sitios web.
- Puntos finales de datos estructurados : en el caso de algunas páginas web populares, los datos se envían directamente en formato JSON, listas para usar sin necesidad de un proceso de análisis sintáctico adicional. Esto resulta especialmente útil tanto para proyectos de aficionado como para equipos de startups que quieren avanzar rápido.
ScraperAPI: las alternativas
ScraperAPI no es el único actor en el mercado de raspado web. Existen varias alternativas que se diferencian por su enfoque, sus tarifas o sus funcionalidades. Estas son las principales que debes conocer antes de elegir tu herramienta.
| Herramienta | Características especiales | Opiniones de usuarios | Puntuación media |
|---|---|---|---|
| ScraperAPI | Rotación automática de proxies, renderizado JavaScript, personalización | Fiable y fácil de usar, pero a veces confuso en cuanto a los precios. | 4,5 |
| Datos brillantes | Una plataforma muy completa, con proxies premium y un proceso de tratamiento de datos avanzado | Muy potente y flexible, pero complejo de usar | 4,6 |
| ScrapingBee | API sencilla con renderizado JS y rotación de proxy | Fácil de integrar y buena relación calidad-precio, pero menos opciones avanzadas. | 4,9 |
| Octoparse | Scraping visual sin código, un enfoque sin programación | Ideal para quienes no tienen conocimientos técnicos, pero con limitaciones en grandes volúmenes | 4,4 |
| Apify | Plataforma de desarrollo de rascadores personalizados | Muy flexible y personalizable, pero requiere conocimientos técnicos | 4,8 |
En concreto, cada solución está dirigida a un perfil diferente. ScrapingBee sigue siendo el competidor más cercano de ScraperAPI en cargas pequeñas y medianas. Octoparse se dirige a personas que no son desarrolladores y que quieren extraer datos sin escribir ni una línea de código. Apify, por su parte, está dirigido a los equipos técnicos que crean sus propios scrapers.
Si tienes necesidades a muy gran escala, con un conjunto de proxies premium y un canal de datos de envío, Bright Data merece la pena echarle un vistazo. Es la solución más potente del mercado, pero también la más cara y la que más tiempo lleva dominar. Para la mayoría de los casos de uso, ScraperAPI mantiene una excelente relación calidad-precio.
Niklas resume muy bien esta postura en Capterra :
“Bright Data es un servicio más caro, pero el mejor de su categoría”.”

preguntas frecuentes
¿Es gratis ScraperAPI?
No, ScraperAPI es de pago. Aun así, ofrece un prueba gratuita limitado, con un pequeño saldo de solicitudes para probar el servicio antes de elegir un plan.
¿Cuánto cuesta ScraperAPI?
Tarifas para ScraperAPI suelen oscilar entre 49$ a 475$ al mes. El precio depende del plan elegido, del volumen de consultas y opciones activadas como el renderizado en JavaScript o la segmentación geográfica. Hay planes adaptados tanto a proyectos de aficionado como a startups en crecimiento.
Cada consulta consume un número de créditos variables. Una simple página en HTML El scraping básico consume pocos recursos, mientras que una solicitud con un proxy premium o con renderizado en JavaScript consume muchos más. Por eso, los créditos de un plan se agotan rápidamente cuando se realiza scraping en sitios web complejos.
¿Cómo funciona ScraperAPI?
ScraperAPI actúa como un intermedio entre tu aplicación y las páginas web que se van a rastrear. Gestiona automáticamente la rotación de los servidores proxy, la gestión de direcciones IP, la ejecución de JavaScript y la elusión de las medidas de seguridad.
En concreto, envías una solicitud a la API y recuperas el contenido HTML de la página de destino, sin preocuparte por los bloqueos. La herramienta se basa en una amplia conjunto de servidores proxy repartidos por numerosos países para recuperar los datos sin problemas.
¿Cómo se utiliza ScraperAPI con Python?
La integración con Python es sencillo gracias a una API REST bien documentada. Solo tienes que enviar una solicitud HTTP a la dirección de la API con tu clave API y la URL de destino.
1. Configura la URL de ScraperAPI con tu clave API y la URL de destino
importar solicitudes

url = "http://api.scraperapi.com"
params = {
    'api_key': 'TU_CLAVE_API',
    'url': 'https://exemple.com'
}
2. Envía la solicitud
response = requests.get(url, params=parámetros)3. Muestra el contenido de la página recuperada
print(respuesta.texto)Después puedes hacer análisis sintáctico de HTML con una biblioteca como BeautifulSoup, o aprovechar directamente los puntos finales de datos estructurados, que devuelven los datos en JSON listo para usar.
¿Puede ScraperAPI saltarse los CAPTCHA?
Sí. Uno de los puntos fuertes de ScraperAPI es su capacidad para sortear automáticamente los CAPTCHA y los demás sistemas antibots. Eso es lo que explica su buen porcentaje de éxito en muchos espacios protegidos.
ScraperAPI sigue siendo una solución eficaz para automatizar la recopilación de datos en línea. ¡No dudes en plantear tus preguntas en los comentarios y compartir tu experiencia!








 Español