ScraperAPI 重要な点については約束を果たしている: プロキシの自動ローテーション, 回避 CAPTCHA と JavaScriptレンダリング. リクエストを送信し、ウェブサイトからデータを取得しますが、その処理を自分で管理する必要はありません。 ブロックされたIPアドレス.
レビューの多くは肯定的なもので、その割合は Trustpilotでの評価は4.5/5 そして、以下について非常に好評を博しており G2 と カプタラ. このウェブスクレイピングAPIは、個人プロジェクトにも企業にも適しています。.
唯一の本当の難点は、 価格設定 そして、非常に 大規模.
以下に、の長所と短所をまとめたものです。 ScraperAPI ユーザーからのフィードバックによると:
| ハイライト | ❌ 弱点 |
|---|---|
| CAPTCHAを効果的に回避する | 不透明な価格設定 |
| プロキシの自動的かつ効率的な管理 | スループットやリクエストに制限がかかることがある |
| 信頼性の高いJavaScriptレンダリング | 大容量には不向き |
| 多言語対応(Python、Node.js、PHPなど) | 高度なドキュメントは改善される可能性がある |
| 簡単な統合とシンプルなAPI |
ScraperAPIに関するグローバルな意見
ユーザーからのまとめ ScraperAPI 一言で言えば: 速い, 信頼できる, 効果的.
で集められた口コミによると Trustpilot, G2 と Capterra, 、平均点はおよそ 4,5/5. これらのメモは頻繁に変更されることがあるので、チェックする際に確認するようにしてください。.
| プラットホーム | 5点満点 |
|---|---|
| トラストパイロット | 4,5(約42件のレビューに基づく) |
| G2 | 4,3/5 |
| カプタラ | 4,6/5 (カスタマーサービス注記) |
レビューで最も頻繁に挙げられている強みは以下の通りです:
- スクレイピングの信頼性と効率性, 、複雑なサイトであっても。.
- 統合の容易さ : 開始するには、APIキー1つあれば十分です。.
- カスタマーサポート 対応が迅速で、評価も高い。.
- 良い コストパフォーマンス 日常的な使用に。.
- 高度な機能性 IPのローテーションやレンダリングなど JavaScript.
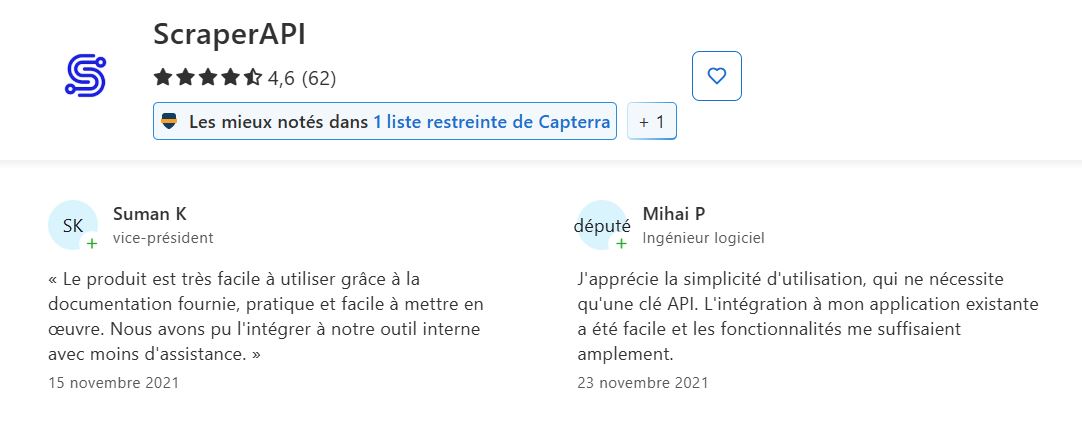
によると スーマンK と ミハイ・P の上 Capterra :
"提供されたドキュメントのおかげで製品は非常に使いやすく、実用的で導入しやすい..."
"APIキーだけで使える手軽さが気に入っています。既存のアプリケーションとの統合も簡単で、機能も十分すぎるほどでした。"
アキフ で確認する Trustpilot :
"彼らのカスタマーサービスは素晴らしい..."

ムハンマド・H の上 G2 技術的な問題が発生した際の時間短縮を強調している:
「プロキシ、CAPTCHA、ブラウザのレンダリングを管理することで、ウェブスクレイピングを簡素化し、技術的な問題よりもデータ抽出に集中できるようになりました。APIは私の既存のコードにシームレスに統合され、そのスピードは大規模なプロジェクトでも印象的です。"

欠点としては、ユーザーから主に次のような点が指摘されています:
- 料金体系の透明性 :リクエストの種類に応じて乗数が適用されるクレジット制度は、時に人々を困惑させることがあります。.
- ドキュメンテーション より高度な機能については、さらに詳しく検討する必要があります。.
- リクエストの失敗がいくつかあったり、 流量制限 臨時従業員。.
- A サポート ケースによって不公平であると判断された。.
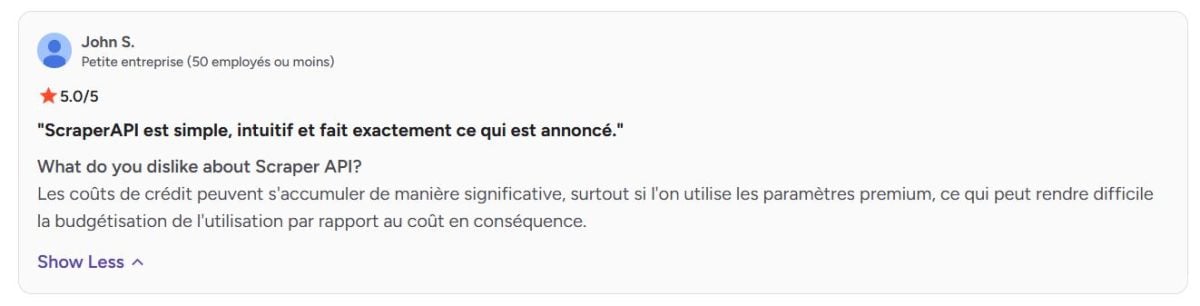
によると ジョン・S. の上 G2, プレミアムオプションを有効にすると、クレジットの消費が急速に増えます:
"クレジットのコストは、特にプレミアム設定が使用されている場合、大きく膨らむ可能性があり、その結果、使用量とコストの予算を立てるのが難しくなる"
ScraperAPIのサービスに対するご意見
以下は、の主要サービスの詳細です。 ScraperAPI そして、サービスごとに、ユーザーが実際に何を記憶しているか。.
1.プロキシの自動ローテーション
ScraperAPI 広範な プロキシプール 各リクエストごとに自動的に回転させる。この IPのローテーション 同じサイトへのリクエストを連続して送信する際、応答の遅延を大幅に軽減します。.
の復活 Aditya Pratap Singh の上 Trustpilot :
「ScraperAPIは、私のウェブスクレイピングプロジェクトに革命を起こしてくれました。このサービスを見つけるまでは、CAPTCHAやIPアドレスブロックと常に格闘していました。今は、データのために戦うのではなく、データを使うことに集中できます。プロキシのローテーションもスムーズで、JavaScriptレンダリングの自動処理にも感謝しています"

2.バイパス保護管理
このツールは、以下の制限を回避することができます。 ボット対策機能 複合システム、ファイアウォール、および CAPTCHA. その結果、次のような厳重に保護されたサイトであっても、データ抽出がよりスムーズに行えるようになりました。 Google.
によると Arun K., 、客員研究員:
"グーグルは、非商業的かつ自己アーカイブ目的であっても、プログラムによるリクエストをブロックすることに成功しており、ScraperAPIはそれらを回避するのに非常に効果的であることが証明されている。ScraperAPIを経由したリクエストのルーティングは、例えば無料のプロキシサーバーを経由するよりもはるかに遅いですが。"
注:この信頼性の向上には、場合によっては 応答時間 単なる従来のプロキシよりも長い。.

3.JavaScriptレンダリング
そのおかげだ。 ヘッドレスブラウザ 統合型、, ScraperAPI 以下の方法でコンテンツが読み込まれる動的なサイトからデータを抽出できます JavaScript. これで、 実際に表示されたHTML, 、そして単に プレーンHTML サーバーから返される。これは、~を行うために不可欠である。 解析 クライアントサイドで生成されたページにおいても信頼性が高い。.
の復活 Fazt Tech の上 Trustpilot :
「ScraperAPIは、我々のウェブスクレイピングプロセスを大幅に改善しました。APIは統合が簡単で、IPアドレスのローテーションやプロキシ管理などの重労働のほとんどを引き受けてくれるので、貴重な時間を節約できます。キャプチャの自動管理は大きな資産で、データ収集を大幅に簡素化してくれます。

4.クエリのカスタマイズ
検索条件をカスタマイズできます HTTP を修正して ヘッダー、 彼ら クッキー どこ user-agent. これにより、さまざまな行動をシミュレートし、規制が最も厳しいサイトでの検知を回避することができます。.
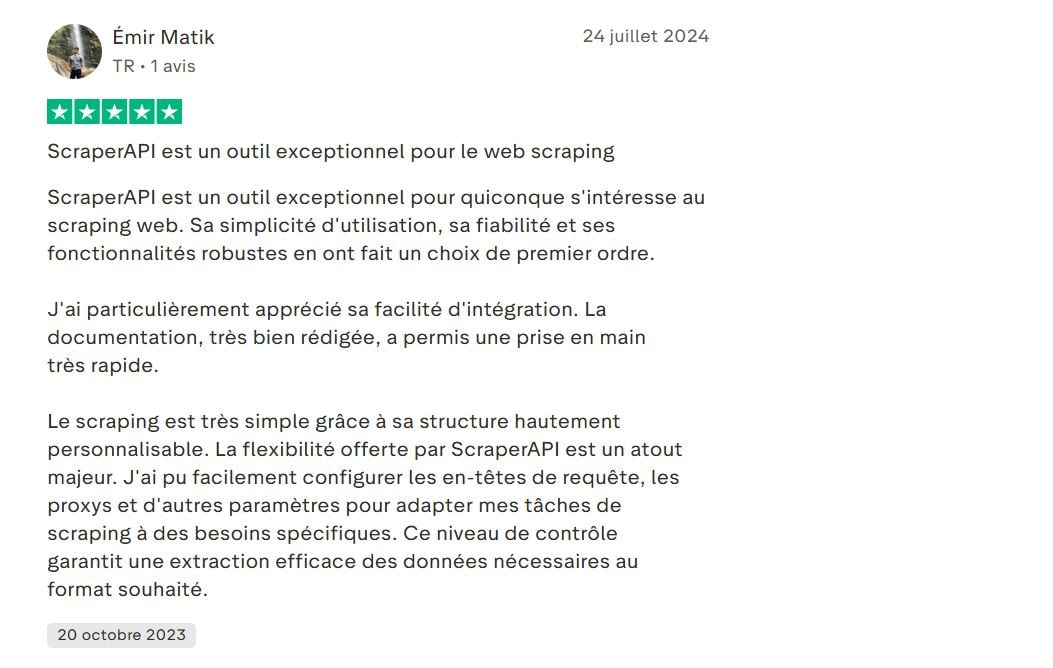
の意見 Émir Matik の上 Trustpilot :
«「…その高度にカスタマイズ可能な構造のおかげで、スクレイピングは非常に簡単です。ScraperAPIが提供する柔軟性は大きな強みです。リクエストヘッダーやプロキシ、その他のパラメータを簡単に設定し、特定のニーズに合わせてスクレイピングタスクを調整することができました…」»
5.プロキシのジオロケーション
ScraperAPI ~を選べるようにする’プロキシの地理的位置, 、国別。この ジオターゲティング 地域別のデータを取得したり、市場によって変動する価格など、特定の地域に固有の結果を検証したりするのに役立ちます。.
の復活 Melih Krs の上 Trustpilot :
«「…さらに、JavaScriptのレンダリングやIPによる位置情報取得への対応も大変役立ちました…」»

6.ダッシュボードと統計
A 包括的なダッシュボード 利用状況、リクエスト数、 成功率 そしてその 残りのクレジット. そうすることで、消費量を明確に把握し、実際の負荷に応じて計画を調整することができます。.
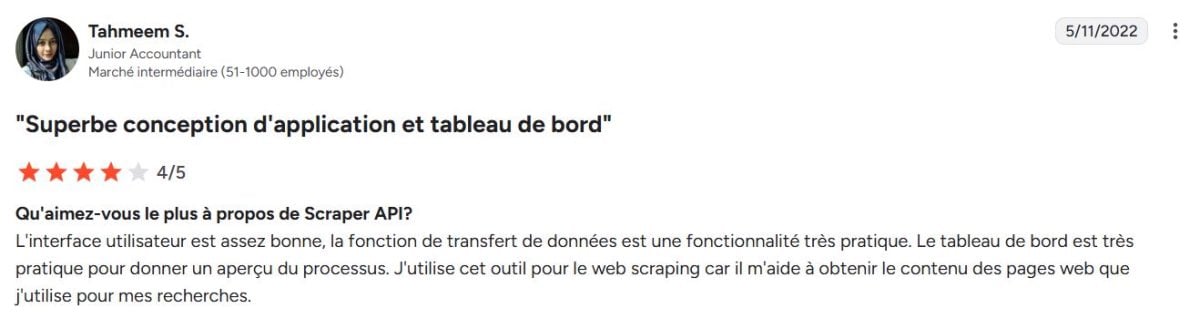
によると Tahmeem S. の上 G2 :
「ユーザー・インターフェースは非常に優れており、データ転送機能は非常に実用的な機能です。ダッシュボードはプロセスの概要を把握するのにとても便利です。研究に使うウェブページの内容を取得するのに役立つので、ウェブスクレイピングにこのツールを使っています。"
7.統合と多言語サポート
ScraperAPI 提案する REST API シンプルで、ほとんどのプログラミング言語と簡単に統合できます: Python, Node.js, PHP, Java, 、など。この迅速な統合により、小さなスクリプトから本番環境のプロジェクトに至るまで、さまざまな環境での導入が容易になります。.
次のように述べている Deni H. の上 G2 :
«「API Scraperのユーザーは、おそらくウェブスクレイピングの経験が豊富で、Python(BeautifulSoupやSelenium)、 JavaScript(PuppeteerやCheerio)、Node.js(DemandやCheerio)など、さまざまなスクレイピング技術に関する知識を持つ、ウェブスクレイピングに精通した開発者の経験に近いでしょう……」»

8.データのための高度な機能
従来のスクレイピングを超えて、, ScraperAPI データ処理と大規模な自動化をさらに推進します:
- 非同期スクレイピング : 数百万件のリクエストを並行して送信するため、多数のサイトを対象とした超大規模なデータ収集に最適です。.
- 構造化データのエンドポイント : 一部の人気サイトでは、データが直接以下の形式で返されます JSON, 、追加のパーシング処理を必要とせず、すぐに利用可能です。これは、趣味のプロジェクトはもちろん、迅速な開発を目指すスタートアップのチームにとっても特に役立ちます。.
ScraperAPI:代替手段
ScraperAPI この市場における唯一のプレイヤーではない ウェブスクレイピング. 各ツールは、アプローチや料金体系、機能面でそれぞれ特徴が異なります。ツールを選ぶ前に知っておくべき主なものを以下に紹介します。.
| 道具 | 特集 | ユーザーレビュー | 平均点 |
|---|---|---|---|
| スクレイパーAPI | プロキシの自動ローテーション、JavaScriptレンダリング、カスタマイズ | 信頼性が高く使いやすいが、価格設定がわかりにくいことがある | 4,5 |
| ブライトデータ | プレミアムプロキシや高度なデータパイプラインを備えた、非常に充実したプラットフォーム | 非常に強力で柔軟だが、使いこなすのは複雑 | 4,6 |
| スクレイピング・ビー | JSレンダリングとプロキシローテーションによるシンプルなAPI | 統合が容易でコストパフォーマンスは高いが、高度なオプションは少ない | 4,9 |
| オクトパース | コードを使わないビジュアル・スクレイピング、プログラミング不要のアプローチ | 技術に詳しくない人にとっては理想的だが、大量処理には向かない | 4,4 |
| アピファイ | カスタムスクレーパー開発用プラットフォーム | 非常に柔軟性が高く、カスタマイズも可能ですが、技術的なスキルが必要です | 4,8 |
具体的には、各ソリューションはそれぞれ異なるターゲット層を対象としています。. ScrapingBee 依然として、~に最も近い競合相手である ScraperAPI 中小規模の荷物について。. Octoparse コードを1行も書かずにデータを抽出したい、開発者ではない人に向けて説明しています。. Apify, こちらは、独自のスクレイパーを構築する技術チームを対象としています。.
もし、非常に大規模なニーズがあり、かつ プレミアムプロキシのプール そして、プッシュ型のデータパイプライン、, Bright Data 立ち寄る価値がある。.
これは市場で最も強力なソリューションですが、同時に最も高価で、使いこなせるようになるまでにも最も時間がかかります。ほとんどのユースケースにおいては、, ScraperAPI コストパフォーマンスは依然として非常に優れています。.
ニクラスは、この立場について次のようにうまく要約している。 Capterra :
«「Bright Dataは料金は高めですが、この分野では最高のサービスです。」»

よくある質問
ScraperAPIは無料ですか?
いや、 ScraperAPI 有料です、, とはいえ、それでも彼は提案をしてくる 無料 制限付きで、プランを選択する前にサービスを試用できる少量のクエリクレジットが付与されます。.
ScraperAPIの価格はいくらですか?
料金は~から 49$/月 (趣味) で、最大 1 975$/月, 、また、非常に大量の注文については、見積もりに基づくエンタープライズプランもご用意しています。価格は選択したプランや、 クエリ数 また、JavaScriptレンダリングやジオターゲティングなどの有効化されたオプションも含まれます。趣味のプロジェクトから成長中のスタートアップまで、それぞれのニーズに合わせたプランが用意されています。.
各クエリは、一定数の 変動クレジット. 単なるページが HTML rawは消費量が少ないのに対し、プレミアムプロキシやJavaScriptレンダリングを使用したリクエストは、はるかに多くのリソースを消費します。.
だからこそ、複雑なサイトをスクレイピングすると、プランのクレジットがすぐに使い切れてしまうんだ。.
ScraperAPIはどのように機能するのですか?
ScraperAPI ~のような役割を果たす 中間 アプリケーションとスクレイピング対象のウェブサイトとの間で。自動的に プロキシのローテーション, 、IP管理、JavaScriptのレンダリング、および保護機能の回避。.
具体的には、APIにリクエストを送信して、コンテンツを取得します HTML 対象ページを、ブロックを気にすることなく閲覧できます。このツールは、幅広い 多くの国に分散したプロキシのプール データをブロックされずに取得するために。.
PythonでScraperAPIを使うには?
との連携 Python のおかげで簡単です ドキュメントが充実したREST API. APIのアドレスに、以下の内容を含むHTTPリクエストを送信するだけで済みます。 APIキー およびリンク先のURL。.
1. 自分のAPIキーとターゲットURLを使用して、ScraperAPIのURLを設定してください
import requests

url = "http://api.scraperapi.com"
params = {
    'api_key': 'TA_CLE_API',
    'url': 'https://exemple.com'
}
2. リクエストを送信する
response = requests.get(url, params=params)3. 取得したページの内容を表示する
print(response.text)その後、次のことを行うことができます HTMLの解析 次のようなライブラリを使って BeautifulSoup, 、あるいは直接 構造化データのエンドポイント, これらはデータを JSON すぐに使える。.
ScraperAPIはCAPTCHAを回避できますか?
はい。 の特長の一つは ScraperAPI その能力とは、自動的に CAPTCHA およびその他のボット対策システム。これが、その優れた 成功率 多くの保護地域において。.
ScraperAPI 依然として 高性能なソリューション オンラインでのデータ収集を自動化するためです。コメント欄で質問や体験談をぜひお寄せください!







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA