ScraperAPI hält seine Versprechen in den wesentlichen Punkten ein: automatische Proxy-Rotation, Umgehung der CAPTCHA und JavaScript-Rendering. Du sendest eine Anfrage, rufst die Daten einer Website ab, ohne dich selbst um die Gesperrte IP-Adressen.
Die Bewertungen sind überwiegend positiv, mit einer Bewertung von 4,5/5 auf Trustpilot und sehr gutes Feedback zu G2 und Capterra. Diese Web-Scraping-API eignet sich sowohl für private Projekte als auch für Unternehmen.
Die einzigen wirklichen Nachteile betreffen die Preisgestaltung und die Scrapings mit sehr großer Maßstab.
Hier eine Zusammenfassung der Stärken und Schwächen von ScraperAPI laut Rückmeldungen der Nutzer:
| ✅ Stärken | ❌ Schwächen |
|---|---|
| Effektive Umgehung von CAPTCHAs | Unklare Preisgestaltung |
| Automatische und effiziente Verwaltung von Proxys | Gelegentliche Einschränkungen von Datenübertragungen und Abfragen |
| Zuverlässiges JavaScript-Rendering | Wenig geeignet für sehr große Mengen |
| Unterstützung mehrerer Programmiersprachen (Python, Node.js, PHP…) | Verbesserungswürdige erweiterte Dokumentation |
| Einfache Integration und benutzerfreundliche API |
Allgemeine Meinung zu ScraperAPI
Die Nutzer fassen zusammen ScraperAPI In drei Worten: schnell, zuverlässig, Wirksam.
Laut den Bewertungen, die auf Trustpilot, G2 und Capterra, die Durchschnittsnote liegt bei etwa 4,5/5. Diese Notizen ändern sich oft, denk daran, sie bei deinem Check zu überprüfen.
| Plattform | Note von 5 |
|---|---|
| Trustpilot | 4,5(basierend auf ca. 42 Bewertungen) |
| G2 | 4,3/5 |
| Capterra | 4,6/5 (Anmerkung des Kundendienstes) |
Die Stärken, die in den Bewertungen am häufigsten genannt werden:
- Zuverlässigkeit und Effektivität des Scrapings, selbst an komplexen Standorten.
- Einfache Integration : Ein einfacher API-Schlüssel reicht aus, um loszulegen.
- Kunden-Support reaktionsschnell und gut bewertet.
- Gut Preis-Leistungs-Verhältnis für den regelmäßigen Gebrauch.
- Erweiterte Funktionen wie die Drehung von IP und das Rendering JavaScript.
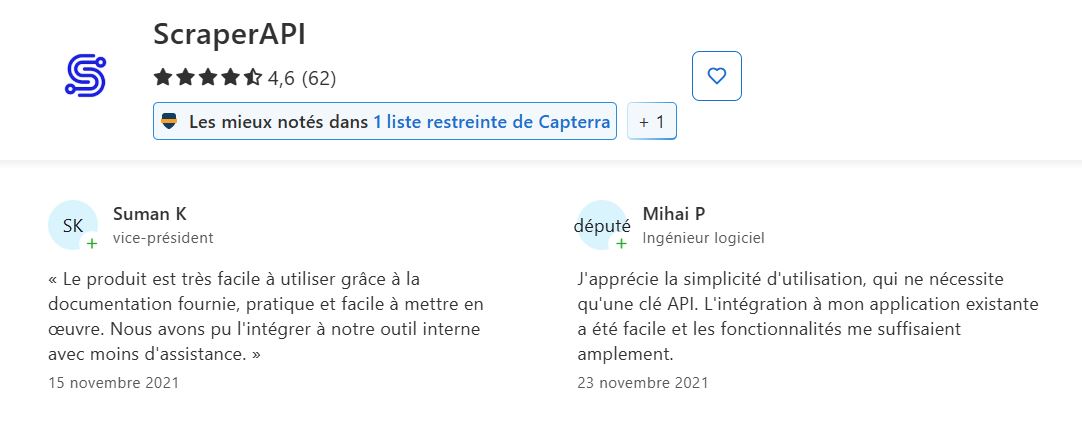
Nach Suman K und Mihai P an Capterra :
"Das Produkt ist dank der mitgelieferten Dokumentation sehr benutzerfreundlich, praktisch und einfach zu implementieren...".
"Ich schätze die einfache Bedienung, für die man nur einen API-Schlüssel benötigt. Die Integration in meine bestehende Anwendung war einfach und die Funktionen haben mir völlig ausgereicht."
Akif bestätigt auf Trustpilot :
" Ihr Kundenservice ist hervorragend ... "

Muhammad H. an G2 betont die Zeitersparnis bei technischen Problemen:
"Es vereinfacht das Webscraping, indem es die Verwaltung von Proxys, CAPTCHAs und Browser-Rendering übernimmt, sodass ich mich auf die Datenextraktion konzentrieren kann, anstatt mich mit technischen Problemen herumzuschlagen. Die API fügt sich nahtlos in meinen bestehenden Code ein, und die Geschwindigkeit ist beeindruckend, selbst bei großen Projekten."

Was die Mängel angeht, heben die Nutzer vor allem Folgendes hervor:
- Transparenz bei der Preisgestaltung : Das Punktesystem mit seinen je nach Art der Anfrage unterschiedlichen Multiplikatoren sorgt manchmal für Verwirrung.
- Dokumentation Für die fortgeschrittensten Funktionen sind weitere Kenntnisse erforderlich.
- Einige fehlgeschlagene Abfragen oder Durchflussbegrenzungen Gelegenheitsarbeiter.
- EIN Unterstützung je nach Fall als ungleich befunden.
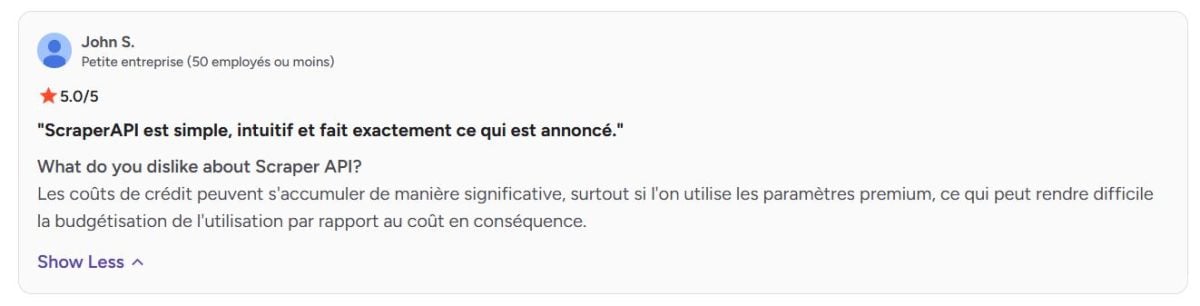
Nach John S. an G2, die Guthabenbilanz steigt schnell an, sobald du die Premium-Optionen aktivierst:
"Die Kreditkosten können sich erheblich summieren, insbesondere wenn man die Premium-Einstellungen verwendet, was die Budgetierung der Nutzung im Verhältnis zu den Kosten entsprechend schwierig machen kann."
Meinungen zu den von ScraperAPI angebotenen Diensten
Hier finden Sie eine Übersicht über die wichtigsten Dienstleistungen von ScraperAPI und was den Nutzern tatsächlich in Erinnerung bleibt – Dienst für Dienst.
1. Automatische Rotation von Proxys
ScraperAPI stützt sich auf ein umfangreiches Proxy-Pool die er bei jeder Abfrage automatisch dreht. Diese IP-Rotation verhindert weitgehend, dass es zu Blockierungen kommt, wenn du mehrere Aufrufe an dieselbe Website hintereinander sendest.
Die Rückkehr von Aditya Pratap Singh an Trustpilot :
"ScraperAPI hat meine Web-Scraping-Projekte revolutioniert. Ich hatte ständig mit CAPTCHAs und IP-Sperrungen zu kämpfen, bevor ich diesen Dienst fand. Jetzt kann ich mich darauf konzentrieren, die Daten zu nutzen, anstatt darum zu kämpfen, sie zu bekommen. Die Proxy-Rotation ist flüssig und ich schätze die automatische Verwaltung des JavaScript-Renderings."

2. Verwaltung der Schutzumgehung (Bypass)
Das Tool kann die Anti-Bot-Mechanismen komplexe Systeme, Firewalls und die CAPTCHA. Das Ergebnis: eine reibungslosere Datenextraktion, selbst auf stark geschützten Websites wie Google.
Nach Arun K., assoziierter Forscher:
"Google hat es geschafft, programmatische Anfragen auch für nichtkommerzielle Zwecke und zur Selbstarchivierung zu blockieren, und ScraperAPI hat sich als äußerst effektiv erwiesen, um diese zu umgehen. Obwohl das Routing von Anfragen über ScraperAPI viel langsamer ist als beispielsweise über einen kostenlosen Proxyserver".
Hinweis: Diese höhere Zuverlässigkeit geht manchmal mit einem Reaktionszeit umfassender als ein einfacher, herkömmlicher Proxy.

3. JavaScript-Rendering
Dank eines kopfloser Segler integriert, ScraperAPI kann dynamische Websites scrapen, deren Inhalt über JavaScript. So erhältst du den Tatsächlich angezeigter HTML-Code, und nicht nur das Roh-HTML vom Server zurückgegeben. Das ist unerlässlich, um Parsing zuverlässig auf clientseitig generierten Seiten.
Die Rückkehr von Fazt Tech an Trustpilot :
"ScraperAPI hat unsere Web-Scraping-Prozesse erheblich verbessert. Die API ist einfach zu integrieren und übernimmt die meisten schwerfälligen Aufgaben, wie die Rotation von IP-Adressen und die Verwaltung von Proxys, was uns wertvolle Zeit spart. Die automatische Verwaltung von Captchas ist ein großer Vorteil und vereinfacht unsere Datenerfassung erheblich."

4. Anpassen von Abfragen
Du kannst deine Suchanfragen individuell anpassen HTTP durch Änderung der Kopfzeilen, Sie Kekse bei dem die user-agent. Dies hilft dabei, unterschiedliche Verhaltensweisen zu simulieren und eine Erkennung auf den strengsten Websites zu vermeiden.
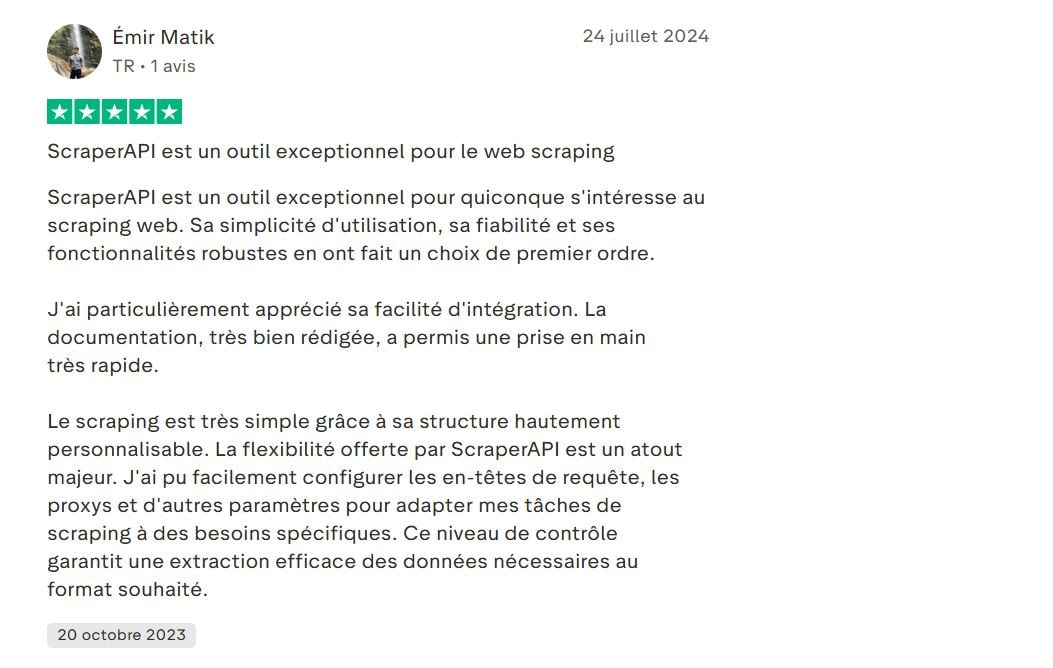
Die Meinung von Émir Matik an Trustpilot :
«…Das Scraping ist dank der hochgradig anpassbaren Struktur sehr einfach. Die Flexibilität, die ScraperAPI bietet, ist ein großer Vorteil. Ich konnte die Request-Header, Proxys und andere Parameter ganz einfach konfigurieren, um meine Scraping-Aufgaben an spezifische Anforderungen anzupassen…»
5. Geolokalisierung von Proxys
ScraperAPI lässt dich die Wahl treffen, ob du’geografischer Standort der Proxyserver, nach Ländern. Dies geografisches Targeting ist nützlich, um standortspezifische Daten abzurufen oder regionenspezifische Ergebnisse zu testen, beispielsweise Preise, die je nach Markt variieren.
Die Rückkehr von Melih Krs an Trustpilot :
«…Außerdem war die Unterstützung bei der JavaScript-Rendering und der IP-Geolokalisierung von großem Nutzen…»

6. Anzeiger und Statistiken
EIN umfassendes Dashboard abhängig von deiner Nutzung, der Anzahl der Anfragen, der Erfolgsquote und das verbleibende Guthaben. So behältst du deinen Verbrauch im Blick und passt deinen Plan an die tatsächliche Auslastung an.
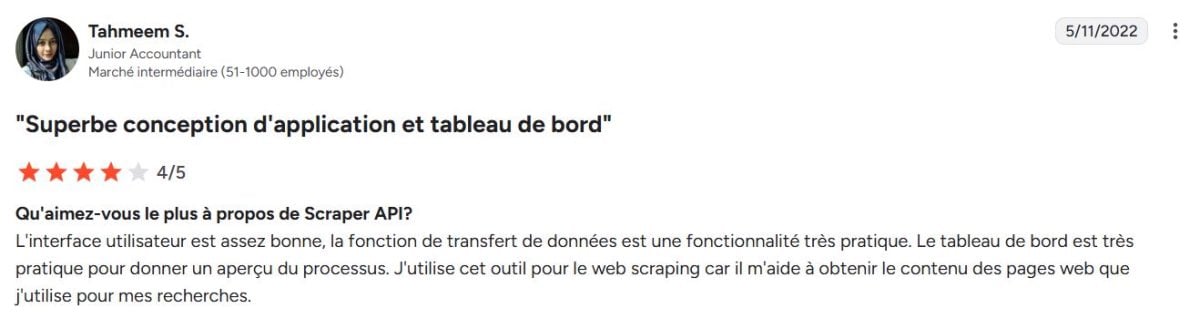
Nach Tahmeem S. an G2 :
"Die Benutzeroberfläche ist ziemlich gut, die Datenübertragungsfunktion ist ein sehr praktisches Feature. Das Dashboard ist sehr praktisch, um einen Überblick über den Prozess zu geben. Ich verwende dieses Tool für das Web-Scraping, da es mir hilft, den Inhalt der Webseiten zu erhalten, die ich für meine Recherchen verwende."
7. Mehrsprachige Integration und Unterstützung
ScraperAPI bietet eine REST-API einfach, lässt sich leicht in die meisten Sprachen integrieren: Python, Node.js, PHP, Java, usw. Diese schnelle Integration erleichtert den Einsatz in den unterschiedlichsten Umgebungen, vom kleinen Skript bis hin zum Projekt in der Produktion.
Was gesagt wird Deni H. an G2 :
«Die Erfahrung, die für die Scraper-API erforderlich ist, entspricht wahrscheinlich der eines erfahrenen Entwicklers im Bereich Web-Scraping, der über Kenntnisse verschiedener Scraping-Technologien verfügt, darunter Python (BeautifulSoup und Selenium), JavaScript (Puppeteer oder Cheerio) und Node.js (Demand und Cheerio) …»

8. Erweiterte Funktionen für Daten
Über das klassische Scraping hinaus, ScraperAPI treibt die Datenverarbeitung und die Automatisierung in großem Maßstab weiter voran:
- Asynchrones Scraping : Du sendest Millionen von Anfragen parallel, ideal für die Datenerfassung in sehr großem Umfang auf zahlreichen Websites.
- Endpunkte für strukturierte Daten : Bei einigen beliebten Websites werden die Daten direkt im Format JSON, die ohne zusätzlichen Parsing-Schritt einsatzbereit sind. Das ist besonders nützlich für Hobbyprojekte sowie für Start-up-Teams, die schnell vorankommen wollen.
ScraperAPI: Die Alternativen
ScraperAPI ist nicht der einzige Akteur auf dem Markt für Web Scraping. Verschiedene Alternativen unterscheiden sich hinsichtlich ihres Ansatzes, ihrer Preise oder ihrer Funktionen. Hier sind die wichtigsten, die du kennen solltest, bevor du dich für ein Tool entscheidest.
| Werkzeug | Besonderheit | Nutzermeinungen | Durchschnittliche Bewertung |
|---|---|---|---|
| ScraperAPI | Proxys automatisch drehen, JavaScript-Rendering, Anpassen | Zuverlässig und einfach zu bedienen, aber manchmal verwirrend in Bezug auf die Preisgestaltung | 4,5 |
| Bright Data | Eine sehr umfassende Plattform mit Premium-Proxys und einer fortschrittlichen Datenpipeline | Sehr leistungsstark und flexibel, aber komplex in der Handhabung | 4,6 |
| ScrapingBee | Einfache API mit JS-Rendering und Proxy-Rotation | Einfach zu integrieren und gutes Preis-Leistungs-Verhältnis, aber weniger erweiterte Optionen | 4,9 |
| Octoparse | Visuelles Scraping ohne Code, Ansatz ohne Programmierung | Ideal für Laien, bei großen Mengen jedoch nur begrenzt einsetzbar | 4,4 |
| Apify | Plattform für die Entwicklung maßgeschneiderter Scraper | Sehr flexibel und individuell anpassbar, erfordert jedoch technische Kenntnisse | 4,8 |
Konkret richtet sich jede Lösung an ein anderes Profil. ScrapingBee bleibt der engste Konkurrent von ScraperAPI bei kleinen und mittleren Lasten. Octoparse richtet sich an Nicht-Entwickler, die Daten extrahieren möchten, ohne eine einzige Zeile Code zu schreiben. Apify, richtet sich hingegen an technische Teams, die ihre eigenen Scraper entwickeln.
Wenn du sehr große Anforderungen hast, mit einem Premium-Proxy-Pool und eine Push-Datenpipeline, Bright Data ist einen Abstecher wert.
Es ist die leistungsstärkste Lösung auf dem Markt, aber auch die teuerste und diejenige, deren Handhabung am meisten Zeit in Anspruch nimmt. Für die meisten Anwendungsfälle, ScraperAPI bietet nach wie vor ein hervorragendes Preis-Leistungs-Verhältnis.
Niklas fasst diese Positionierung gut zusammen unter Capterra :
«Bright Data ist zwar teurer, aber der beste Dienst seiner Art.»

Häufig gestellte Fragen
Ist ScraperAPI ein kostenloses Tool?
Nein ScraperAPI ist kostenpflichtig, aber er macht trotzdem ein Angebot kostenlos begrenzt, mit einem kleinen Kontingent an Anfragen, um den Dienst zu testen, bevor man sich für ein Abonnement entscheidet.
Wie viel kostet ScraperAPI?
Die Preise beginnen bei 49$/Monat (Hobby) und reichen bis zu 1 975$/Monat, mit einem Enterprise-Angebot auf Anfrage für sehr große Volumina. Der Preis hängt vom gewählten Tarif ab, vom Anfragevolumen sowie aktivierte Optionen wie JavaScript-Rendering oder Geotargeting. Es gibt Tarife, die sowohl für Hobbyprojekte als auch für wachsende Start-ups geeignet sind.
Jede Abfrage verbraucht eine bestimmte Anzahl von variable Gutschriften. Eine einfache Seite in HTML Eine einfache Anfrage kostet wenig, während eine Anfrage mit Premium-Proxy oder JavaScript-Rendering deutlich mehr Ressourcen verbraucht.
Deshalb sind die Credits eines Plans schnell aufgebraucht, wenn du komplexe Websites scrapst.
Wie funktioniert ScraperAPI?
ScraperAPI wirkt wie ein Intermediär zwischen deiner Anwendung und den zu scrapenden Websites. Es verwaltet automatisch die Proxy-Rotation, die Verwaltung von IP-Adressen, die JavaScript-Ausführung und die Umgehung von Schutzmaßnahmen.
Konkret sendest du eine Anfrage an die API und rufst den Inhalt ab HTML der Zielseite, ohne dass du dir Gedanken über Blockierungen machen musst. Das Tool stützt sich auf ein umfangreiches Proxy-Pool, verteilt auf zahlreiche Länder um die Daten ohne Unterbrechung abzurufen.
Wie kann ich ScraperAPI mit Python verwenden?
Die Integration mit Python ist dank einer Gut dokumentierte REST-API. Du musst lediglich eine HTTP-Anfrage an die API-Adresse senden, und zwar mit dein API-Schlüssel und die Ziel-URL.
1. Gib die ScraperAPI-URL zusammen mit deinem API-Schlüssel und der Ziel-URL an
Anfragen importieren

url = "http://api.scraperapi.com"
params = {
    'api_key': 'TA_CLE_API',
    'url': 'https://exemple.com'
}
2. Sende die Anfrage ab
response = requests.get(url, params=params)3. Zeigt den Inhalt der abgerufenen Seite an
print(response.text)Anschließend kannst du HTML-Analyse mit einer Bibliothek wie BeautifulSoup, oder die Endpunkte für strukturierte Daten, die die Daten in JSON gebrauchsfertig.
Kann ScraperAPI CAPTCHAs umgehen?
Ja. Eine der Stärken von ScraperAPI ist seine Fähigkeit, automatisch die CAPTCHA und die anderen Anti-Bot-Systeme. Das erklärt seine gute Erfolgsquote in vielen Naturschutzgebieten.
ScraperAPI bleibt eine leistungsstarke Lösung um die Online-Datenerfassung zu automatisieren. Zögere nicht, deine Fragen in den Kommentaren zu stellen und deine Erfahrungen zu teilen!




 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA