刮刀 Booking.com, ,即使不写一行代码也能做到。你有两种主要选择:
- 使用 无代码工具 作为 Bright Data, Octoparse 在哪里 Apify
- 或者用以下语言编写你自己的爬虫程序: Python
这些工具会帮你处理阻塞问题,而代码则让你能更好地控制提取的数据(价格、库存、评价)。.

在布景上刮擦的不同方法
这 网络搜刮 是指自动提取大量 结构化数据 从一个网站上。这种方法比手动复制快得多,尤其是当你需要处理数千个页面时。.
用于抓取 Booking.com, ,你可以选择两种方法: 刮削工具 无需编写代码、快速部署,或者编写代码 Python, ,让你能掌控每一个细节。.
1.使用网络搜索工具
工具 网络搜刮 是 全套解决方案, ,如果你不想编写代码,这些工具再合适不过了。它们会帮你处理诸如 IP封禁 和 验证码.
以下是三种流行的网页抓取工具 Booking.com 无需编写任何代码:
- Bright Data
- Octoparse
- Apify
亮数据

Bright Data 是一个 完整解决方案 将……结合起来 代理, 爬虫浏览器和 应用程序接口. 它在Booking.com上的核心功能是其 刮刀预订 即用型,可轻松回收 价格, 他们 可用性 以及一家酒店的评价。.
快来探索我们的 全面评测 Bright Data.
Octoparse

Octoparse 是一个 无代码工具 采用点选式界面,非常适合非技术用户。其预设模板 预订酒店信息刮刀 只需点击几下,即可提取商家名称、价格和评分。随后可直接从云端导出,通过 CSV, Excel 或 JSON.
快来探索我们的 Octoparse 全面评测.
Apify
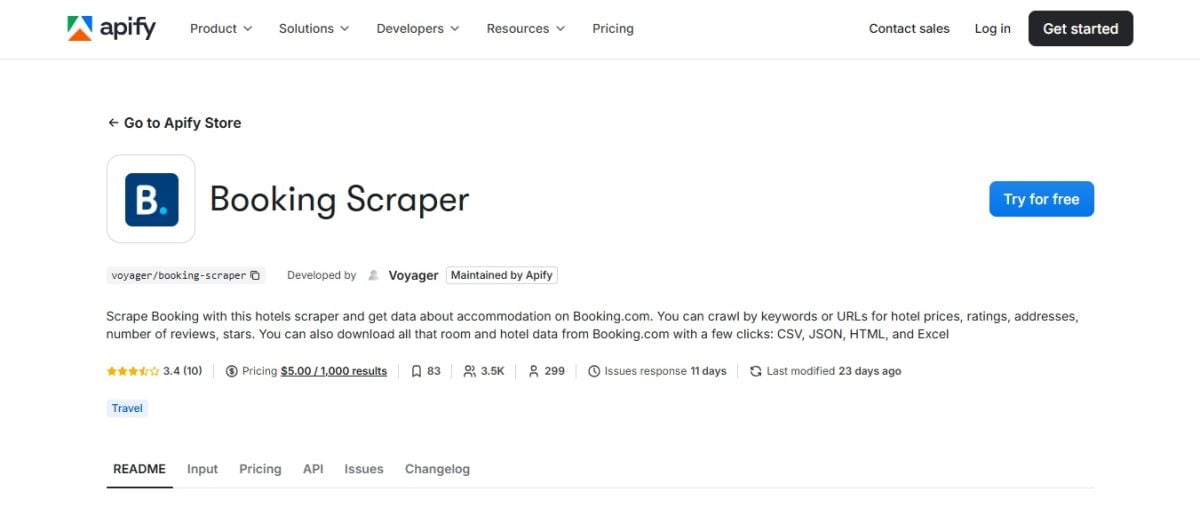
Apify 是一个开发平台,提供了一个庞大的库,其中包含 即用型刮板 被称为«Actors»。这款非常受欢迎的 预订刮刀 无需编写代码即可提取各种大规模数据。系统会自动为你处理分页和延迟问题,并支持导出为 结构化JSON.
快来探索我们的 全面评测 Apify.
2.使用 Python 浏览代码
这 代码网络搜索 是处理复杂或重复性任务的理想解决方案。该生态系统 Python 由于拥有众多专业书店,这里的书目特别丰富。.
以下是您必去的书店 使用以下工具抓取Booking.com的数据 Python :
- Requests 和 BeautifulSoup :关于静态爬取的基础知识。. Requests 发送 HTTP 请求 并提取页面中的HTML源代码,就像你的浏览器所做的那样,只是这个过程是自动完成的。. BeautifulSoup 随后分析该HTML,并从中提取出具体的元素:标题、价格、链接。.
- Selenium 在哪里 Playwright : 关于 动态内容 以及 JavaScript 交互。这些工具控制着网页浏览器(Chrome 在哪里 Firefox) 自动完成:他们点击、填写表单并滚动页面以加载所有内容 JavaScript 在检索数据之前。.
- Scrapy :适用于……的完整框架 大型项目. 它集成了请求管理、数据处理和存储功能。如果你计划抓取 数千页 或者想要实现整个流程的自动化,这就是你需要的工具。.
如何使用Python从Booking.com抓取数据?
本指南将向你展示一个使用 Selenium 用于从Booking.com提取数据。该代码包含错误处理功能,并能干净地关闭浏览器。.
1. 浏览器的配置与启动
使用 Selenium 以像在真实浏览器中一样打开Booking.com(Chrome, Firefox).
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from webdriver_manager.chrome import ChromeDriverManager
from bs4 import BeautifulSoup

# 自动启动 Chrome
driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()))
2. 获取HTML代码并进行提取
加载一页搜索结果 预订 (此处指巴黎的酒店),获取HTML代码,然后保留 BeautifulSoup 提取酒店名称。该代码块 try / finally 确保浏览器即使出现错误也能始终正常关闭。.
try:
    driver.get("https://www.booking.com/searchresults.html?ss=Paris")

 # 获取页面的源代码
    html = driver.page_source
    soup = BeautifulSoup(html, "html.parser")

 # 基于 data-testid 属性的选择器,比 CSS 类更稳定
    hotels = soup.select('[data-testid="property-card"] [data-testid="title"]')

 if not hotels:
 print("未找到任何结果。请检查 CSS 选择器。")

 for hotel in hotels:
        print(hotel.get_text(strip=True))

except Exception as 错误:
    print("发生错误:", 错误)

finally:
    driver.quit()  # 务必关闭浏览器
重要说明 : Booking.com 会定期更新其网页的设计。.
他的 选择器 因此可能会导致你的代码发生变化甚至失效。如果代码不再返回任何内容,请检查页面(右键点击,选择«检查»),并核对酒店信息页面的 data-testid 属性。.
如需更详细的指南,请参阅我们专门介绍该主题的文章 使用Python抓取网站.
为什么要在 Booking 上做剪贴簿?
这 从...中抓取数据 Booking.com 这为企业与个人都带来了真正的机遇。通过大规模采集公开数据,你可以更快地做出更明智的决策。若想全面了解这一做法的种种优势,不妨阅读我们关于 进行网页抓取的原因.
以下是最实用的使用场景。.
1. 竞争对手动态监测与市场分析
- 价格监测 : 你关注着 费率 在不同日期进行分析,以调整你自己的定价策略,特别是借助 价格抓取.
- 需求分析 : 你可以发现某项服务的预订趋势 目的地 或某个具体时间段。.
- 竞争基准: 你可以根据评分、距离市中心的远近或公示的税费,将你的酒店与周边酒店进行比较。.
2. 声誉管理与客户评价管理
- 意见跟踪 : 你收集客户反馈以改进服务。.
- 情感分析 : 你通过评估评论的整体基调,来了解自己的优势和不足。.
3. 应用程序与服务开发
- 旅游聚合器 : 你可以创建一个平台,汇总多个网站的最佳优惠,就像你也可以通过 爱彼迎.
- 学术研究 : 从Booking提取的数据用于旅游和旅行经济研究。这些数据集为分析大范围趋势提供了坚实的基础。.
数据抓取还可实现’自动化 数据收集,并定期将更新内容导出至 CSV 或在 JSON. 归根结底,真正的收获是 时间 你从手动收集中获取的。.
可以从 Booking.com 提取哪些类型的数据?
Booking.com 是一部真正的 信息宝库. 你可以从三个主要层面提取数据:’机构, 他们 客房与价格,以及 客户评价.
所有这些信息均可通过数据抓取获取,随后可导出为 CSV 在哪里 JSON 以构建一个可用的数据集。以下是你可收集的数据项的非详尽列表。.
学校信息
- 名称’机构
- 住宿类型: 酒店, ,公寓、旅馆……
- 完整地址和邮政编码
- 地理坐标(回旋余地, 经度)
- 链接 (网址) 跳转至该机构的页面
- 该机构的详细介绍
- 设施与服务: 无线网络, ,游泳池、停车场、空调……
- 取消、登记和离店政策
- 网址 主要图片和图片集
价格、客房及房源情况
- 价格 针对不同的入住日期和住宿时长
- 含/不含价格 税款
- 已适用的促销和折扣
- 可用状态:可用或 完全的
- 某类客房的剩余床位数
- 房型名称及类别:双人房、套房……
- 房间面积和 接待能力
- 客房专属设施
客户评价与评分
- 总体说明 该机构(例如 8,5/10)
- 评论总数
- 按类别划分的评分: 清洁度, 舒适度、地理位置、性价比
- 每份意见的全文
- 客户姓名及原籍国
- 公告发布日期
- 客户给出的评分及其«喜欢/不喜欢»评价»
地理位置与环境
- 距离 相对于市中心
- 距离景点:博物馆、, 火车站, 机场
- 社区或周边区域的描述
- 该位置的评分
Booking.com 剪贴簿常见的技术问题有哪些?
预订已设立了多个 反机器人系统 以阻止机器人和爬虫。这些检测机制是你想要从网站中提取数据时面临的主要困难。.
以下是常见问题及其解决方法。.
1.按 IP 阻断
如果你从同一个地址发送过多的请求 IP 地址, ,你很快就会被封禁。Booking.com 会监控每个 IP 地址的请求次数,以识别自动化行为。.
解决方案: 使用 代理轮换. 诸如以下工具: Bright Data 提供可隐藏你IP地址的代理网络。这样,你的请求看起来就好像来自不同的地址,从而降低了被封锁的风险。.
2.验证码
越来越多的网站,包括Booking.com在内,都显示一个 验证码 用于验证用户是否为真人。这是自动化爬虫常见的障碍。.
解决方案: 通过以下服务 自动解决验证码. 他们会代你完成这一步,让提取过程在无需人工干预的情况下继续进行。.
3.用户代理拦截
网站可能会拦截那些与真实浏览器请求不符的请求。如果请求中缺少 用户代理 可信的账号很容易被识别为机器人。.
解决方案: 修改你的 用户代理 用于模拟各种浏览器,例如 Chrome 在哪里 Firefox, ,并在每次请求时改变这些值,以保持隐蔽。.
4.难以加载的动态内容(JavaScript)
在Booking.com上,许多数据并未出现在页面的原始源代码中。这些数据是通过 JavaScript 在显示之后,这使得普通HTTP爬虫无法检测到它们。.
解决方案: 用途 Selenium 在哪里 Playwright. 这些工具会执行 JavaScript 代码,并像真实用户一样与网页进行交互,让你能够访问所有显示的内容。.
常见问题
搜索 Booking.com 是否合法?
这 网络搜索的合法性 这是一个复杂的话题。提取 公共数据 这本身并不被禁止,但具体情况取决于多个因素:
- 这 使用条件 的 Booking.com, ,其中禁止未经事先书面授权的自动化抓取
- 遵守 RGPD 一旦涉及个人数据(用户名、署名评论)
- 这 数据类型 提取内容:一方面是公开的价格和库存情况,另一方面是个人信息
- 这 著作权, ,因为酒店的描述和照片仍受保护
具体来说,从Booking.com抓取数据本身并不违法。但如果违反了关于 著作权 或者 机密性 未得到遵守。.
Booking.com 是否有 API 访问权限?
不 Booking.com 不提供面向公众的开放API,用于提取酒店价格、评论或描述等数据。不过,Booking拥有两项专供签约合作伙伴使用的API:
- 这 Connectivity API, ,面向连接合作伙伴(渠道经理、酒店管理软件)。. 该系统可用于管理其所接入的住宿设施的房源状况、房价及预订情况。.
- 这 Demand API, ,仅限Booking认证的联盟合作伙伴使用。通过该平台,用户可访问网站上的房源信息:搜索住宿、查看实时价格和空房情况、查阅住宿详情及客户评价。.
Booking.com API 还是数据抓取:该选哪个?
由于不存在面向所有人的公开API,因此该 网络搜刮 通常仍是进行大规模数据恢复的唯一选择。主要区别在于:
- 合作伙伴API :仅限签约合作伙伴使用。该 Connectivity API 用于管理自己的机构。该 Demand API, 该功能专供已验证的合作伙伴使用,可通过稳定的JSON格式查询库存的價格、库存情况和评价。.
- 网页抓取: 向所有 公开页面, ,它涵盖了所有可见的目录信息(价格、评分、日期),并支持导出为 CSV, JSON 或Excel。由于网站在不断更新,因此需要定期维护。.
简而言之:如果你是主机服务商,那么 Connectivity API (通过你的渠道管理器)即可轻松管理你的广告。.
如果您想 分析竞争 或者做…… 价格监测 如果没有联盟合作伙伴身份,数据抓取就变得不可或缺。.
如何在不编码的情况下抓取 Booking.com?
上文介绍的这三种工具是最适合在无需编写任何代码的情况下抓取Booking.com数据的:
- Bright Data : 集成了浏览器的全功能服务,支持代理管理以及 专用于Booking.com的数据抓取工具
- Octoparse : 点选式可视化界面,用于创建你的爬取脚本
- Apify : 基于该的云平台 预订刮刀 即用型
你也可以使用 网络搜刮扩展 为了 Chrome, ,但在Booking.com上,这些选择仍然有限。.
你打算测试哪种方案?如果你还有其他问题,欢迎在评论区提出。.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA