使用 Python 进行网页抓取主要依赖于两个核心库: requests 用于抓取网页并 BeautifulSoup 以便从中提取数据。.
在这篇文章中,你将了解到如何安装它们、编写你的第一个脚本以及保存结果——即使你没有任何编程经验。.
使用 Python 进行刮擦的先决条件

在开始之前,需要满足三个条件。以下按逻辑顺序列出。.
1.编程基础知识
你应该知道这些 编程基础 :变量、控制结构、函数、字典、文件操作和库。这些概念能帮助你理解 脚本逻辑, ,对检索到的数据进行处理,并妥善处理错误。.
2.掌握网页结构(HTML、CSS)
Python 看待网页的方式与你不同。它只看到 HTML代码 构成了该页面。如果你想获取某条具体信息,就必须知道它在代码中的位置,否则Python无法将其提取出来。.

3.了解 HTTP 请求(GET、POST)
在读取页面代码之前,Python 必须通过请求向网站获取该代码。一个 GET 请求 加载该页面,而另一个 POST请求 将数据发送至网站。如果不理解这一点,你的脚本就无法获取该页面及其所包含的信息。.
另一个重要问题是: 网络搜刮 与……不同 爬行. 爬网会遍历网站的所有页面,对其进行统计和分析。而数据抓取则仅针对特定信息。这一区别有助于你合理规划工作。.

使用 Python 进行网络搜索的基本工具有哪些?
首先,你需要分三个步骤准备好工作环境:安装Python、隔离你的项目,然后添加所需的库。.
1.安装 Python
请从官方网站 python.org 下载 Python。在 Windows 系统上安装时,请务必勾选该选项 将 Python 添加到 PATH 中. 勾选此复选框将添加 Python 文件夹及其子文件夹 Scripts\ 在 PATH 中,这使得该命令 pip 可直接在命令行中调用。.
自从 Python 3.4, pip 默认已包含。这是包管理器,可让你安装所需的所有库。如果系统无法识别它,请执行以下命令: python -m pip 在任何情况下都能正常运行。.
2.准备虚拟环境
一个 虚拟环境 将你的 Python 项目的库进行隔离,而不影响机器上的其他应用程序。你可以通过以下方式创建它: python -m venv venv, ,然后将其启用。这样,你的安装环境就仅限于该项目了。.
3.安装用于刮擦的关键库
A 图书馆 是一组预先编程好的函数,你可以直接在代码中使用。它能让你免于自己从头编写,并简化重复性任务。以下是主要功能:
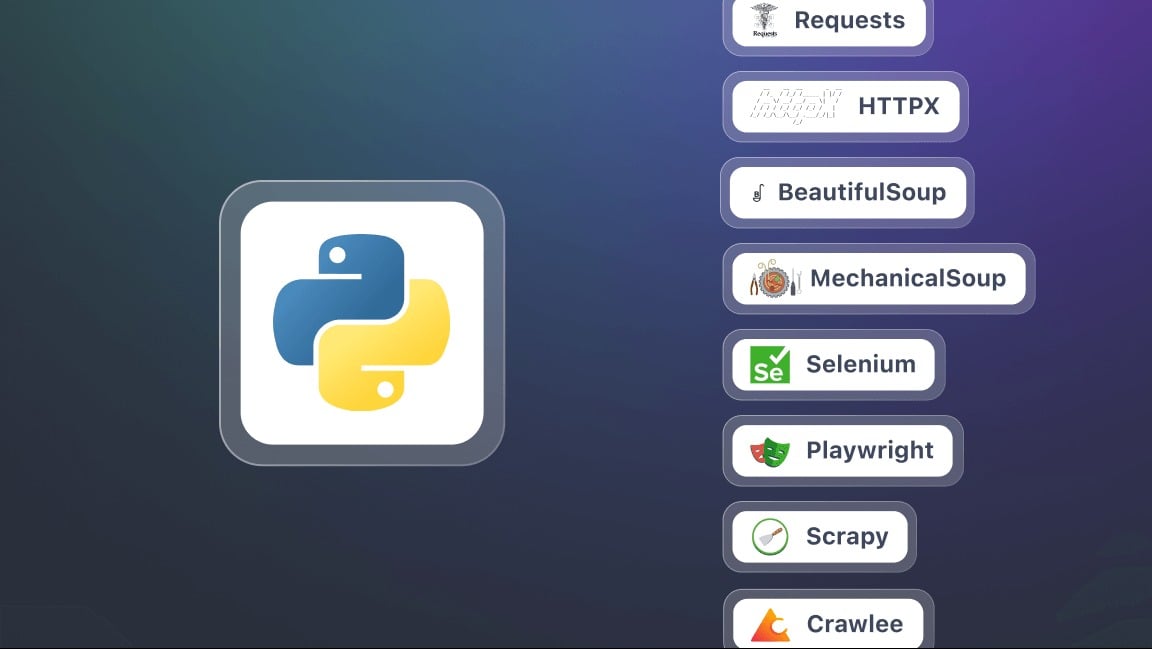
- Requests : 发送 HTTP 请求并获取网页内容。这是所有爬取操作的基础。.
- BeautifulSoup : 分析HTML代码,并通过诸如以下这些实用的选择器提取信息: find(), find_all() 在哪里 select().
- Selenium :当内容通过 JavaScript 动态生成时,此功能非常有用。它模拟真实的浏览器并与页面进行交互。.
- lxml :一款速度极快的HTML和XML解析器,性能优于 BeautifulSoup, ,但上手起来稍微复杂一点。.
- Playwright :一种现代的替代方案,用于 Selenium, ,通常更快。.
- Scrapy :一个用于大规模抓取项目的强大框架,能够同时处理多个页面和多个网站。.
如何使用 Python 进行网络搜索?
以下是启动你的第一个数据抓取项目的分步指南。每个步骤都配有 代码片段 准备好复制了。.
步骤 1:安装库(requests 和 beautifulsoup4)
你需要两个库: requests 以检索页面并 beautifulsoup4 以便从中提取数据。使用以下命令一次性安装它们: pip :
pip install requests beautifulsoup4无论 pip 未被识别,请使用 python -m pip install requests beautifulsoup4, ,无论你的PATH环境变量如何设置,它都能正常运行。接下来,请在脚本开头添加以下两行代码:
import requests
from bs4 import BeautifulSoup
步骤 2:发出 HTTP 请求并检索内容
库准备就绪后,你可以发送一个 HTTP 请求 跳转到一个网页并显示其内容。请记得使用’完整网址 目标页面的:
进口请求

url = "https://exemple.com"
page = requests.get(url)

print(page.text) # 显示页面的 HTML 代码
给你 page.text 包含你要分析的网站的全部HTML代码。.
步骤 3:使用 BeautifulSoup 解析 HTML
既然你已经获取了内容,就可以使用以下工具进行分析: BeautifulSoup. 这一步将 普通 HTML 整理成一种便于浏览的结构:
从 bs4 导入 BeautifulSoup

soup = BeautifulSoup(page.text, "html.parser")

# 示例:显示页面标题
print(soup.title.string)
第 4 步:提取特定数据(标题、链接等)
谢谢 BeautifulSoup, 你可以 锁定特定的HTML标签 :标题、链接、段落等。以下是两个最常见的例子:
# 提取所有标题 <h2>
for title in soup.find_all("h2"):
    print(title.get_text())

# 提取所有链接 <a>
for lien in soup.find_all("a"):
    print(link["href"])
第 5 步:保存数据(CSV、JSON)
提取数据后,你可以 保存到文件中 以便日后再次使用。该格式 CSV 适用于画作,该 JSON 结构化数据。.
CSV 示例 :
导入 csv

titles = [title.get_text() for title in soup.find_all("h2")] title.get_text() for title.find_all("h2")

with open("results.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["Title"])
    for t in titres:
        writer.writerow([t])
JSON 示例:
导入 json

liens = [lien["href"] for lien in soup.find_all("a")]

with open("liens.json", "w", encoding="utf-8") as f:
    json.dump(liens, f, indent=4, ensure_ascii=False)
本教程旨在面向 小项目, ,例如从静态网站抓取数据。实际上,你很快就会遇到更复杂的挑战:
- 管理分页 :跨多页循环以获取所有内容。.
- 管理表格 : 通过POST请求发送数据以获取筛选后的结果。.
- 绕过限制 : 添加一个真实的标识头,并经过 代理 以避免卡住。
为什么要使用 Python 进行网络搜索?
这 使用 Python 进行网络搜索 为你打开了许多切实可行的可能性。以下这些用途,让这项实践在日常生活中真正派上用场。.
- 价格跟踪和电子商务 : 你收集产品资料卡,以跟踪产品的 费率, ,比较竞争对手的报价,并实时发现最佳机会。.
- 客户评价分析 :你从多个网站收集评论,以发现趋势、了解消费者需求并改进产品或服务。.

- 内容聚合 : 你可以将来自多个来源的博客文章或新闻汇集到一起,打造一个始终保持更新的平台。.
- 研究与信息监测 :你负责为研究收集数据、跟踪相关出版物,或者关注某个特定领域。.
实际上,网络爬虫能帮你省去数小时的手动复制粘贴工作。只需一个设计精良的脚本,就能按照你设定的频率自动抓取并更新数据。.
使用 Python 进行网络搜索的最佳实践是什么?
网络爬虫不仅仅是提取数据,还必须以一种 高效、负责任且可持续, ,否则你可能会很快被封号。以下是需要遵守的规则:
- 尊重 robots.txt 文件 : 位于网站根目录下(例如. exemple.com/robots.txt),它会告诉你哪些页面允许或禁止抓取。在运行脚本之前,请先查看该文件。.
- 保持合理的请求频率 : 在每次请求之间添加一个暂停,以避免服务器过载并导致你被封号。.
- 使用合适的User-Agent : 填写表头 User-Agent 该名称能明确标识你的机器人,而不是使用默认值 requests, ,通常会被系统自动屏蔽。.
- 处理错误和异常 : 请在查询语句外包裹一个错误处理代码块。一个页面无法访问的情况不应导致整个程序崩溃。.
- 使用代理服务器和IP轮换 : 在大流量情况下,轮换使用多个IP地址可以避免某个IP地址被识别并被封锁。.
- 尽量减少请求数量 : 仅抓取你真正需要的页面。请求越少,服务器负载就越低,被发现的风险也就越小。.
- 保持透明 : 如有可能,请标注一个 联系邮箱地址 在你的 User-Agent. 这样,网站管理员就可以联系你,而不是将你拉黑。.
- 将提取和备份分开 : 先提取数据,然后将其存储到CSV文件或数据库中。如果处理失败,你收集的数据也不会丢失。.
- 使用健壮的选择器 : 优先考虑诸如以下这些稳定的属性: ID 在哪里 data-* 而不是那些经常变化的CSS类。这样,你的脚本在网站更新时更能保持稳定。.
- 为你的代码编写文档 : 说明关键步骤并记录 你抓取数据的日期. 页面的结构会不断变化,这样当页面出现故障时,你就能更快地弄清楚该如何修复。.
常见问题
用 Python 进行网络搜索的最佳框架是什么?
没有单一的 "最佳 "框架,因为一切都取决于 你这个项目的复杂性.

- 用于简单提取、 Requests 和 BeautifulSoup 已经绰绰有余了。.
- 当一个网站大量使用 JavaScript, 你转到 Selenium 在哪里 Playwright.
- 最后,对于一个大型项目,, Scrapy 凭借其卓越的性能和坚固的结构,它仍然是最合适的选择。.
如何用 Python 搜刮网站?
该流程基于 三个主要步骤 :
- 你发送一个 HTTP 请求 跳转至目标页面。.
- 你正在分析 HTML结构 已收到。.
- 你提取 数据 你感兴趣的,然后保存下来。.
网络搜刮工具的作用是什么?
这 网络爬虫的作用 是自动爬取网页以提取特定数据:文本、价格、图片或链接。它充当网站与你之间的中介,将原始信息转化为 可利用的数据.

如何在 Python 中使用 BeautifulSoup?
BeautifulSoup 这是一个专为分析网页的HTML代码而设计的库,可轻松定位包含待提取信息的标签。具体来说,你需要结合一个 HTTP请求,使用 Requests, ,然后使用以下方式解析内容: BeautifulSoup 用于浏览结构并获取所需数据。.
如何抓取包含JavaScript动态内容的网站?
有些网站严重依赖 JavaScript 以显示其内容。在这种情况下,传统的解决方案如 Requests 已经不够用了。因此,你需要使用能够模拟真实浏览器的工具,例如 Selenium 在哪里 Playwright, ,以加载页面并与之交互。.
网络搜索最常用的语言是什么?
Python 如今,它已成为网络爬虫领域最流行的编程语言,这得益于其简单易用以及丰富的专用库。话虽如此,你也可以实现……的自动化’使用……进行数据提取 PHP, ,尽管这种技术目前仍不甚普及。.
网络搜索合法吗?
这 网络搜索的合法性 这是一个复杂的问题。这完全取决于你的实践方式,以及是否遵守 使用条件 所涉及的网站以及所收集数据的性质。在法国,网络爬虫技术是 在某些情况下被允许, ,但如果其行为侵犯了访问权、网站的使用条款或有关 个人资料.
总之,使用Python进行网页抓取开启了一个充满无限可能的世界!那么,你有什么经验或疑问吗?欢迎在评论区分享,我们期待你的留言!








 ZH