Le web scraping avec Python repose sur deux bibliothèques principales : requests pour récupérer les pages web et BeautifulSoup pour en extraire les données.
Dans cet article, tu vas voir comment les installer, écrire ton premier script et sauvegarder tes résultats, même sans expérience en code.
Prérequis pour faire du scraping avec Python

Avant de te lancer, trois conditions sont à remplir. Les voici dans l’ordre logique.
1. Avoir des notions en programmation
Tu dois connaître les bases en programmation : variables, structures de contrôle, fonctions, dictionnaires, manipulation de fichiers et bibliothèques. Ces notions te permettent de comprendre la logique des scripts, de manipuler les données récupérées et de gérer proprement les erreurs.
2. Maîtriser la structure d’une page web (HTML, CSS)
Python ne voit pas les pages web comme toi. Il voit uniquement le code HTML qui compose la page. Si tu veux récupérer une information précise, tu dois savoir où elle se trouve dans ce code, sinon Python ne peut pas l’extraire.

3. Comprendre les requêtes HTTP (GET, POST)
Avant de lire le code d’une page, Python doit le demander au site via une requête. Une requête GET récupère la page, tandis qu’une requête POST envoie des données au site. Sans cette compréhension, ton script ne peut ni obtenir la page ni les infos qu’elle contient.
Autre point important : le web scraping est différent du crawling. Le crawling parcourt toutes les pages d’un site pour les recenser et les analyser. Le scraping, lui, cible uniquement des informations précises. Cette distinction est utile pour bien planifier ton travail.

Quels sont les outils indispensables pour le web scraping avec Python ?
Pour démarrer, tu dois préparer ton environnement de travail en trois temps : installer Python, isoler ton projet, puis ajouter les bibliothèques utiles.
1. Installer Python
Télécharge Python sur le site officiel python.org. Pendant l’installation sous Windows, coche bien l’option Add Python to PATH. Cette case ajoute le dossier Python et le sous-dossier Scripts\ au PATH, ce qui rend la commande pip disponible directement en ligne de commande.
Depuis Python 3.4, pip est inclus par défaut. C’est le gestionnaire de paquets qui te permet d’installer toutes les bibliothèques dont tu auras besoin. Si jamais il n’est pas reconnu, la commande python -m pip fonctionne dans tous les cas.
2. Préparer un environnement virtuel
Un environnement virtuel isole les bibliothèques de ton projet Python, sans interférer avec les autres applications de ta machine. Tu le crées avec python -m venv venv, puis tu l’actives. Tes installations restent alors propres à ce projet.
3. Installer les bibliothèques clés pour le scraping
Une bibliothèque est un ensemble de fonctions déjà programmées que tu peux utiliser directement dans ton code. Elle t’évite de tout réécrire toi-même et simplifie les tâches répétitives. Voici les principales :
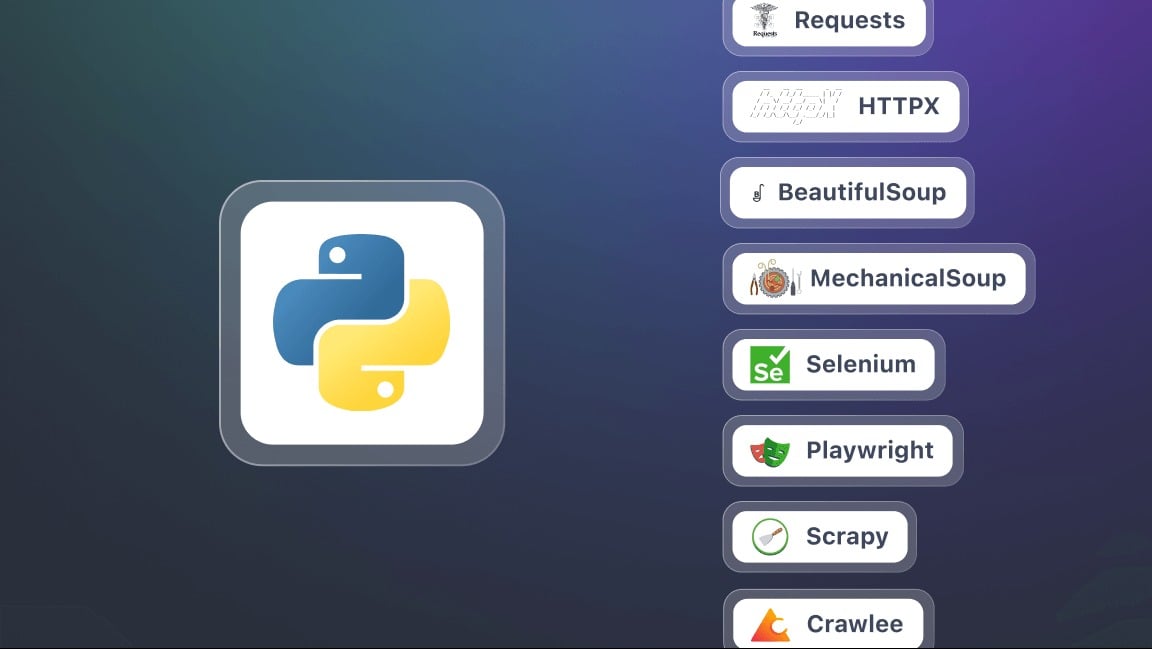
- Requests : envoie des requêtes HTTP et récupère le contenu des pages web. C’est la base de toute opération de scraping.
- BeautifulSoup : analyse le code HTML et extrait les informations grâce à des sélecteurs pratiques comme find(), find_all() ou select().
- Selenium : utile quand le contenu est généré dynamiquement en JavaScript. Il simule un vrai navigateur et interagit avec la page.
- lxml : un analyseur HTML et XML très rapide, plus performant que BeautifulSoup, mais un peu plus technique à prendre en main.
- Playwright : une alternative moderne à Selenium, souvent plus rapide.
- Scrapy : un framework puissant pour les projets de scraping à grande échelle, capable de gérer plusieurs pages et plusieurs sites simultanément.
Comment faire du web scraping avec Python ?
Voici la marche à suivre, étape par étape, pour lancer ton premier projet de scraping. Chaque étape s’accompagne d’un bout de code prêt à copier.
Étape 1 : Installer les bibliothèques (requests et beautifulsoup4)
Tu as besoin de deux bibliothèques : requests pour récupérer les pages et beautifulsoup4 pour en extraire les données. Installe-les d’un seul coup avec pip :
pip install requests beautifulsoup4Si pip n’est pas reconnu, utilise python -m pip install requests beautifulsoup4, qui fonctionne quel que soit ton PATH. Commence ensuite ton script par ces deux lignes :
import requests
from bs4 import BeautifulSoup
Étape 2 : Faire une requête HTTP et récupérer le contenu
Une fois les bibliothèques prêtes, tu peux envoyer une requête HTTP vers une page web et afficher son contenu. Pense à utiliser l’URL complète de la page cible :
import requests

url = "https://exemple.com"
page = requests.get(url)

print(page.text)  # Affiche le code HTML de la page
Ici, page.text contient tout le HTML du site que tu vas analyser.
Étape 3 : Parser le HTML avec BeautifulSoup
Maintenant que tu as récupéré le contenu, tu peux l’analyser avec BeautifulSoup. Cette étape transforme le HTML brut en une structure facile à explorer :
from bs4 import BeautifulSoup

soup = BeautifulSoup(page.text, "html.parser")

# Exemple : afficher le titre de la page
print(soup.title.string)
Étape 4 : Extraire des données spécifiques (titres, liens, etc.)
Grâce à BeautifulSoup, tu peux cibler des balises HTML précises : titres, liens, paragraphes, etc. Deux exemples parmi les plus courants :
# Extraire tous les titres <h2>
for titre in soup.find_all("h2"):
    print(titre.get_text())

# Extraire tous les liens <a>
for lien in soup.find_all("a"):
    print(lien["href"])
Étape 5 : Sauvegarder les données (CSV, JSON)
Une fois tes données extraites, tu peux les enregistrer dans un fichier pour les réutiliser plus tard. Le format CSV convient aux tableaux, le JSON aux données structurées.
Exemple en CSV :
import csv

titres = [titre.get_text() for titre in soup.find_all("h2")]

with open("resultats.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["Titre"])
    for t in titres:
        writer.writerow([t])
Exemple en JSON :
import json

liens = [lien["href"] for lien in soup.find_all("a")]

with open("liens.json", "w", encoding="utf-8") as f:
    json.dump(liens, f, indent=4, ensure_ascii=False)
Ce tutoriel vise un petit projet, comme le scraping d’un site statique. En pratique, tu vas vite rencontrer des défis plus avancés :
- Gérer la pagination : boucler sur plusieurs pages pour tout récupérer.
- Gérer les formulaires : envoyer des données via une requête POST pour obtenir un résultat filtré.
- Contourner les restrictions : ajouter un en-tête d’identification réaliste et passer par des proxies pour éviter d’être bloqué.
Pourquoi faire du web scraping avec Python ?
Le web scraping avec Python t’ouvre de nombreuses possibilités concrètes. Voici les usages qui rendent cette pratique vraiment utile au quotidien.
- Suivi de prix et e-commerce : tu récupères des fiches produits pour surveiller l’évolution des tarifs, comparer les offres des concurrents et repérer les meilleures opportunités en temps réel.
- Analyse des avis clients : tu collectes les commentaires sur plusieurs sites pour dégager des tendances, comprendre les attentes des consommateurs et améliorer un produit ou un service.

- Agrégation de contenu : tu centralises les articles de blogs ou les actualités venus de plusieurs sources pour créer une plateforme toujours à jour.
- Recherche et veille : tu rassembles des données pour des études, tu surveilles des publications ou tu gardes un œil sur un secteur précis.
En pratique, le web scraping t’évite des heures de copier-coller manuel. Un seul script bien conçu récupère et met à jour tes données automatiquement, à la fréquence que tu choisis.
Quelles sont les bonnes pratiques pour du web scraping avec Python ?
Le web scraping ne consiste pas seulement à extraire des données. Il faut aussi le faire de façon efficace, responsable et durable, sinon tu risques d’être bloqué rapidement. Voici les règles à appliquer :
- Respecter le fichier robots.txt : présent à la racine d’un site (ex. exemple.com/robots.txt), il t’indique les pages autorisées ou interdites au scraping. Consulte-le avant de lancer ton script.
- Adopter un rythme de requêtes raisonnable : ajoute une pause entre chaque requête pour éviter de surcharger le serveur et de te faire bannir.
- Utiliser un User-Agent pertinent : renseigne un en-tête User-Agent qui identifie clairement ton robot, plutôt que la valeur par défaut de requests, souvent bloquée d’office.
- Gérer les erreurs et les exceptions : entoure tes requêtes d’un bloc de gestion d’erreurs. Une page indisponible ne doit pas faire planter tout ton programme.
- Utiliser des proxies et une rotation d’IP : sur de gros volumes, faire tourner plusieurs adresses IP évite qu’une seule soit repérée puis bloquée.
- Minimiser le nombre de requêtes : ne récupère que les pages dont tu as vraiment besoin. Moins de requêtes, c’est moins de charge serveur et moins de risques d’être détecté.
- Rester transparent : quand c’est possible, indique une adresse e-mail de contact dans ton User-Agent. L’administrateur du site peut ainsi te joindre au lieu de te bloquer.
- Séparer l’extraction et la sauvegarde : récupère d’abord les données, puis stocke-les dans un fichier CSV ou une base. Si le traitement échoue, tu ne perds pas ta collecte.
- Utiliser des sélecteurs robustes : privilégie des attributs stables comme id ou data-* plutôt que des classes CSS qui changent souvent. Ton script résistera mieux aux mises à jour du site.
- Documenter ton code : commente les étapes clés et note la date de ton scraping. La structure d’une page évolue, et tu comprendras plus vite quoi corriger le jour où ça casse.
FAQ
Quel est le meilleur framework pour le web scraping en Python ?
Il n’existe pas de « meilleur » framework unique, car tout dépend de la complexité de ton projet.

- Pour des extractions simples, Requests et BeautifulSoup suffisent largement.
- Quand un site utilise beaucoup de JavaScript, tu passes à Selenium ou Playwright.
- Enfin, pour un projet de grande envergure, Scrapy reste le plus adapté grâce à ses performances et sa structure robuste.
Comment scraper un site web en Python ?
Le processus repose sur trois étapes principales :
- Tu envoies une requête HTTP vers la page ciblée.
- Tu analyses la structure HTML reçue.
- Tu extrais les données qui t’intéressent, puis tu les sauvegardes.
Quel est le rôle du web scraper ?
Le rôle d’un web scraper est de parcourir automatiquement les pages web pour en extraire des données précises : textes, prix, images ou liens. Il agit comme un intermédiaire entre le site et toi, en transformant l’information brute en données exploitables.

Comment utiliser BeautifulSoup en Python ?
BeautifulSoup est une bibliothèque conçue pour analyser le code HTML d’une page et retrouver facilement les balises qui contiennent les informations à extraire. Concrètement, tu combines une requête HTTP avec Requests, puis tu parses le contenu avec BeautifulSoup pour naviguer dans la structure et récupérer les données voulues.
Comment scraper un site web avec du contenu dynamique en JavaScript ?
Certains sites reposent fortement sur JavaScript pour afficher leur contenu. Dans ce cas, les solutions classiques comme Requests ne suffisent plus. Tu dois alors utiliser des outils capables de simuler un vrai navigateur, comme Selenium ou Playwright, pour charger et interagir avec la page.
Quel est le langage le plus utilisé pour le web scraping ?
Python est aujourd’hui le langage le plus populaire pour le web scraping, grâce à sa simplicité et à la richesse de ses bibliothèques spécialisées. Cela dit, tu peux aussi automatiser l’extraction de données avec PHP, même si cette technique reste moins répandue.
Est-ce que le web scraping est légal ?
La légalité du web scraping est une question complexe. Tout dépend de la façon dont tu le pratiques, du respect des conditions d’utilisation des sites et de la nature des données collectées. En France, le web scraping est toléré dans certains cas, mais il peut devenir illégal s’il viole les droits d’accès, les conditions d’utilisation d’un site ou la législation sur les données personnelles.
Bref, le web scraping avec Python ouvre un monde de possibilités incroyables ! Et toi, quelles sont tes expériences ou tes questions ? N’hésite pas à partager dans les commentaires, on a hâte de te lire !







 FR