Le web scraping, c’est l’automatisation de la collecte de données sur des sites web. Un programme appelé scraper visite les pages, lit leur code HTML et en extrait les informations utiles : prix, contacts, avis ou contenu d’articles.
Voici comment ça marche, à quoi ça sert et comment t’y mettre, avec ou sans Python.
Web scraping : c’est quoi ?

Tout commence avec un programme automatisé appelé bot de web scraping. Il agit comme un internaute, mais à grande échelle et de manière automatique. Concrètement, il envoie une requête HTTP à une page web, exactement comme si tu l’ouvrais dans ton navigateur, puis analyse la structure du document HTML ou XML pour en extraire les données utiles.
Le processus se déroule en trois grandes étapes :
- Récupération de la page : le scraper accède à l’URL cible, comme un visiteur classique.
- Analyse de la page : à l’aide d’un parser, il lit le code du site pour repérer où se trouvent les informations intéressantes.
- Extraction des données : il récupère précisément ce dont il a besoin, par exemple les prix, les titres, les avis ou les adresses.
Les données collectées sont ensuite stockées dans un fichier ou une base de données. Selon les besoins, le format peut être un tableur, un fichier CSV ou du JSON, prêt pour l’analyse.
Certains sites affichent leur contenu directement dans le HTML : un scraper classique suffit pour les analyser. D’autres génèrent leurs informations via JavaScript et ne les chargent qu’après l’ouverture de la page. Dans ce cas, il faut un robot capable de simuler un vrai navigateur pour collecter les données.
Pourquoi faire du web scraping ?
Le web scraping n’est pas qu’un gadget technique. C’est un vrai outil stratégique pour collecter des données à grande échelle depuis n’importe quel site. Tu automatises la collecte d’informations qui te prendrait des heures à la main. Voici les usages les plus courants :
- Analyse concurrentielle : suivre les prix, les nouveautés et les promos d’un concurrent sur son site, sans intervention manuelle. Idéal pour la veille tarifaire dans l’e-commerce.
- Génération de leads : récupérer automatiquement des contacts ciblés depuis des annuaires ou des réseaux professionnels.
- Recherche académique ou étude de marché : rassembler de gros volumes de données pour des études solides, sans cliquer partout à la main.
- Agrégation de contenu : extraire des informations depuis plusieurs sources et les centraliser dans une base de données. C’est le principe des comparateurs de prix et des logiciels d’indexation.
Dans tous ces cas, l’idée reste la même : gagner du temps et obtenir une base de données exploitable, à jour et prête à l’analyse.
Comment faire du web scraping ?
Trois voies existent selon ton niveau : les logiciels et outils clé en main, le code sur mesure et les extensions de navigateur. Voici comment choisir et te lancer.
1. Avec des outils de web scraping dédiés
De nombreux outils de scraping te permettent de collecter des données sans partir de zéro. Voici trois références solides.
- Bright Data : une plateforme puissante et complète, pensée pour les projets à grande échelle. Elle réunit des proxies, des API et des ressources avancées adaptées aux usages professionnels. Un scraper bien configuré sur cette plateforme peut collecter des millions de données depuis n’importe quel site.
- Octoparse : l’un des logiciels les plus accessibles pour débuter. Son interface te laisse cliquer sur les éléments d’une page pour définir ce que tu veux extraire. Tu obtiens un scraper fonctionnel en quelques minutes, sans une ligne de code.
- Apify : une marketplace de scripts prêts à l’emploi, avec la possibilité de créer tes propres scrapers personnalisés. Cette solution vise surtout les profils techniques et les cas complexes.

Si tu débutes ou que tu veux tester sans investir, la plupart de ces logiciels proposent des essais gratuits ou des formules freemium, de quoi lancer ton scraper sans budget à prévoir dès le départ.
2. Avec des connaissances en programmation
Si tu as des bases en code, le web scraping sur mesure t’offre une liberté totale. Le langage le plus utilisé est Python, grâce à sa simplicité et à son écosystème riche en bibliothèques dédiées. Une bibliothèque, ici, est un ensemble de fonctionnalités déjà codées et réutilisables que tu intègres à tes propres scripts.
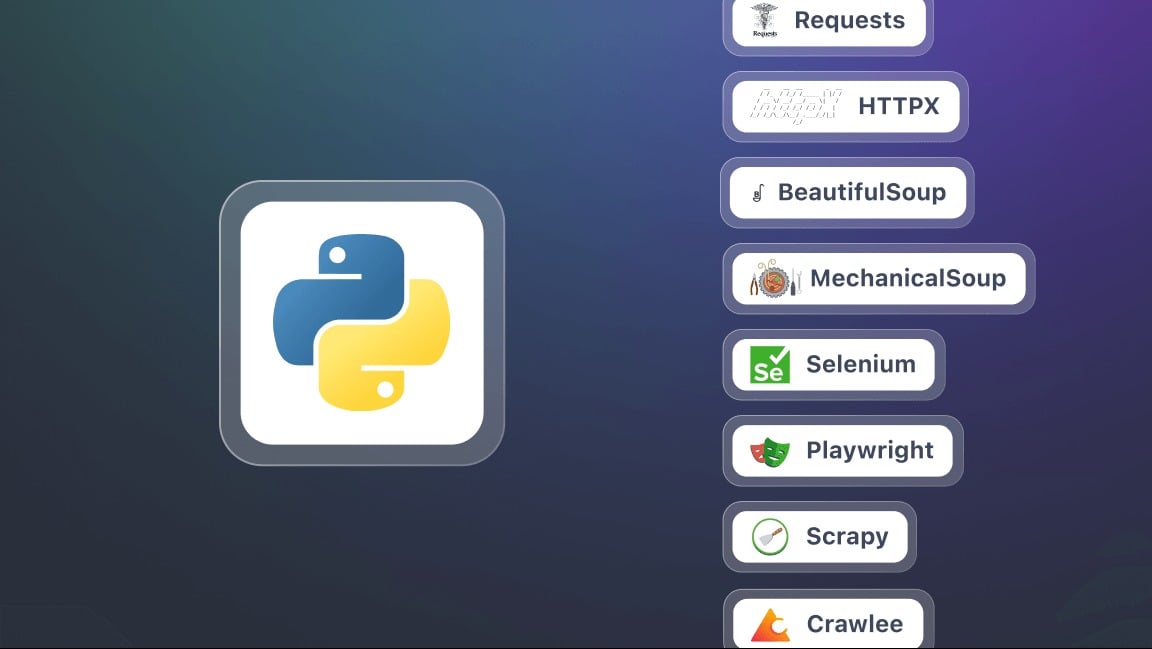
Parmi les bibliothèques les plus populaires pour faire du web scraping avec Python, on retrouve :
- Scrapy : puissante et modulable, idéale pour les projets de grande envergure.
- BeautifulSoup : analyse le code HTML et extrait les données d’une page. Parfaite pour les projets simples.
- Selenium : un framework d’automatisation de navigateurs disponible dans plusieurs langages dont Python. Il permet d’interagir avec des pages web dynamiques pilotées par JavaScript.
Attention : de nombreux sites modernes ne chargent pas tout leur contenu d’un coup. Ils utilisent JavaScript ou AJAX qui affichent les données progressivement. Dans ce cas, adopte un navigateur sans tête (“headless browser“), qui charge la page comme le ferait un vrai utilisateur.
Python n’est pas la seule option. Tu peux aussi faire du scraping en PHP avec les bibliothèques Goutte ou Guzzle, qui envoient des requêtes HTTP et analysent facilement des pages HTML d’un site.
3. Avec des extensions de navigateur
Tu peux faire du web scraping directement depuis ton navigateur grâce à des extensions compatibles avec Chrome, Edge, Firefox ou Opera. Une fois activées, tu cliques sur les éléments d’une page pour sélectionner et extraire les données associées : titres, prix ou images.
Il n’y a aucun besoin de coder. Tout passe par une interface graphique. En quelques clics, tu crées une extraction, tu la prévisualises en temps réel, puis tu exportes les résultats aux formats courants comme CSV, Excel ou JSON.
4. Avec des méthodes avancées de web scraping
Le web scraping évolue vite et de nouvelles techniques apparaissent. Parmi elles, le web scraping avec un agent LLM (Large Language Model).

Ces agents intelligents, basés sur des modèles de langage avancés, sont capables d’analyser la structure d’un site de manière autonome, de comprendre son contenu et d’extraire les données pertinentes, sans règles strictes à définir à l’avance. En pratique, tu y accèdes via des outils qui combinent IA et automatisation.
FAQ
Comment faire du web scraping avec Python ?
Le web scraping avec Python repose sur trois étapes simples :
- Récupérer la page : la bibliothèque requests télécharge tout le code HTML de la page ciblée sur le site.
- Analyser le HTML : un parser comme BeautifulSoup lit la structure du contenu et le rend exploitable.
- Extraire les données : grâce aux sélecteurs HTML, tu récupères les informations utiles (titres, prix, liens).
Concrètement, un script minimal ressemble à ça : tu importes requests et BeautifulSoup, tu fais requests.get(url) pour obtenir le code du site, puis soup.find_all(“h2”) pour cibler les éléments voulus. En quelques lignes, tes scripts collectent déjà des données de manière propre et structurée.
Par exemple, pour un site dynamique piloté par du JavaScript, requests ne suffit pas. Tu passes alors par Selenium, qui automatise un vrai navigateur pour charger la page comme un utilisateur réel et collecter toutes les informations visibles.
Comment faire du web scraping sans se faire bloquer ?
La plupart des sites disposent de mécanismes de protection pour limiter les abus des robots. Pour éviter d’être bloqué, adopte ces bonnes pratiques :
- Utiliser une API dédiée au web scraping quand elle existe.
- Limiter le taux de requêtes pour ne pas surcharger le serveur du site.
- Passer par des proxys pour répartir les adresses IP de tes robots.
- Définir un User-Agent correct qui imite un vrai navigateur.
- Respecter le fichier robots.txt du site, qui indique aux robots les pages autorisées.
Pour les projets à grande échelle, tu peux déployer tes scrapers sur le cloud. Des services comme AWS Lambda ou EC2 te permettent de gérer la collecte de données de manière scalable, avec des ressources adaptées au volume.
Quel est le meilleur outil pour le web scraping ?
Bright Data fait partie des références pour le scraping à grande échelle. Ce logiciel propose un réseau de proxys résidentiels, un centre de contrôle avancé et une gestion automatisée des captchas. Pour un usage sans code, Octoparse est une bonne alternative. Le meilleur outil dépend surtout de ton besoin : volume de données, budget et compétences techniques disponibles.
Le web scraping est-il difficile à apprendre ?
Tout dépend de la méthode que tu choisis :
- Avec des logiciels sans code comme Bright Data ou Octoparse, l’apprentissage reste simple. Ces plateformes sont pensées pour les débutants grâce à une interface en point-and-click.
- Avec la programmation, par exemple en Python ou en PHP, il faut des connaissances techniques. La courbe d’apprentissage est plus longue, mais tu gagnes en flexibilité pour analyser n’importe quel site.
Quelle est la différence entre le web scraping et l’API ?
- Le web scraping extrait les données depuis le code HTML d’une page web. Il simule la navigation humaine pour collecter les informations visibles sur un site.
- Une API (Interface de Programmation Applicative) donne accès directement aux données structurées du site. C’est plus fiable et plus simple, sans avoir à analyser le code HTML.

Le web scraping devient surtout utile quand le site ne propose pas d’API publique. Dans ce cas, un scraper te permet de collecter les données directement depuis les pages.
Est-ce que le web scraping est légal ?
La légalité du web scraping dépend du contexte et du type de données ciblées.
Les réglementations clés
En Europe, le RGPD (Règlement Général sur la Protection des Données) encadre strictement l’utilisation des données personnelles. Collecter des données personnelles sur un site sans consentement est illégal. La protection des données des utilisateurs reste une priorité dans tout projet de scraping.
Le principe de l’open data
Les données publiques peuvent généralement être collectées : horaires, prix, avis publics. Les données privées ou protégées restent soumises à des restrictions.
Les conditions de légalité
Le scraping est légal quand les données sont publiques et utilisées sans abus. Attention au harcèlement et à la violation de la propriété intellectuelle, qui restent interdits. Le RGPD s’applique dès que tu collectes des informations identifiables sur des personnes physiques.
En clair, le web scraping te permet d’extraire des données quand aucune API n’est disponible. Plusieurs méthodes existent, du script Python aux logiciels sans code. Reste toujours dans le cadre légal : données publiques, usage raisonnable et respect du RGPD.







 Français