das Web Scraping, das ist die Automatisierung der Erfassung von Daten auf Websites. Ein Programm namens scraper besucht die Seiten, liest deren HTML-Code und extrahiert daraus die relevanten Informationen: Preise, Kontaktdaten, Bewertungen oder Artikelinhalte.
Hier erfährst du, wie es funktioniert, wozu es dient und wie du damit anfängst – mit oder ohne Python.
Web-Scraping: Was ist das?

Alles beginnt mit einem automatisierten Programm namens Web-Scraping-Bot.
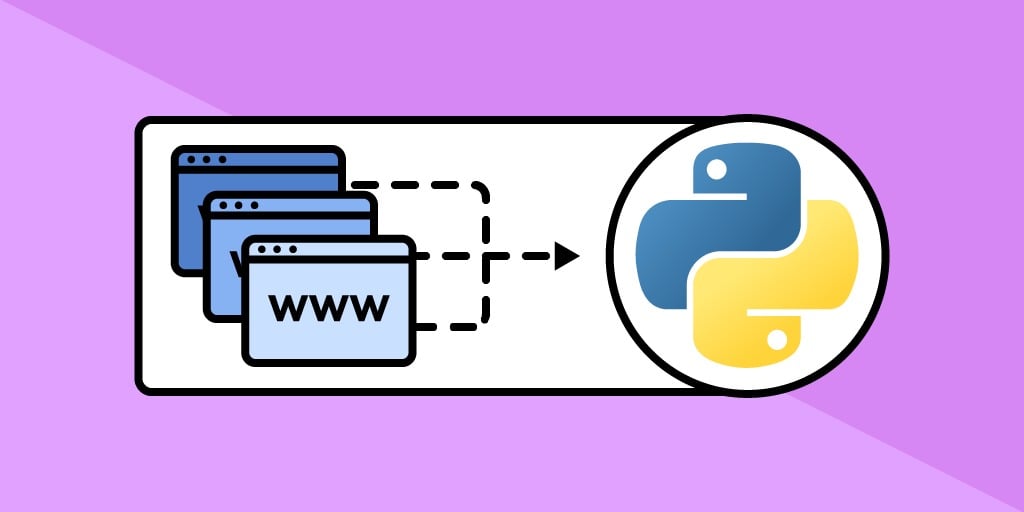
Er verhält sich wie ein Internetnutzer, allerdings in großem Maßstab und automatisch. Konkret sendet er eine HTTP-Anfrage an eine Webseite – genau so, als würdest du sie in deinem Browser öffnen – und analysiert anschließend die Struktur des HTML- oder XML-Dokuments, um die relevanten Daten zu extrahieren.
Der Prozess läuft ab in drei wichtige Etappen :
- Abrufen der Seite : DER scraper ruft die Ziel-URL auf, wie ein gewöhnlicher Besucher.
- Analyse der Seite : mithilfe eines parser, er liest den Quellcode der Website, um herauszufinden, wo sich die relevanten Informationen befinden.
- Extraktion der Daten : Es ruft genau die Informationen ab, die es benötigt, zum Beispiel Preise, Titel, Bewertungen oder Adressen.
Die erfassten Daten werden anschließend in einer Datei oder einer Datenbank. Je nach Bedarf kann das Format eine Tabellenkalkulation oder eine Datei sein CSV oder des JSON, bereit für die Analyse.
Manche Websites zeigen ihre Inhalte direkt im HTML-Code an: ein scraper Ein klassischer Ansatz reicht aus, um sie zu analysieren. Andere generieren ihre Informationen über JavaScript und laden sie erst nach dem Öffnen der Seite. In diesem Fall benötigt man einen Bot, der einen echten Browser simulieren kann, um die Daten zu erfassen.
Warum Web Scraping?
Web-Scraping ist nicht nur eine technische Spielerei. Es ist ein echtes strategisches Instrument um Daten in großem Umfang von jedem beliebigen Standort aus zu erfassen. Du automatisierst die Erfassung von Informationen, die manuell Stunden dauern würde. Hier sind die häufigsten Anwendungsfälle:
- Wettbewerbsanalyse : Preise, Neuheiten und Sonderangebote eines Mitbewerbers auf dessen Website verfolgen, ohne manuelles Eingreifen. Ideal für die Tarifüberwachung im E-Commerce.
- Lead-Generierung : Automatisches Abrufen gezielter Kontakte aus Verzeichnissen oder beruflichen Netzwerken unter Einhaltung der RGPD.
- Wissenschaftliche Forschung oder Marktforschung : Große Datenmengen für fundierte Analysen zusammenstellen, ohne überall manuell klicken zu müssen.
- Aggregation von Inhalten : Informationen aus verschiedenen Quellen extrahieren und in einer Datenbank zusammenführen. Das ist das Prinzip der Preisvergleichsportale sowie Indexierungssoftware.
In all diesen Fällen bleibt der Grundgedanke derselbe: Zeit zu gewinnen Zeit und eine verwertbare, aktuelle und analysefertige Datenbank zu erhalten.
Wie kann man Web Scraping betreiben?
Je nach deinem Niveau gibt es vier Möglichkeiten: die Software und Werkzeuge schlüsselfertig, das codiert maßgeschneidert, die Erweiterungen Browser und KI-Agenten.
1. Mit dedizierten Web-Scraping-Tools
Zahlreiche Scraping-Tools ermöglichen es dir, Daten zu sammeln, ohne ganz von vorne anfangen zu müssen. Hier sind drei zuverlässige Quellen.
- Bright Data : eine leistungsstarke und umfassende Plattform, die speziell für Großprojekte konzipiert wurde. Sie vereint Proxies, APIs und erweiterte Ressourcen, die auf den professionellen Einsatz zugeschnitten sind. Ein scraper Ein auf dieser Plattform richtig konfiguriertes System kann Millionen von Daten von jeder beliebigen Website erfassen.
- Octoparse : Eine der benutzerfreundlichsten Software-Lösungen für Einsteiger. Über die Benutzeroberfläche kannst du einfach auf die Elemente einer Seite klicken, um festzulegen, was du extrahieren möchtest. Du erhältst ein scraper In wenigen Minuten einsatzbereit – ganz ohne Programmiercode.
- Apify : Ein Marktplatz für gebrauchsfertige Skripte, der dir die Möglichkeit bietet, deine eigenen, individuell angepassten Scraper zu erstellen. Diese Lösung richtet sich vor allem an technisch versierte Nutzer und komplexe Anwendungsfälle.

Wenn du gerade erst anfängst oder die Software erst einmal ausprobieren möchtest, ohne Geld zu investieren, bieten die meisten dieser Programme kostenlose Probeaufnahmen oder Formeln Freemium, damit du dein scraper ohne dass von Anfang an ein Budget vorgesehen werden muss.
2. Mit Programmierkenntnissen
Wenn du über Programmiergrundkenntnisse verfügst, dann ist das maßgeschneidertes Web Scraping bietet dir völlige Freiheit. Die am häufigsten verwendete Sprache ist Python, dank seiner Einfachheit und seines umfangreichen Ökosystems an speziellen Bibliotheken. Eine Bibliothek ist in diesem Zusammenhang eine Sammlung bereits programmierter und wiederverwendbarer Funktionen, die du in deine eigenen Skripte einbindest.
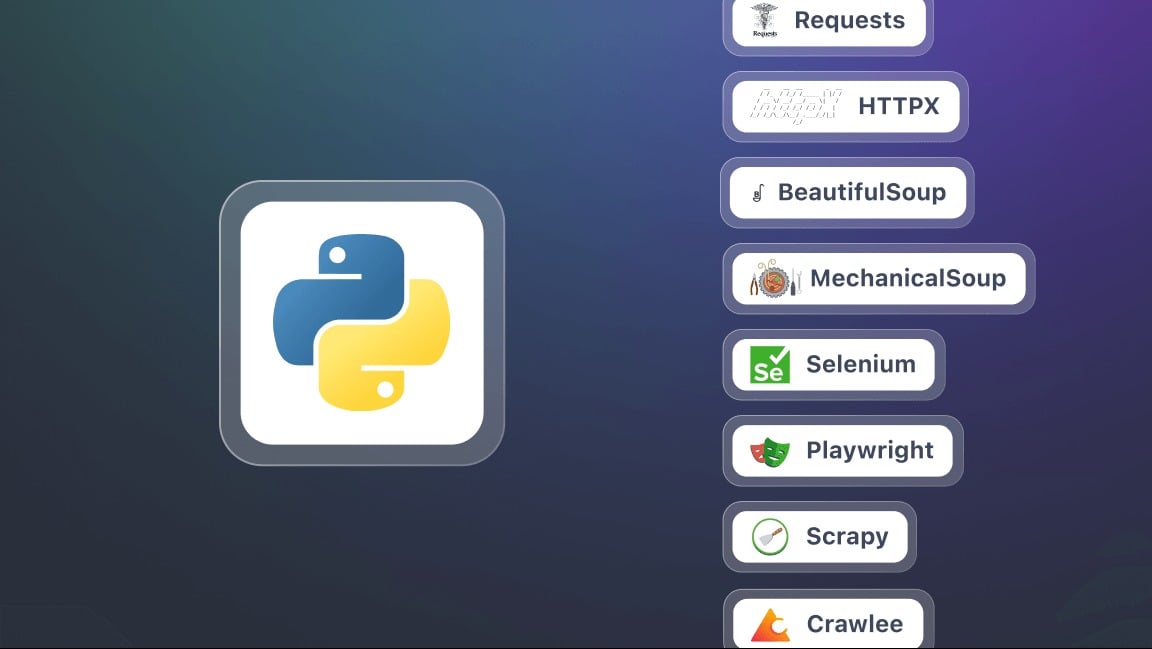
Zu den beliebtesten Bibliotheken, um einen web scraping mit Python:
- Scrapy : leistungsstark und flexibel, ideal für Großprojekte.
- BeautifulSoup : Analysiert den HTML-Code und extrahiert die Daten einer Seite. Ideal für einfache Projekte.
- Selenium : Ein Framework zur Browser-Automatisierung, das in mehreren Sprachen, darunter Python, verfügbar ist. Es ermöglicht die Interaktion mit dynamischen, JavaScript-gesteuerten Webseiten.
Achtung: Viele moderne Websites laden nicht ihren gesamten Inhalt auf einmal. Sie nutzen JavaScript Wo AJAX die die Daten schrittweise anzeigen. In diesem Fall wähle eine kopfloser Segler (« headless browser«), das die Seite so lädt, wie es ein echter Nutzer tun würde.
Python ist nicht die einzige Möglichkeit. Du kannst auch Scraping in PHP mit Guzzle um HTTP-Anfragen zu senden und Symfony DomCrawler um den HTML-Code der Seiten zu analysieren.
3. Mit Browsererweiterungen
Du kannst Web-Scraping betreiben direkt über deinen Browser mithilfe von Erweiterungen, die mit Chrome, Edge, Firefox oder Opera kompatibel sind. Sobald diese aktiviert sind, klickst du auf die Elemente einer Seite, um die zugehörigen Daten auszuwählen und zu extrahieren: Titel, Preise oder Bilder.
Es gibt Man muss nicht programmieren. Alles läuft über eine grafische Benutzeroberfläche. Mit nur wenigen Klicks erstellst du einen Auszug, siehst dir eine Vorschau in Echtzeit an und exportierst die Ergebnisse anschließend in gängige Formate wie CSV, Excel oder JSON.
4. Mit fortgeschrittenen Methoden des Web-Scrapings
Web-Scraping entwickelt sich rasant weiter, und es entstehen immer wieder neue Techniken. Dazu gehört auch das Web-Scraping mit einem LLM-Agenten (Large Language Model).

Diese intelligenten Agenten, die auf fortgeschrittene Sprachmodelle, sind in der Lage, die Struktur einer Website eigenständig zu analysieren, deren Inhalt zu verstehen und relevante Daten zu extrahieren, ohne dass zuvor strenge Regeln festgelegt werden müssen. In der Praxis greifst du darauf über Tools zu, die Folgendes kombinieren: KI und Automatisierung.
Häufig gestellte Fragen
Wie kann man mit Python Web Scraping betreiben?
Web-Scraping mit Python beruht auf drei einfache Schritte :
- Seite abrufen : die Bibliothek requests Lädt den gesamten HTML-Code der Zielseite von der Website herunter.
- HTML analysieren : ein Parser wie BeautifulSoup liest die Struktur des Inhalts aus und macht ihn verwertbar.
- Daten extrahieren : Mithilfe der HTML-Selektoren kannst du die relevanten Informationen (Titel, Preise, Links) abrufen.
Konkret sieht ein einfaches Skript so aus: Du importierst requests und BeautifulSoup, du machst requests.get(url) um den Code der Website abzurufen, und dann soup.find_all(« h2 ») um die gewünschten Elemente anzusprechen. Mit nur wenigen Zeilen sammeln deine Skripte bereits Daten auf saubere und strukturierte Weise.
Beispielsweise bei einer dynamischen Website, die von JavaScript, requests reicht nicht aus. Du gehst dann über Selenium, das einen echten Browser automatisiert, um die Seite wie ein echter Nutzer zu laden und alle sichtbaren Informationen zu erfassen.
Wie kann man Web Scraping betreiben, ohne gesperrt zu werden?
Die meisten Websites verfügen über Schutzmechanismen um den Missbrauch durch Bots einzudämmen. Befolge diese bewährten Vorgehensweisen, um eine Sperrung zu vermeiden:
- Verwenden Sie eine API speziell für Web-Scraping sofern es sie gibt.
- Die Rate der Suchanfragen begrenzen um den Server der Website nicht zu überlasten.
- über Proxys um die IP-Adressen deiner Roboter zu verteilen.
- Definieren Sie einen User-Agent ein ordentlicher Browser, der einen echten Browser nachahmt.
- Die Datei beachten robots.txt der Website, die den Suchmaschinen mitteilt, welche Seiten zugänglich sind.
Bei groß angelegten Projekten kannst du deine Scraper in der Cloud bereitstellen. Dienste wie AWS Lambda Wo EC2 ermöglichen es dir, die Datenerfassung skalierbar zu verwalten, wobei die Ressourcen an das Datenvolumen angepasst sind.
Welches ist das beste Tool für Web Scraping?
Bright Data gehört zu den führenden Anbietern für Scraping in großem Maßstab. Diese Plattform bietet ein Netzwerk aus Residential-Proxys, eine fortschrittliche Kontrollzentrale und eine automatisierte CAPTCHA-Verwaltung. Für die Nutzung ohne Programmierkenntnisse, Octoparse ist eine gute Alternative.
Welches Tool am besten geeignet ist, hängt vor allem von deinen Anforderungen ab: Datenvolumen, Budget und verfügbare technische Kompetenzen.
Ist Web Scraping schwer zu erlernen?
Das hängt ganz davon ab, für welche Methode du dich entscheidest:
- Mit No-Code-Software wie Octoparse, die Bedienung ist dank einer Point-and-Click-Oberfläche dennoch einfach. Bright Data bietet auch gebrauchsfertige Scraper an, richtet sich jedoch eher an technische Teams.
- Mit der Programmierung, zum Beispiel in Python oder PHP, sind technische Kenntnisse erforderlich. Die Einarbeitungszeit ist länger, aber dafür gewinnst du an Flexibilität, um jede beliebige Website zu analysieren.
Was ist der Unterschied zwischen Web Scraping und API?
- das Web Scraping extrahiert Daten aus dem HTML-Code einer Webseite. Es simuliert das Surfverhalten eines Menschen, um die auf einer Website sichtbaren Informationen zu erfassen.
- A API (Application Programming Interface) ermöglicht den direkten Zugriff auf die strukturierten Daten der Website. Das ist zuverlässiger und einfacher, da man den HTML-Code nicht analysieren muss.

Web-Scraping ist vor allem dann nützlich, wenn die Website keine’Öffentliche API. In diesem Fall ein scraper ermöglicht es dir, die Daten direkt von den Seiten zu erfassen.
Ist Web Scraping legal?
Ob Web Scraping legal ist, hängt vom Kontext und der Art der Zieldaten ab.
Die wichtigsten Regelungen
In Europa ist der RGPD (Allgemeine Datenschutzverordnung) regelt die Nutzung von persönliche Daten. Das Erheben personenbezogener Daten auf einer Website ohne gültige Rechtsgrundlage (Einwilligung oder berechtigtes Interesse unter strengen Voraussetzungen) ist rechtswidrig.
Das Datenschutz Die Nutzer bleiben bei jedem Scraping-Projekt eine Priorität.
Öffentliche Daten: kein automatisches Grünlicht
Die Daten nicht personenbezogen Frei zugängliche Informationen (Preise, Öffnungszeiten) können in der Regel erhoben werden, vorbehaltlich der Nutzungsbedingungen der Website und des Datenbankrechts.
Sobald eine Angabe die Identifizierung einer Person ermöglicht, selbst wenn es sich um eine Person des öffentlichen Lebens handelt, gilt Folgendes: RGPD gilt.
Die Bedingungen der Legalität
Scraping ist legal, wenn es die Nutzungsbedingungen der Website, das Urheberrecht, das Datenbankrecht und das RGPD. Belästigung und die Verletzung von Rechten des geistigen Eigentums sind weiterhin verboten.
Einfach ausgedrückt: Mit Web-Scraping kannst du Daten extrahieren, wenn keine API verfügbar ist. Es gibt verschiedene Methoden, von Python-Skript zu No-Code-Software.
Halte dich stets an die gesetzlichen Vorschriften: Einhaltung der Nutzungsbedingungen der Website, angemessene Nutzung und Einhaltung der RGPD.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA