AWS ermöglicht es dir, Web-Scraping zu betreiben, ohne einen Server verwalten zu müssen.
Für einen schlanken und automatisierten Scraper, Lambda + S3 Das reicht völlig aus.
Wenn du Millionen von Seiten parallel bearbeiten möchtest, wechselst du zu Fargate Wo EC2 mit Scrapy.
Welche Rolle spielt AWS beim Web-Scraping?
das Web Scraping ermöglicht Daten automatisch abrufen auf Websites, um sie zu analysieren oder wiederzuverwenden. Verwalten von Millionen Seiten, das Vermeiden von Ausfällen und die Gewährleistung der Zuverlässigkeit können schnell zu einer echten technischen Herausforderung werden, vor allem, wenn du deine Infrastruktur selbst warten musst.
Genau dort …’AWS (Amazon Web Services) kommt ins Spiel. Diese Plattform Amazon-Cloud vereinfacht das Scraping durch die Automatisierung der Serververwaltung und die Unterstützung der Skalierbarkeit, Verfügbarkeit und Sicherheit – ganz für dich, selbst bei riesigen Datenmengen.
Aus folgenden Gründen ist AWS die ideale Lösung für den Einsatz eines Scrapers:
- Skalierbarkeit : Die Plattform skaliert automatisch, um Millionen von Anfragen ohne Unterbrechung zu verarbeiten.
- Zuverlässigkeit : Die Managed Services von AWS minimieren das Ausfallrisiko und gewährleisten einen unterbrechungsfreien Betrieb.
- Kostenkontrolle : mit dem Modell Pay-as-you-go, du zahlst nur das, was du tatsächlich verbrauchst.
- Sicherheit : AWS ergreift umfassende Maßnahmen zum Schutz deiner gespeicherten und übertragenen Daten.
Welche relevanten AWS-Dienste gibt es?
Die Amazon-Cloud bietet eine breite Palette an Diensten, die auf alle Anforderungen im Bereich Web-Scraping zugeschnitten sind. Hier sind die wichtigsten Dienste, die Sie kennen sollten, nach Verwendungszweck geordnet.
Die Berechnung: Wo läuft dein Scraper?
- AWS Lambda : ideal für kleinere Aufgaben und gelegentliches Scraping, ohne dass ein Server verwaltet werden muss. Das ist der Ansatz serverlos par excellence.
- Amazon EC2 : ideal für langwierige oder ressourcenintensive Prozesse. Du mietest eine virtuelle Maschine und du behältst die Kontrolle über die gesamte Konfiguration.
Speicher: Wo du deine Daten ablegst
- Amazon S3 : zur Aufbewahrung der Rohdaten, HTML-Dateien oder Scraping-Ergebnisse in einem Eimer. Jede Datei wird durch eine Schlüssel einzigartig im Bucket S3, was den Zugriff auf die gesammelten Daten und deren Organisation erleichtert.
- Amazon DynamoDB : für die strukturierte Daten die ein sehr schnelles Lesen und Schreiben erfordern.
Die Koordination: Um die einzelnen Schritte miteinander zu verknüpfen
- AWS Step Functions : zur Steuerung komplexer Arbeitsabläufe, bei denen mehrere Funktionen in einer bestimmten Reihenfolge aufeinander folgen müssen.
Zusatzleistungen
- Amazon SQS : zur Verwaltung von Anforderungswarteschlangen und zur Glättung der Datenverarbeitung in großem Maßstab.
- AWS IAM : zur Verwaltung der Zugriffsrechte und zur Festlegung einer Richtlinie genau festlegen, damit dein Scraper nur über die Berechtigungen verfügt, die er tatsächlich benötigt.
In der Praxis umfasst ein einfaches Projekt oft Lambda + S3 + IAM. Für das Scraping in großem Umfang fügst du Folgendes hinzu EC2, SQS und DynamoDB je nach deinen Bedürfnissen.
Wie baut man einen serverlosen Scraper mit AWS Lambda?
Mit AWS Lambda, du musst dich nicht um den Server kümmern: AWS übernimmt die gesamte Infrastruktur, von der Skalierbarkeit an die Wartung. Du gibst einfach deinen Code und die Konfiguration ein. Hier erfährst du Schritt für Schritt, wie du deinen ersten serverlosen Scraper erstellst.
1. Grundlegende Architektur eines serverlosen Scrapers
Bevor du mit dem Programmieren beginnst, überlege dir, wie die verschiedenen AWS-Dienste zusammenarbeiten werden. Drei Entscheidungen bestimmen die Struktur deiner Architektur.
- Auslöser auswählen
Dies ist das Element, das bestimmt, wann dein Code ausgeführt werden soll. Du hast die Wahl zwischen CloudWatch und EventBridge.
- Computer auswählen
Hier wird dein Code in der Cloud ausgeführt. Nimm Lambda für kurze und gelegentliche Aufgaben. Überspringe EC2 Wo Fargate wenn die Arbeit langwierig oder schwer ist.
- Speicher auswählen
Verwende S3 für JSON-, CSV- oder Rohdateien. Wähle DynamoDB wenn du einen schnellen und strukturierten Zugriff auf deine Daten benötigst.
Zusammengefasst: Der Trigger aktiviert Lambda, Lambda führt das Scraping durch, und die Daten landen im S3-Bucket.
2. Vorbereitung der Umgebung
Bevor du mit dem Programmieren beginnst, erteile AWS die erforderlichen Berechtigungen und richte einen Speicherplatz ein.
- Eine Rolle anlegen IAM (Berechtigungen)
- Öffne die Konsole AWS > IAM > Rollen.
- Erstellt eine Rolle speziell für Lambda.
- Erteile ihm zwei wichtige Berechtigungen:
AWSLambdaBasicExecutionRoleum die Protokolle an CloudWatch zu senden, sowie eine S3-Berechtigung, um Dateien in deinen Bucket zu schreiben.
- Bucket erstellen S3 (die Speicherung der Ergebnisse)
- Öffne die Konsole AWS > S3.
- Erstelle einen Bucket und speichere die Sicherheitseinstellungen aktiviert.
Lambda hat nun die Berechtigung, in deinen S3-Bucket zu schreiben, und du hast nun einen Ort, an dem du deine Daten speichern kannst.
3. Der Python-Code für AWS Lambda
Schreib ein Scraper in Python zusammen mit der Bibliothek Requests. Dieses Skript ruft eine Webseite ab und speichert das Ergebnis im S3-Bucket.
- Einfaches Codebeispiel (mit requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # Zu scrapende URL (hier ein einfaches Beispiel)
    url = "https://example.com"
    response = requests.get(url)

 # Statusprüfung
    if response.status_code == 200:
 # Dateiname (mit Zeitstempel, um Kollisionen zu vermeiden)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Hochladen in S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # muss in deinen Lambda-Umgebungsvariablen definiert werden
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"Seite in {filename} gespeichert")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("Fehler beim Scraping")
 }
Anfragen ruft den Inhalt der Webseite ab. boto3 ist die offizielle Bibliothek für die Kommunikation mit AWS. Um die APIs noch besser zu nutzen, kannst du dieses Schema auch auf entfernte Endpunkte anpassen.
- Verwaltung von Abhängigkeiten (requests Wo Scrapy)
Lambda stellt diese Bibliotheken standardmäßig nicht zur Verfügung. Du hast zwei Möglichkeiten.
Option 1: Ein Paket erstellen ZIP
- Erstelle einen Ordner auf deinem Rechner:
mkdir package && cd package pip install requests -t .- Lade deine Datei hoch
lambda_function.pyin diesem Ordner. - Komprimiert das Ganze in
.zipund lade es in Lambda hoch.
Option 2: die Lambda Layers
- Erstellt eine Lambda-Schicht, die Requests enthält (oder Scrapy für fortgeschritteneres Web-Scraping).
- Verbinde diese Ebene mit deiner Lambda-Funktion.
Vorteil : Es ist übersichtlicher, wenn du dieselben Abhängigkeiten in mehreren Funktionen wiederverwendest.
4. Bereitstellung und Test
Jetzt musst du nur noch deinen Code online stellen und überprüfen, ob er funktioniert.
- Code hochladen in Lambda
- Melde dich bei der AWS-Konsole an und rufe den Lambda-Dienst auf.
- Klicke auf Funktion erstellen, und wähle dann Autor von Grund auf.
- Gib deiner Funktion einen Namen (Beispiel:
Scraper-Lambda) und wähle den Python-Laufzeitumgebung 3.12 (oder die Version, die du verwendest). - Ordne die zuvor erstellte IAM-Rolle den S3- und CloudWatch-Berechtigungen zu.
- Auf der Registerkarte Codiert, ausgewählt Hochladen aus > ZIP-Datei und lade deine Datei hoch
lambda_package.zip. - Fügt eine Umgebungsvariable hinzu:
BUCKET_NAME= Name deines S3-Buckets. - Klicke auf Speichern um die Konfiguration deiner Lambda-Funktion zu speichern.
- Funktion testen
- Klicke in deiner Lambda-Funktion auf Prüfen.
- Erstellt ein neues Testereignis mit einem kleinen JSON, zum Beispiel:
{ "url": "https://example.com" }- Klicke auf Speichern, dann auf Prüfen um die Funktion auszuführen.
- Auf der Registerkarte Protokolle, überprüfe den Status: Du solltest einen Code 200 ob alles gut gelaufen ist.
- Geh in deinen S3-Bucket: Dort wird eine Datei angezeigt
scraping_xxxx.html.
Was sind die Lösungen für Web Scraping in großem Maßstab?
Um … zu sammeln Millionen Seiten, brauchst du eine solide Infrastruktur. Bei AWS geht es darum, die Last zu verteilen und mehrere Scraper parallel laufen zu lassen.
1. Scrapy und AWS Fargate/EC2 verwenden
Scrapy ist ein Python-Framework, das sich perfekt für komplexe Projekte eignet. Standardmäßig läuft dein Scraper auf deinem Rechner, was hinsichtlich des Datenvolumens schnell an seine Grenzen stößt. Um die Skalierbarkeit zu erhöhen, hast du auf AWS zwei Möglichkeiten.
AWS Fargate Setze deinen Scrapy-Scraper in Docker-Container, ohne jemals einen Server verwalten zu müssen. Das ist die ideale Lösung für serverloses und skalierbares Scraping. Der Vorgang umfasst drei Schritte:
- Du erstellst deinen eigenen Scrapy-Scraper.
- Du gibst es in einen Behälter Docker.
- Du stellst diesen Container bereit mit Fargate damit es automatisch in großem Umfang ausgeführt wird.
Amazon EC2 ist die Alternative, wenn du mehr Kontrolle über deine Umgebung haben möchtest. Du installierst Python und Scrapy selbst auf einer Instanz und automatisierst dann die Ausführung. Eine Instanz t3.micro entspricht etwa 7,59 $/Monat als On-Demand-Dienst auf us-east-1.
In beiden Fällen werden die extrahierten Daten an einen S3-Bucket, in dem alle deine gesammelten Dateien zentral gespeichert werden.
2. Verteilte Scraping-Architektur
Um wirklich parallel zu arbeiten, stützt du dich auf Amazon SQS (Simple Queue Service). Das Prinzip ist einfach: Du speicherst alle deine URLs in SQS, und mehrere Funktionen Lambda oder mehrere Container (auf EC2 oder Fargate) rufen diese URLs ab parallel um das Scraping zu starten. Jede Lambda-Funktion liest eine URL aus der Warteschlange, führt das Scraping durch und speichert das Ergebnis in einem S3-Bucket mit einem eindeutigen Schlüssel.
Diese Architektur ermöglicht es dir, die Arbeit verteilen und gleichzeitig Tausende von Seiten zu durchlaufen. Das ist die Grundlage für einen leistungsstarken, verteilten Scraper in der AWS-Cloud. Bei Seiten mit dynamischen Inhalten, die per Ajax geladen werden, musst du deinen Ansatz anpassen, um die Daten nach dem Rendern zu erfassen.
3. Proxys und blockierte Anfragen verwalten
Viele Websites blockieren Scraper, indem sie ein ungewöhnlich hohes Anfragevolumen erkennen oder bestimmte Anfragen herausfiltern IP-Adressen. Es gibt zwei Möglichkeiten, diese Sperre zu umgehen:
- Das IP-Adressrotation, über AWS oder spezialisierte Dienste.
- Die Verwendung von Drittanbieter-Proxys wie Bright Data Wo ScrapingBee, die automatisch die Traktionskontrolle und das Antiblockiersystem steuern.
Welche Lösungen gibt es für häufige Probleme beim Web Scraping mit AWS?
Beim Web-Scraping sind Hindernisse nie weit entfernt: Netzwerkfehler, Blockaden, unvorhergesehene Kosten. Die gute Nachricht ist, dass AWS bereits Dienste anbietet, mit denen sich diese Probleme schnell diagnostizieren und beheben lassen.
Protokolle mit Amazon CloudWatch analysieren
Wenn eine Lambda-Funktion oder eine EC2-Instanz ausfällt, ist es schwierig, die Fehlerursache zu ermitteln, wenn man keinen Einblick in die Ausführung hat. Mit Amazon CloudWatch, alle Protokolle werden zentral erfasst und können über die Konsole eingesehen werden. Dort lassen sich häufige Fehler schnell erkennen:
- Fristüberschreitungen : Die Antwort auf die Anfrage hat zu lange gedauert.
- Fehler 403 : Die Website blockiert deinen Scraper.
- Fehler 429 : Es wurden zu viele Anfragen auf einmal gesendet.
- Speichermangel oder Fehlende Python-Abhängigkeiten im Lambda-Code.
Konfiguriere CloudWatch-Warnmeldungen um automatisch benachrichtigt zu werden, sobald ein Fehler zu häufig auftritt.
Behandlung von Abfragefehlern
Ein Scraper kann komplett abstürzen, wenn auch nur eine einzige Anfrage fehlschlägt. Das A und O: Umgib deine Python-Aufrufe mit try…except um zu verhindern, dass das Programm aufgrund eines einzelnen Fehlers abrupt beendet wird.
Richte anschließend folgende Maßnahmen ein: Strategien für erneute Versuche :
- Versuche es nach einer kurzen Pause erneut und verlängere dann schrittweise die Wartezeit (exponentieller Rückgang).
- Wechselt zwischen mehreren Proxies falls eine IP-Adresse gesperrt wird.
- Passe die Häufigkeit deiner Anfragen an, um unauffällig zu bleiben und unter dem Radar zu bleiben.
Kostenüberwachung
Ein schlecht optimierter Scraper kann Tausende von Lambda-Aufrufen generieren oder eine große EC2-Instanz unnötig laufen lassen. Um die Kontrolle zu behalten, verwende AWS Billing und überwacht den Verbrauch jedes einzelnen Dienstes.
Ein paar Größenordnungen, damit du dir ein Bild machen kannst:
- Lambda : ungefähr 0,20 $ pro Million Abfragen, zuzüglich der in Go-Sekunden abgerechneten Laufzeit. Die kostenlose Nutzungsstufe deckt ab 1 Million kostenlose Abfragen und 400.000 Go-Sekunden jeden Monat, dauerhaft. Die extrahierten Daten werden in einer S3-Bucket ; behalten Sie das gespeicherte Datenvolumen im Auge, da S3 auch die gespeicherte Datenmenge in Rechnung stellt.
- EC2 t3.micro : etwa 7,59 $/Monat als On-Demand in us-east-1, deutlich weniger mit Spot-Instanzen.
Was die Optimierung angeht, gibt es ein paar einfache Tipps:
- Für Lambda: Reduziere den zugewiesenen Speicher und begrenze die Ausführungszeit (Höchstens 15 Minuten (bei Aufruf wird die Funktion danach automatisch beendet, und du musst auf EC2 oder Fargate umschalten).
- Für EC2: Wähle eine Instanz, die zu deiner Auslastung passt, oder wechsle zu Spot-Instanzen (günstiger, können aber jederzeit unterbrochen werden).
- Aktiviert AWS-Budgetwarnungen um benachrichtigt zu werden, bevor ein von dir selbst festgelegter Schwellenwert überschritten wird.
Häufig gestellte Fragen
Ist Web Scraping mit AWS legal?
Das hängt von deinem konkreten Fall ab. Die Legalität von Web Scraping hängt vom jeweiligen Land, der Art der erhobenen Daten und der Art ihrer Nutzung ab. In Frankreich kann das Scraping öffentlicher Daten unter bestimmten Bedingungen zulässig, aber das geschieht nicht automatisch.
Drei Punkte, die du vor dem Start deines Scrapers überprüfen solltest:
- Das Nutzungsbedingungen der Zielwebsite, die das Scraping untersagen können.
- das Datenbankrecht, das die Investition des Produzenten auch bei öffentlich zugänglichen Daten schützt.
- das DSGVO, die gilt, sobald personenbezogene Daten betroffen sind, auch wenn diese veröffentlicht wurden.
Was AWS betrifft, bist du weiterhin für die Konformität deiner Aktivitäten verantwortlich. Lass dein Projekt im Zweifelsfall von einem Fachmann prüfen.
Was ist der beste Ansatz für Web Scraping mit AWS?
Das hängt ganz von der Größe und der Dauer deines Projekts ab:
- AWS Lambda : Für gelegentliches Scraping empfiehlt sich eine Ausführung unter 15 Minuten und einige hundert URLs. Das kostenlose Nutzungsstufe deckt ab 1 Million Anfragen pro Monat, dauerhaft.
- EC2 : für langwierige Aufgaben (mehr als 15 Minuten) oder kontinuierliches Scraping. Eine Instanz t3.micro liegt bei etwa 7,59 $/Monat als On-Demand-Angebot.
- Fargate : für eine Parallelisierung in großem Maßstab, ohne dass Server verwaltet werden müssen.
Konkret: Beginne zunächst auf Lambda, um zu testen, und wechsle dann zu EC2 oder Fargate, wenn das Volumen steigt. Wenn du einen Code-freien Ansatz bevorzugst, gibt es Tools wie Instant Data Scraper ermöglichen es, Daten direkt über deinen Browser zu erfassen.
Kann ich Selenium auf AWS Lambda für das Web-Scraping verwenden?
Ja, aber die Umsetzung ist etwas aufwendiger. Selenium und Browser ohne grafische Benutzeroberfläche wie Puppeteer sind nützlich für Seiten mit JavaScript auslesen. Ihre Konfiguration auf Lambda erfordert jedoch einige Optimierungen: Paketgröße, Abhängigkeitsverwaltung und zugewiesener Speicher.
Wie kann ich verhindern, dass ich von einer Website auf AWS gesperrt werde?
Websites erkennen Scraper oft und blockieren deren Anfragen. Hier sind einige wirksame Strategien, um die Risiken zu verringern:
- Den User-Agent-Header regelmäßig ändern um menschlicher zu wirken.
- Zufällige Verzögerungen hinzufügen zwischen jeder Anfrage.
- Rotierende Proxys verwenden um deine IP-Adresse zu ändern.
- Die Anzahl der Anfragen begrenzen die gleichzeitig von derselben IP-Adresse gesendet wurden.
Wie lassen sich die gescrapten Daten in eine Datenbank integrieren?
Sobald die Daten erfasst sind, kannst du sie in eine relationale Datenbank einfügen, wie zum Beispiel Amazon RDS (MySQL, PostgreSQL usw.).
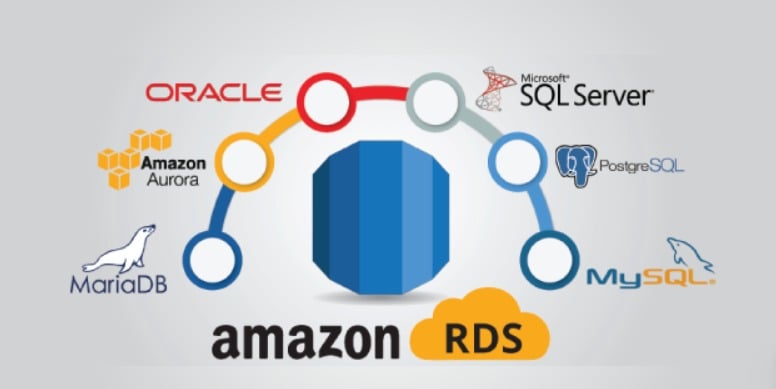
Die bewährte Vorgehensweise ist Daten bereinigen und strukturieren vor dem Einfügen. Anschließend kannst du Integration automatisieren über ein Python-Skript oder eine Pipeline, um eine bereinigte und einsatzbereite Datenbank zu erhalten.
Durch die Kombination der Leistungsfähigkeit von’AWS und das Bewährte Praktiken beim Scraping, kannst du deine Daten effizient und sicher extrahieren. Falls du bei einem Schritt nicht weiterkommst, zögere nicht, uns deine Fragen in den Kommentaren zu stellen!








 Deutsch