AWS ti permette di eseguire il web scraping senza dover gestire un server.
Per uno scraper leggero e automatizzato, Lambda + S3 è più che sufficiente.
Per milioni di pagine in parallelo, si passa a Fargate Dove EC2 insieme a Scrapy.
Qual è il ruolo di AWS nel web scraping?
il scraping del web permette recuperare automaticamente i dati su siti web per analizzarli o riutilizzarli. Gestire i milioni di pagine, evitare i blocchi e garantire l'affidabilità può diventare rapidamente un vero rompicapo tecnico, soprattutto se devi occuparti personalmente della manutenzione della tua infrastruttura.
È proprio lì che…’AWS (Amazon Web Services) entra in gioco. Questa piattaforma cloud di Amazon semplifica lo scraping automatizzando la gestione dei server e occupandosi della scalabilità, la disponibilità e la sicurezza garantite per te, anche con enormi volumi di dati.
Ecco perché AWS è la soluzione ideale per avviare uno scraper:
- Scalabilità : la piattaforma scala automaticamente la propria capacità per gestire milioni di richieste senza interruzioni.
- Affidabilità : i servizi gestiti di AWS riducono il rischio di interruzioni e garantiscono un funzionamento continuo.
- Costi sotto controllo : con il modello pay-as-you-go, paghi solo ciò che consumi effettivamente.
- Sicurezza : AWS adotta misure rigorose per proteggere i tuoi dati archiviati e trasmessi.
Quali sono i servizi AWS più rilevanti?
Il cloud di Amazon offre un’ampia gamma di servizi adatti a ogni esigenza di web scraping. Ecco i principali da conoscere, classificati in base all’utilizzo.
Il calcolo: dove gira il tuo scraper
- AWS Lambda : ideale per piccoli compiti e attività di scraping occasionali, senza dover gestire un server. È l'approccio serverless per eccellenza.
- Amazon EC2 : perfetto per processi lunghi o che richiedono molte risorse. Si noleggia un macchina virtuale e mantieni il controllo su tutta la configurazione.
L'archiviazione: dove conservi i tuoi dati
- Amazon S3 : per conservare i dati grezzi, i file HTML o i risultati dello scraping in un bucket. Ogni file è identificato da un key unico nel bucket S3, il che facilita l'accesso e l'organizzazione dei dati raccolti.
- Amazon DynamoDB : per i dati strutturati che richiedono operazioni di lettura e scrittura molto veloci.
L'orchestrazione: per concatenare le fasi
- AWS Step Functions : per gestire flussi di lavoro complessi, quando diverse funzioni devono susseguirsi in un ordine preciso.
I servizi aggiuntivi
- Amazon SQS : per gestire le code delle richieste e ottimizzare l'elaborazione dei dati su larga scala.
- AWS IAM : per gestire gli accessi e definire una politica specifica, in modo che il tuo scraper disponga solo dei diritti di cui ha effettivamente bisogno.
In pratica, un progetto semplice spesso combina Lambda + S3 + IAM. Per lo scraping su larga scala, aggiungi EC2, SQS e DynamoDB a seconda delle tue esigenze.
Come costruire uno scraper serverless con AWS Lambda?
Insieme a AWS Lambda, non devi occuparti del server: AWS gestisce l'intera infrastruttura, a partire dalla scalabilità al manutenzione. Devi solo fornire il tuo codice e la configurazione. Ecco come creare il tuo primo scraper serverless, passo dopo passo.
1. Architettura di base di uno scraper serverless
Prima di iniziare a programmare, immagina come i diversi servizi AWS interagiranno tra loro. Tre scelte determinano la struttura della tua architettura.
- Scegliere il trigger
È l'elemento che determina quando il tuo codice deve essere eseguito. Puoi scegliere tra CloudWatch e EventBridge.
- Scegliere il computer
È il luogo in cui il tuo codice viene eseguito nel cloud. Prendi Lambda per attività brevi e sporadiche. Passa a EC2 Dove Fargate se il lavoro è lungo o pesante.
- Scegliere lo spazio di archiviazione
Utilizza S3 per file JSON, CSV o in formato grezzo. Scegli DynamoDB se hai bisogno di un accesso rapido e strutturato ai tuoi dati.
In sintesi: il trigger attiva Lambda, Lambda esegue lo scraping e i dati finiscono nel bucket S3.
2. Preparazione dell'ambiente
Prima di iniziare a programmare, concedi ad AWS le autorizzazioni necessarie e crea uno spazio di archiviazione.
- Crea un ruolo IAM (i permessi)
- Vai alla console AWS > IAM > Ruoli.
- Crea un ruolo dedicato a Lambda.
- Concedigli due autorizzazioni fondamentali:
AWSLambdaBasicExecutionRoleper inviare i log a CloudWatch e un'autorizzazione S3 per scrivere i file nel tuo bucket.
- Crea un bucket S3 (la memorizzazione dei risultati)
- Vai alla console AWS > S3.
- Crea un bucket e conserva i parametri di sicurezza attivati.
Lambda ora ha i permessi per scrivere nel tuo bucket S3 e hai uno spazio pronto per archiviare i tuoi dati.
3. Il codice Python per AWS Lambda
Scrivi un scraper in Python con la biblioteca Requests. Questo script recupera una pagina web e salva il risultato nel bucket S3.
- Esempio di codice semplice (con requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # URL da scrappare (qui un semplice esempio)
    url = "https://example.com"
    response = requests.get(url)

 # Verifica dello stato
    if response.status_code == 200:
 # Nome del file (con timestamp per evitare conflitti)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Invio su S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # da definire nelle variabili d'ambiente Lambda
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"Pagina salvata in {filename}")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("Errore durante lo scraping")
 }
richieste recupera il contenuto della pagina web. boto3 è la libreria ufficiale per comunicare con AWS. Per approfondire l'uso delle API, puoi adattare questo stesso schema agli endpoint remoti.
- Gestione delle dipendenze (requests Dove Scrapy)
Lambda non fornisce queste librerie di default. Hai due opzioni.
Opzione 1: creare un pacchetto ZIP
- Crea una cartella sul tuo computer:
mkdir package && cd package pip install requests -t .- Carica il tuo file
lambda_function.pyin questo fascicolo. - Comprimi il tutto in
.zipe caricalo su Lambda.
Opzione 2: utilizzare i Lambda Layers
- Crea un livello Lambda contenente Requests (o Scrapy per operazioni di scraping più avanzate).
- Associa questo livello alla tua funzione Lambda.
Vantaggio : è più ordinato se riutilizzi le stesse dipendenze in più funzioni.
4. Implementazione e test
Non ti resta che pubblicare il tuo codice online e verificare che funzioni.
- Caricare il codice in Lambda
- Accedi alla console AWS e vai al servizio Lambda.
- Fare clic su Crea funzione, poi scegli Autore da zero.
- Assegna un nome alla tua funzione (esempio:
scraper-lambda) e scegli il runtime Python 3.12 (o la versione che usi). - Associa il ruolo IAM creato in precedenza alle autorizzazioni S3 e CloudWatch.
- Nella scheda codificato, scegli Carica da > file .zip e importa il tuo file
lambda_package.zip. - Aggiungi una variabile d'ambiente:
BUCKET_NAME= nome del tuo bucket S3. - Fare clic su Salva per salvare la configurazione della tua funzione Lambda.
- Testare la funzione
- Nella tua funzione Lambda, clicca su Test.
- Crea un nuovo evento di test con un piccolo file JSON, ad esempio:
{ "url": "https://example.com" }- Fare clic su Salvapoi su Test per eseguire la funzione.
- Nella scheda Registri, controlla lo stato: dovresti vedere un codice 200 se è andato tutto bene.
- Vai nel tuo bucket S3: vedrai apparire un file
scraping_xxxx.html.
Quali sono le soluzioni per il web scraping su larga scala?
Per raccogliere dei milioni di pagine, ti serve un'infrastruttura solida. L'idea su AWS è quella di distribuire il carico e avviare diversi scraper in parallelo.
1. Utilizzo di Scrapy e AWS Fargate/EC2
Scrapy è un framework Python perfetto per i progetti complessi. Di default, il tuo scraper gira sul tuo computer, il cui volume è presto limitato. Per scalare il sistema, hai due opzioni su AWS.
AWS Fargate lancia il tuo scraper Scrapy in container Docker, senza dover mai gestire un server. È la soluzione ideale per uno scraping serverless e scalabile. Il procedimento si articola in tre fasi:
- Crea il tuo scraper Scrapy.
- Lo metti in un contenitore Docker.
- Si distribuisce questo container con Fargate in modo che venga eseguito automaticamente su larga scala.
Amazon EC2 è l'alternativa se vuoi avere un maggiore controllo sul tuo ambiente. Installi tu stesso Python e Scrapy su un'istanza, quindi automatizzi l'esecuzione. Un'istanza t3.micro corrisponde a circa 7,59 $/mese in modalità On-Demand su us-east-1.
In entrambi i casi, i dati estratti vengono inviati a un bucket S3, che centralizza l'archiviazione di tutti i tuoi file raccolti.
2. Architettura di scraping distribuita
Per ottenere una vera parallelizzazione, ti affidi a Amazon SQS (Simple Queue Service). Il principio è semplice: inserisci tutti i tuoi URL in SQS e diverse funzioni Lambda oppure più container (su EC2 o Fargate) recuperano questi URL in parallelo per avviare lo scraping. Ogni funzione Lambda legge un URL dalla coda, esegue lo scraping e memorizza il risultato in un bucket S3 con una chiave univoca.
Questa struttura ti permette di distribuire il lavoro e di elaborare migliaia di pagine contemporaneamente. È la base di uno scraper distribuito ed efficiente sul cloud AWS. Per le pagine con contenuti dinamici caricati tramite Ajax, dovrai adattare il tuo approccio per acquisire i dati dopo il rendering.
3. Gestire i proxy e le richieste bloccate
Molti siti bloccano gli scraper rilevando un volume anomalo di richieste o filtrando alcune Indirizzi IP. Esistono due soluzioni per aggirare questo blocco:
- Il rotazione degli indirizzi IP, tramite AWS o servizi specializzati.
- L'uso di proxy di terze parti come Dati luminosi Dove ScrapingBee, che gestiscono automaticamente la rotazione e il sistema antibloccaggio.
Quali sono le soluzioni ai problemi più comuni di web scraping con AWS?
Quando si fa web scraping, gli ostacoli non mancano mai: errori di rete, blocchi, costi imprevisti. La buona notizia è che AWS offre già i servizi necessari per individuare e risolvere rapidamente questi problemi.
Analisi dei log con Amazon CloudWatch
Quando una funzione Lambda o un’istanza EC2 non funziona correttamente, è difficile individuare l’origine dell’errore senza poter monitorare l’esecuzione. Con Amazon CloudWatch, tutti i log sono centralizzati e consultabili dalla console. Qui puoi individuare rapidamente gli errori più frequenti:
- Ritardi rispetto alle scadenze : la richiesta ha impiegato troppo tempo per rispondere.
- Errori 403 : il sito blocca il tuo scraper.
- Errori 429 : troppe richieste inviate contemporaneamente.
- Mancanza di memoria o dipendenze Python mancanti nel codice Lambda.
Configura i avvisi CloudWatch per ricevere una notifica automatica non appena un errore si ripete troppo spesso.
Gestione degli errori delle richieste
Uno scraper può bloccarsi completamente se anche una sola richiesta fallisce. La regola di base: racchiudi le tue chiamate in Python con try…except per evitare che il programma si arresti bruscamente a causa di un errore isolato.
Successivamente, metti in atto delle strategie di riprova :
- Riprova dopo un breve intervallo, poi aumenta gradualmente il tempo di attesa (declino esponenziale).
- Alterna tra diversi deleghe se un indirizzo IP viene bloccato.
- Regola la frequenza delle tue richieste per mantenere un profilo basso e passare inosservato.
Monitoraggio dei costi
Uno scraper non ottimizzato può generare migliaia di chiamate Lambda o lasciare in esecuzione un’istanza EC2 di grandi dimensioni senza motivo. Per mantenere il controllo, usa AWS Billing e monitora il consumo di ciascun servizio.
Qualche ordine di grandezza per farti un'idea:
- Lambda : circa 0,20 $ per milione di richieste, più il tempo di esecuzione fatturato in Go-secondi. Il livello gratuito copre 1 milione di richieste gratuite e 400.000 Go-secondi ogni mese, su base continuativa. I dati estratti vengono archiviati in un bucket S3 ; controlla il volume archiviato, poiché S3 addebita anche la quantità di dati conservati.
- EC2 t3.micro : circa 7,59 $/mese in On-Demand su us-east-1, molto meno con istanze Spot.
Per quanto riguarda l'ottimizzazione, ecco alcuni semplici accorgimenti:
- Per Lambda: riduci la memoria allocata e limita la durata dell'esecuzione (15 minuti al massimo (una volta richiamata, la funzione si arresta automaticamente e devi passare a EC2 o Fargate).
- Per EC2: scegli un'istanza adatta al tuo carico di lavoro, oppure passa a istanze Spot (più economiche, ma soggette a interruzioni in qualsiasi momento).
- Attiva i Avvisi di superamento del budget AWS per ricevere un avviso prima di superare una soglia che stabilisci tu stesso.
Domande frequenti
Il web scraping con AWS è legale?
Dipende dal tuo caso specifico. La legalità del web scraping varia a seconda del Paese, del tipo di dati raccolti e dell’uso che ne fai. In Francia, lo scraping di dati pubblici può essere lecito a determinate condizioni, ma non è automatico.
Tre cose da controllare prima di avviare il tuo scraper:
- Il condizioni d'uso del sito di destinazione, che potrebbero vietare lo scraping.
- il diritto delle banche dati, che tutela l'investimento del produttore anche nel caso di dati di dominio pubblico.
- il RGPD, che si applica ogni volta che è coinvolto un dato personale, anche se pubblicato.
Per quanto riguarda AWS, sei tu a essere responsabile della conformità della tua attività. In caso di dubbi, fai verificare il tuo progetto da un professionista.
Qual è l'approccio migliore per il web scraping con AWS?
Dipende tutto dalle dimensioni e dalla durata del tuo progetto:
- AWS Lambda : per lo scraping occasionale, un'esecuzione sotto 15 minuti e alcune centinaia di URL. Il livello gratuito copre 1 milione di richieste al mese, in modo permanente.
- EC2 : per attività di lunga durata (oltre 15 minuti) o per lo scraping continuo. Un'istanza t3.micro ammonta a circa 7,59 $/mese on demand.
- Fargate : per la parallelizzazione su larga scala, senza dover gestire alcun server.
In pratica, inizia su Lambda per effettuare i test, poi passa a EC2 o Fargate quando il volume aumenta. Se preferisci un approccio senza codice, strumenti come Scraper istantaneo di dati consentono di raccogliere dati direttamente dal tuo browser.
Posso usare Selenium su AWS Lambda per il web scraping?
Sì, ma è più complicato da mettere in pratica. Selenium e i browser senza interfaccia grafica come Puppeteer sono utili per estrazione di dati dalle pagine con JavaScript. La loro configurazione su Lambda richiede tuttavia alcune ottimizzazioni: dimensioni del pacchetto, gestione delle dipendenze e memoria allocata.
Come posso evitare di essere bloccato da un sito web su AWS?
I siti spesso individuano gli scraper e bloccano le loro richieste. Ecco alcune strategie efficaci per ridurre i rischi:
- Modificare regolarmente l'intestazione User-Agent per sembrare più umano.
- Aggiungere ritardi casuali tra una richiesta e l'altra.
- Utilizzare proxy rotanti per variare il tuo indirizzo IP.
- Limitare il numero di richieste inviate contemporaneamente dallo stesso indirizzo IP.
Come integrare i dati scrapati in un database?
Una volta raccolti i dati, puoi inserirli in un database relazionale come Amazon RDS (MySQL, PostgreSQL, ecc.).
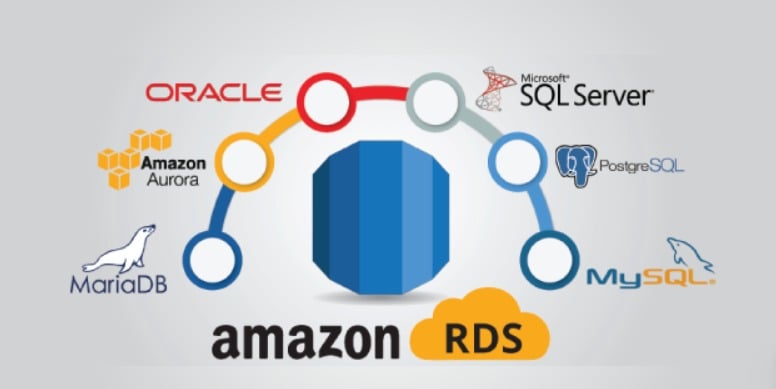
La buona pratica consiste nel pulire e organizzare i dati prima dell'inserimento. A quel punto puoi automatizzare l'integrazione tramite uno script Python o una pipeline, per ottenere un database pulito e pronto all’uso.
Combinando la potenza di’AWS e il buone pratiche di scraping, potrai estrarre i tuoi dati in modo efficiente e sicuro. Se ti blocchi in una fase, non esitare a porci le tue domande nei commenti!








 Italiano