AWS memungkinkan Anda melakukan web scraping tanpa perlu mengelola server.
Untuk scraper yang ringan dan otomatis, Lambda + S3 sudah lebih dari cukup.
Untuk memproses jutaan halaman secara bersamaan, kamu bisa menggunakan Fargate Di mana EC2 dengan Scrapy.
Apa peran AWS dalam web scraping?
itu pengikisan web memungkinkan Mengambil data secara otomatis di situs web untuk menganalisis atau menggunakannya kembali. Mengelola juta halaman, mencegah terjadinya kemacetan dan memastikan keandalan dapat dengan cepat menjadi masalah teknis yang rumit, terutama jika kamu harus mengelola infrastrukturmu sendiri.
Di situlah…’AWS (Amazon Web Services) pun ikut berperan. Platform ini Awan Amazon menyederhanakan proses scraping dengan mengotomatiskan pengelolaan server, serta mendukung skalabilitas, ketersediaan dan keamanan yang terjamin untukmu, bahkan dengan volume data yang sangat besar.
Inilah alasan mengapa AWS merupakan solusi yang ideal untuk menjalankan scraper:
- Skalabilitas : Platform ini secara otomatis meningkatkan kapasitasnya untuk menangani jutaan permintaan tanpa gangguan.
- Keandalan : Layanan terkelola AWS meminimalkan risiko gangguan dan memastikan kelancaran operasional.
- Biaya terkendali : dengan model bayar sesuai pemakaian, kamu hanya membayar sesuai dengan yang benar-benar kamu gunakan.
- Keamanan : AWS menerapkan langkah-langkah yang ketat untuk melindungi data yang disimpan dan dikirimkan.
Layanan AWS apa saja yang relevan?
Layanan cloud Amazon menawarkan beragam layanan yang disesuaikan dengan setiap kebutuhan web scraping. Berikut adalah layanan-layanan utama yang perlu Anda ketahui, diurutkan berdasarkan kegunaannya.
Perhitungan: di mana scraper-mu beroperasi
- AWS Lambda : cocok untuk tugas-tugas kecil dan pengambilan data sesekali, tanpa perlu mengelola server. Inilah pendekatannya tanpa server yang paling menonjol.
- Amazon EC2 : sangat cocok untuk proses yang memakan waktu lama atau membutuhkan banyak sumber daya. Kamu menyewa sebuah mesin virtual dan kamu tetap memegang kendali atas seluruh konfigurasi.
Penyimpanan: tempat kamu menyimpan data
- Amazon S3 : untuk menyimpan data mentah, berkas HTML atau hasil scraping dalam sebuah ember. Setiap berkas diidentifikasi dengan sebuah kunci unik dalam bucket S3, sehingga memudahkan akses dan pengorganisasian data yang dikumpulkan.
- Amazon DynamoDB : untuk struktur data yang menuntut kemampuan membaca dan menulis yang sangat cepat.
Pengaturan: untuk menghubungkan tahapan-tahapan
- AWS Step Functions : untuk mengelola alur kerja yang kompleks, ketika beberapa fungsi harus dilakukan secara berurutan dalam urutan tertentu.
Layanan tambahan
- Amazon SQS : untuk mengelola antrian permintaan dan memperlancar pemrosesan data dalam skala besar.
- AWS IAM : untuk mengelola akses dan menetapkan sebuah kebijakan Tentukan dengan tepat, agar scraper-mu hanya memiliki hak akses yang benar-benar dibutuhkannya.
Dalam praktiknya, sebuah proyek sederhana sering kali menggabungkan Lambda + S3 + IAM. Untuk pengambilan data dalam skala besar, tambahkan EC2, SQS dan DynamoDB sesuai kebutuhanmu.
Bagaimana cara membuat scraper serverless dengan AWS Lambda?
Dengan AWS Lambda, kamu tidak perlu mengelola server: AWS menangani seluruh infrastruktur, mulai dari skalabilitas ke pemeliharaan. Kamu cukup menyediakan kode dan konfigurasimu. Berikut ini cara membuat scraper serverless pertamamu, langkah demi langkah.
1. Arsitektur dasar serverless scraper
Sebelum mulai membuat kode, bayangkan bagaimana berbagai layanan AWS akan bekerja sama. Ada tiga pilihan yang menentukan struktur arsitekturmu.
- Memilih pemicu
Ini adalah elemen yang menentukan kapan kode kamu harus dijalankan. Kamu bisa memilih di antara CloudWatch dan EventBridge.
- Memilih komputasi
Di sinilah kode kamu dijalankan di cloud. Silakan Lambda untuk tugas-tugas singkat dan sesekali. Lewati EC2 Di mana Fargate jika pekerjaan itu lama atau berat.
- Memilih penyimpanan
Gunakan S3 untuk berkas JSON, CSV, atau data mentah. Pilih DynamoDB jika kamu membutuhkan akses yang cepat dan terstruktur ke datamu.
Singkatnya: pemicu mengaktifkan Lambda, Lambda menjalankan proses scraping, dan data tersebut masuk ke dalam bucket S3.
2. Persiapan lingkungan
Sebelum mulai membuat kode, berikan izin yang diperlukan kepada AWS dan buat ruang penyimpanan.
- Membuat peran IAM (izin)
- Buka konsol AWS > IAM > Peran.
- Buat peran khusus untuk Lambda.
- Berikan dia dua izin penting:
Peran Eksekusi Dasar AWS Lambdauntuk mengirim log ke CloudWatch, dan izin S3 untuk menulis file ke bucket-mu.
- Membuat bucket S3 (penyimpanan hasil)
- Buka konsol AWS > S3.
- Buat sebuah bucket dan simpan parameter keamanan diaktifkan.
Lambda kini memiliki izin untuk menulis ke bucket S3-mu, dan kamu sudah memiliki tempat yang siap untuk menyimpan datamu.
3. Kode Python untuk AWS Lambda
Tulis sebuah Scraping dengan Python bersama perpustakaan Requests. Skrip ini mengambil sebuah halaman web dan menyimpan hasilnya di bucket S3.
- Contoh kode sederhana (dengan requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # URL yang akan di-scrape (ini contoh sederhana)
    url = "https://example.com"
    response = requests.get(url)

 # Pemeriksaan status
    if response.status_code == 200:
 # Nama file (dengan cap waktu untuk menghindari tabrakan)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Mengunggah ke S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # harus ditentukan dalam variabel lingkungan Lambda-mu
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"Halaman telah disimpan di {filename}")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("Terjadi kesalahan saat melakukan scraping")
 }
permintaan mengambil konten dari halaman web tersebut. boto3 adalah pustaka resmi untuk berkomunikasi dengan AWS. Untuk mempelajari API lebih lanjut, kamu dapat menyesuaikan skema yang sama ini dengan titik akhir jarak jauh.
- Pengelolaan ketergantungan (requests Di mana Scrapy)
Lambda tidak menyediakan pustaka-pustaka tersebut secara default. Kamu memiliki dua pilihan.
Opsi 1: membuat paket ZIP
- Buat sebuah folder di komputer Anda:
mkdir package && cd package pip install requests -t .- Unggah berkasmu
lambda_function.pydalam berkas ini. - Kompres semuanya menjadi
.zipdan unggah ke Lambda.
Opsi 2: menggunakan Lambda Layers
- Buat lapisan Lambda yang berisi Requests (atau Scrapy untuk penggalian data yang lebih canggih).
- Sambungkan lapisan ini ke fungsi Lambda-mu.
Keuntungan : Kode akan lebih rapi jika kamu menggunakan kembali dependensi yang sama di beberapa fungsi.
4. Implementasi dan pengujian
Sekarang tinggal mengunggah kode kamu dan memastikan bahwa kode tersebut berfungsi.
- Unggah kode ke Lambda
- Masuk ke konsol AWS, lalu buka layanan Lambda.
- Klik pada Buat fungsi, lalu pilih Penulis dari awal.
- Beri nama fungsi Anda (contoh:
scraper-lambda) dan pilih Runtime Python 3.12 (atau versi yang kamu gunakan). - Hubungkan peran IAM yang telah dibuat sebelumnya dengan izin S3 dan CloudWatch.
- Di tab Kode, pilih Unggah dari > berkas .zip dan unggah berkasmu
lambda_package.zip. - Tambahkan variabel lingkungan:
NAMA_BUCKET= nama bucket S3-mu. - Klik pada Simpan untuk menyimpan konfigurasi fungsi Lambda-mu.
- Menguji fungsi
- Di fungsi Lambda-mu, klik Uji.
- Buat acara pengujian baru dengan JSON singkat, misalnya:
{ "url": "https://example.com" }- Klik pada Simpankemudian pada Uji untuk menjalankan fungsi.
- Di tab Catatan, periksa statusnya: kamu seharusnya melihat sebuah kode 200 jika semuanya berjalan lancar.
- Buka bucket S3-mu: kamu akan melihat sebuah berkas muncul
scraping_xxxx.html.
Apa saja solusi untuk web scraping skala besar?
Untuk mengumpulkan juta halaman, kamu memerlukan infrastruktur yang kokoh. Ide di AWS adalah mendistribusikan beban kerja dan menjalankan beberapa scraper secara paralel.
1. Menggunakan Scrapy dan AWS Fargate/EC2
Scrapy adalah framework Python yang sangat cocok untuk proyek-proyek kompleks. Secara default, scraper-mu berjalan di mesinmu sendiri, yang kapasitasnya cepat mencapai batasnya. Untuk meningkatkan skalanya, kamu memiliki dua opsi di AWS.
AWS Fargate jalankan scraper Scrapy-mu di kontainer Docker, tanpa perlu mengelola server sama sekali. Ini adalah pilihan ideal untuk scraping tanpa server dan yang dapat diskalakan. Prosesnya terdiri dari tiga langkah:
- Kamu membuat scraper Scrapy-mu sendiri.
- Kamu masukkan ke dalam wadah Docker.
- Kamu menjalankan kontainer ini dengan Fargate agar dapat dijalankan secara otomatis dalam skala besar.
Amazon EC2 adalah alternatif jika kamu ingin memiliki kendali lebih besar atas lingkunganmu. Kamu menginstal Python dan Scrapy sendiri pada sebuah instance, lalu mengotomatiskan proses eksekusinya. Sebuah instance t3.micro setara dengan sekitar 7,59 $/bulan dalam layanan On-Demand di us-east-1.
Dalam kedua kasus tersebut, data yang diekstraksi dikirim ke sebuah bucket S3, yang berfungsi sebagai tempat penyimpanan terpusat untuk semua file yang telah kamu kumpulkan.
2. Arsitektur scraping terdistribusi
Untuk benar-benar melakukan pemrosesan paralel, kamu mengandalkan Amazon SQS (Simple Queue Service). Prinsipnya sederhana: kamu memasukkan semua URL-mu ke dalam SQS, dan beberapa fungsi Lambda atau beberapa kontainer (di EC2 atau Fargate) mengambil URL-URL tersebut secara paralel untuk menjalankan proses scraping. Setiap fungsi Lambda membaca sebuah URL dari antrian, menjalankan proses scraping, dan menyimpan hasilnya ke dalam sebuah bucket S3 dengan kunci unik.
Arsitektur ini memungkinkanmu untuk membagi pekerjaan dan memproses ribuan halaman secara bersamaan. Inilah fondasi dari scraper terdistribusi yang andal di AWS Cloud. Untuk halaman dengan konten dinamis yang dimuat melalui Ajax, kamu perlu menyesuaikan pendekatanmu untuk mengambil data setelah halaman ditampilkan.
3. Mengelola proxy dan permintaan yang diblokir
Banyak situs memblokir scraper dengan mendeteksi volume permintaan yang tidak wajar atau dengan menyaring beberapa Alamat IP. Ada dua cara untuk mengatasi kendala ini:
- Itu rotasi alamat IP, melalui AWS atau layanan khusus.
- Penggunaan proxy pihak ketiga sebagai Data Cerah Di mana ScrapingBee, yang secara otomatis mengendalikan rotasi dan sistem anti-lock.
Apa saja solusi untuk masalah scraping web yang umum terjadi pada AWS?
Hambatan selalu mengintai saat kamu melakukan web scraping: kesalahan jaringan, pemblokiran, dan biaya tak terduga. Kabar baiknya, AWS sudah menyediakan layanan untuk mendiagnosis dan mengatasi masalah-masalah tersebut dengan cepat.
Menganalisis log dengan Amazon CloudWatch
Ketika sebuah fungsi Lambda atau instance EC2 mengalami kegagalan, sulit untuk mengetahui asal mula kesalahannya tanpa visibilitas terhadap proses eksekusinya. Dengan Amazon CloudWatch, semua log terpusat dan dapat diakses melalui konsol. Di sana, Anda dapat dengan cepat mengidentifikasi kesalahan yang sering terjadi:
- Keterlambatan : permintaan tersebut membutuhkan waktu terlalu lama untuk merespons.
- Kesalahan 403 : situs tersebut memblokir scraper-mu.
- Kesalahan 429 : terlalu banyak permintaan yang dikirim sekaligus.
- Kekurangan memori atau ketergantungan Python yang tidak ada dalam kode Lambda.
Konfigurasikan Peringatan CloudWatch agar mendapat pemberitahuan otomatis begitu terjadi kesalahan yang terlalu sering.
Pengelolaan Kesalahan Permintaan
Sebuah scraper bisa macet total jika satu permintaan saja gagal. Dasar-dasarnya: kelilingi panggilan-panggilanmu di Python dengan try…except agar program tidak tiba-tiba berhenti akibat satu kesalahan saja.
Selanjutnya, terapkan strategi percobaan ulang :
- Coba lagi setelah menunggu sebentar, lalu tingkatkan waktu tunggu secara bertahap (penurunan eksponensial).
- Bergantian di antara beberapa proxy jika sebuah alamat IP diblokir.
- Sesuaikan frekuensi permintaanmu agar tetap tidak mencolok dan tidak terdeteksi.
Pemantauan biaya
Scraper yang tidak dioptimalkan dengan baik dapat memicu ribuan panggilan Lambda atau membiarkan instance EC2 berkapasitas besar terus berjalan tanpa alasan yang jelas. Untuk tetap memegang kendali, gunakan AWS Billing dan memantau penggunaan setiap layanan.
Beberapa perkiraan besaran agar kamu bisa membayangkannya:
- Lambda : tentang 0,20 $ per juta permintaan, ditambah waktu eksekusi yang ditagihkan dalam Go-detik. Yang paket gratis menutupi 1 juta permintaan gratis dan 400.000 Go-detik setiap bulan, secara berkelanjutan. Data yang diekstraksi disimpan dalam sebuah bucket S3 ; pantau volume penyimpanan, karena S3 juga mengenakan biaya berdasarkan jumlah data yang disimpan.
- EC2 t3.micro : sekitar 7,59 $/bulan di On-Demand di us-east-1, jauh lebih sedikit dengan instansi Spot.
Dalam hal pengoptimalan, ada beberapa langkah sederhana yang bisa dilakukan:
- Untuk Lambda: kurangi alokasi memori dan batasi durasi eksekusi (Maksimal 15 menit (setelah dipanggil, fungsi tersebut akan berhenti secara otomatis dan kamu harus beralih ke EC2 atau Fargate).
- Untuk EC2: pilih instance yang sesuai dengan beban kerjamu, atau beralihlah ke instansi Spot (lebih murah, tetapi dapat dihentikan kapan saja).
- Aktifkan Peringatan Anggaran AWS agar mendapat pemberitahuan sebelum melampaui batas yang kamu tentukan sendiri.
FAQ
Apakah web scraping dengan AWS legal?
Itu tergantung pada situasi kamu masing-masing. Yang legalitas web scraping bervariasi tergantung pada negara, jenis data yang dikumpulkan, dan cara kamu menggunakannya. Di Prancis, pengambilan data publik dapat diperbolehkan dengan syarat-syarat tertentu, tetapi hal itu tidak terjadi secara otomatis.
Tiga hal yang perlu diperiksa sebelum menjalankan scraper-mu:
- Itu syarat dan ketentuan penggunaan dari situs yang menjadi sasaran, yang mungkin melarang praktik scraping.
- itu hukum basis data, yang melindungi investasi produsen bahkan atas data publik.
- itu RGPD, yang berlaku begitu data pribadi terlibat, meskipun data tersebut telah dipublikasikan.
Di sisi AWS, kamu tetap bertanggung jawab atas kepatuhan operasionalmu. Jika ragu, mintalah proyekmu diverifikasi oleh seorang profesional.
Apa pendekatan terbaik untuk web scraping dengan AWS?
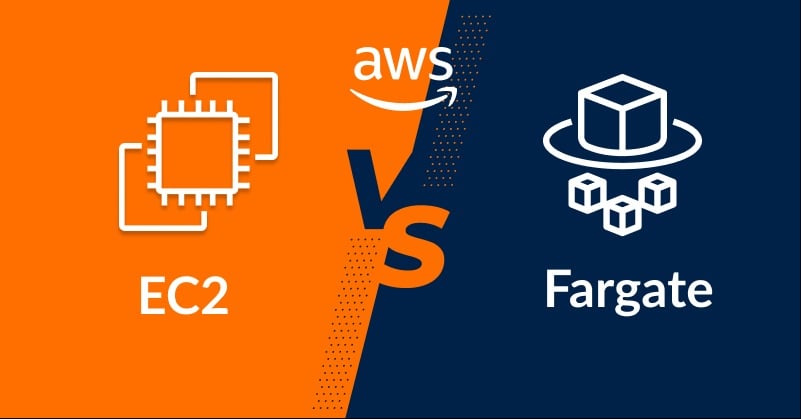
Semuanya tergantung pada skala dan durasi proyekmu:
- AWS Lambda : untuk pengambilan data sesekali, jalankan di bawah 15 menit dan beberapa ratus URL. Yang paket gratis menutupi 1 juta permintaan per bulan, secara permanen.
- EC2 : untuk tugas yang memakan waktu lama (lebih dari 15 menit) atau pengambilan data secara terus-menerus. Satu instance t3.micro sekitar 7,59 $/bulan dalam mode On-Demand.
- Fargate : untuk paralelisasi skala besar, tanpa perlu mengelola server.
Secara praktis, mulailah dengan Lambda untuk pengujian, lalu beralih ke EC2 atau Fargate saat volume meningkat. Jika kamu lebih suka pendekatan tanpa kode, alat-alat seperti Pengikis Data Instan memungkinkan pengumpulan data langsung dari browser-mu.
Apakah saya dapat menggunakan Selenium di AWS Lambda untuk web scraping?
Ya, tapi pelaksanaannya lebih rumit. Selenium dan peramban tanpa antarmuka grafis seperti Puppeteer berguna untuk mengambil data dari halaman web menggunakan JavaScript. Namun, konfigurasi mereka di Lambda memerlukan beberapa optimasi: ukuran paket, pengelolaan dependensi, dan alokasi memori.
Bagaimana cara menghindari agar akun saya tidak diblokir oleh situs web di AWS?
Situs web sering kali mendeteksi scraper dan memblokir permintaan mereka. Berikut ini beberapa taktik efektif untuk mengurangi risikonya:
- Ubah header User-Agent secara berkala agar terlihat lebih manusiawi.
- Tambahkan penundaan acak di antara setiap permintaan.
- Menggunakan proxy yang berputar untuk mengubah alamat IP-mu.
- Membatasi jumlah permintaan dikirim secara bersamaan dari alamat IP yang sama.
Bagaimana cara mengintegrasikan data yang telah di-scrape ke dalam basis data?
Setelah data terkumpul, kamu dapat memasukkannya ke dalam basis data relasional seperti Amazon RDS (MySQL, PostgreSQL, dll.).
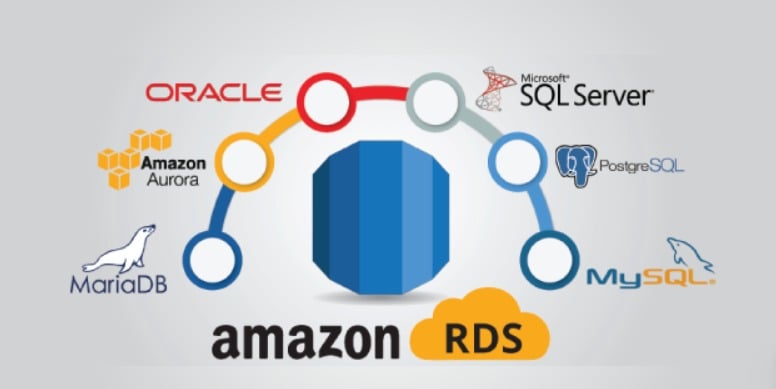
Praktik yang baik adalah membersihkan dan mengorganisasikan data sebelum penyisipan. Setelah itu, kamu bisa mengotomatisasi integrasi melalui skrip Python atau pipeline, untuk mendapatkan basis data yang bersih dan siap digunakan.
Dengan menggabungkan kekuatan dari’AWS dan praktik terbaik dalam scraping, kamu dapat mengekstrak data dengan efisien dan aman. Jika kamu mengalami kesulitan pada salah satu langkah, jangan ragu untuk mengajukan pertanyaanmu di kolom komentar!








 Bahasa Indonesia