AWS позволяет заниматься веб-парсингом без необходимости администрирования сервера.
Если вам нужен легкий и автоматизированный скрейпер, Lambda + S3 этого вполне достаточно.
Для параллельной обработки миллионов страниц ты переходишь на Fargate Где EC2 с Scrapy.
Какова роль AWS в веб-парсинге?
в скраппинг позволяет автоматически извлекать данные на веб-сайтах для их анализа или повторного использования. Управление миллионы страниц, предотвращение сбоев и обеспечение надежности могут быстро превратиться в настоящую техническую головную боль, особенно если тебе приходится самостоятельно обслуживать свою инфраструктуру.
Именно здесь…’AWS (Amazon Web Services) вступает в игру. Эта платформа облако Amazon упрощает скрапинг за счет автоматизации управления серверами и поддержки масштабируемость, обеспечение доступности и безопасности на твоём месте, даже при обработке огромных объемов данных.
Вот почему AWS — идеальное решение для запуска скрейпера:
- Масштабируемость : платформа автоматически масштабируется, чтобы без перебоев обрабатывать миллионы запросов.
- Надежность : Управляемые сервисы AWS снижают риск сбоев и обеспечивают бесперебойную работу.
- Контроль затрат : с моделью по мере использования, ты платишь только за то, что действительно потребляешь.
- Безопасность : AWS принимает надежные меры для защиты твоих данных, как хранящихся, так и передаваемых.
Какие услуги AWS подходят для этих целей?
Облачная платформа Amazon предлагает широкий спектр сервисов, отвечающих любым потребностям в области веб-парсинга. Ниже приведены основные из них, сгруппированные по сферам применения.
Расчет: где работает твой скрейпер
- AWS Lambda : идеально подходит для небольших задач и эпизодического скрапинга без необходимости администрирования сервера. Это подход безсерверный по преимуществу.
- Amazon EC2 : идеально подходит для длительных или ресурсоемких процессов. Вы арендуете виртуальная машина и ты сохраняешь контроль над всей настройкой.
Хранение: где ты хранишь свои данные
- Amazon S3 : для хранения необработанные данные, HTML-файлы или результаты скрапинга в ведро. Каждый файл идентифицируется с помощью ключ уникальный в корзине S3, что облегчает доступ к собранным данным и их систематизацию.
- Amazon DynamoDB : для структурированные данные которые требуют очень быстрой работы с чтением и записью.
Оркестровка: для последовательного выполнения этапов
- AWS Step Functions : для управления сложными рабочими процессами, когда несколько операций должны выполняться последовательно в строгом порядке.
Дополнительные услуги
- Amazon SQS : для управления очередями запросов и сглаживания обработки данных в больших масштабах.
- AWS IAM : для управления доступом и настройки политика точно, чтобы у твоего скрейпера были только те права, которые ему действительно нужны.
На практике простой проект часто сочетает в себе Lambda + S3 + IAM. Для массового сбора данных добавь EC2, SQS а также DynamoDB в зависимости от твоих потребностей.
Как создать бессерверный скрейпер с помощью AWS Lambda?
С AWS Lambda, тебе не нужно заниматься управлением сервером: AWS берет на себя всю инфраструктуру, начиная с масштабируемость к техническое обслуживание. Тебе нужно лишь предоставить свой код и настройки. Вот как шаг за шагом создать свой первый бессерверный скрейпер.
1. Базовая архитектура бессерверного скрепера
Прежде чем приступить к программированию, представьте себе, как различные сервисы AWS будут взаимодействовать друг с другом. Ваша архитектура определяется тремя основными параметрами.
- Выбор спускового механизма
Именно этот элемент определяет, когда должен выполняться твой код. У тебя есть выбор между CloudWatch а также EventBridge.
- Выбрать вычислительную мощность
Именно здесь твой код выполняется в облаке. Возьми Lambda для коротких и эпизодических задач. Перейти к EC2 Где Fargate если работа длительная или тяжелая.
- Выбор хранилища
Использует S3 для файлов JSON, CSV или в исходном формате. Выбери DynamoDB если тебе нужен быстрый и упорядоченный доступ к твоим данным.
Вкратце: триггер запускает Lambda, Lambda выполняет скрапинг, и данные попадают в контейнер S3.
2. Подготовка окружающей среды
Прежде чем приступить к программированию, предоставь AWS необходимые разрешения и создай хранилище.
- Создать роль IAM (права доступа)
- Открой консоль AWS > IAM > Роли.
- Создать специальную роль для Lambda.
- Предоставь ему два важнейших права:
AWSLambdaBasicExecutionRoleдля отправки логов в CloudWatch, а также разрешение S3 на запись файлов в твой бакет.
- Создать корзину S3 (хранение результатов)
- Открой консоль AWS > S3.
- Создайте корзину и сохраните параметры безопасности активированы.
Теперь у Lambda есть права на запись в твой S3-бакет, и у тебя есть готовое место для хранения данных.
3. Код Python для AWS Lambda
Напиши скребковый алгоритм на Python с библиотекой Requests. Этот скрипт загружает веб-страницу и сохраняет результат в корзине S3.
- Простой пример кода (с requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # URL для скрапинга (здесь приведён простой пример)
    url = "https://example.com"
    response = requests.get(url)

 # Проверка статуса
    if response.status_code == 200:
 # Имя файла (с временной меткой для предотвращения конфликтов)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Отправка в S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # нужно задать в переменных среды Lambda
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"Страница сохранена в {filename}")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("Ошибка при скрапинге")
 }
Запросы извлекает содержимое веб-страницы. boto3 — это официальная библиотека для взаимодействия с AWS. Чтобы расширить возможности API, ты можешь адаптировать эту же схему для удаленных конечных точек.
- Управление зависимостями (requests Где Scrapy)
Lambda по умолчанию не предоставляет эти библиотеки. У тебя есть два варианта.
Вариант 1: создать пакет ZIP
- Создайте папку на вашем компьютере:
mkdir package && cd package pip install requests -t .- Загрузи свой файл
lambda_function.pyв этом деле. - Сжать всё в
.zipи загрузите его в Lambda.
Вариант 2: использовать Lambda Layers
- Создайте слой Lambda, содержащий Requests (или Scrapy для более сложного веб-парсинга).
- Привяжи этот слой к своей функции Lambda.
Преимущество : так будет более аккуратно, если ты будешь повторно использовать одни и те же зависимости в нескольких функциях.
4. Развертывание и тестирование
Осталось только разместить твой код в сети и проверить, работает ли он.
- Загрузить код в Lambda
- Войдите в консоль AWS и перейдите в сервис Lambda.
- Нажмите на Создать функцию, а затем выбери Автор с нуля.
- Присвойте имя своей функции (например:
скребок-лямбда) и выбери среда выполнения Python 3.12 (или версию, которую ты используешь). - Свяжите ранее созданную роль IAM с правами доступа к S3 и CloudWatch.
- На вкладке Закодировано, выберите Загрузить из > файла .zip и загрузи свой файл
lambda_package.zip. - Добавляет переменную среды:
BUCKET_NAME= название твоего S3-бакета. - Нажмите на Сохранить чтобы сохранить настройки твоей функции Lambda.
- Проверить функцию
- В своей функции Lambda нажми на Тест.
- Создайте новое тестовое событие с небольшим JSON-объектом, например:
{ "url": "https://example.com" }- Нажмите на Сохранитьдалее Тест для выполнения функции.
- На вкладке Журналы, проверь статус: ты должен увидеть код 200 если всё прошло хорошо.
- Зайди в свой бакет S3: ты увидишь, что там появился файл
scraping_xxxx.html.
Какие существуют решения для веб-парсинга в больших масштабах?
Чтобы собрать миллионы страниц, тебе понадобится надёжная инфраструктура. Идея использования AWS заключается в распределении нагрузки и запуске нескольких скрейперов одновременно.
1. Использование Scrapy и AWS Fargate/EC2
Scrapy — это идеальный фреймворк на Python для сложных проектов. По умолчанию твой скрейпер работает на твоем компьютере, что быстро приводит к ограничению объёма обработки данных. Для масштабирования у тебя есть два варианта на AWS.
AWS Fargate запусти свой скрейпер Scrapy в контейнеры Docker, при этом вам не придется заниматься администрированием сервера. Это идеальный вариант для бессерверного и масштабируемого скрапинга. Процесс состоит из трёх этапов:
- Создайте свой скрейпер Scrapy.
- Положи это в контейнер Docker.
- Ты развертываешь этот контейнер с помощью Фаргейт чтобы он запускался автоматически в широком масштабе.
Amazon EC2 — это альтернатива, если ты хочешь иметь больше контроля над своей средой. Ты самостоятельно устанавливаешь Python и Scrapy на экземпляр, а затем автоматизируешь их запуск. Экземпляр t3.micro составляет примерно 7,59 $/месяц в режиме On-Demand в регионе us-east-1.
В обоих случаях извлеченные данные отправляются в контейнер S3, в котором централизованно хранятся все твои скопированные файлы.
2. Распределенная архитектура скрапинга
Чтобы действительно организовать параллельную обработку, нужно опираться на Amazon SQS (Simple Queue Service). Принцип прост: ты помещаешь все свои URL-адреса в SQS, и несколько функций лямбда или несколько контейнеров (на EC2 или Fargate) обрабатывают эти URL-адреса параллельно для запуска парсинга. Каждая функция Lambda считывает URL из очереди, выполняет парсинг и сохраняет результат в контейнер S3 с уникальным ключом.
Эта архитектура позволяет тебе распределять работу и одновременно обрабатывать тысячи страниц. Это основа эффективного распределенного скрейпера, работающего в облаке AWS. В случае страниц с динамическим контентом, загружаемым с помощью Ajax, тебе придется адаптировать свой подход, чтобы извлекать данные после их отображения.
3. Управление прокси-серверами и заблокированными запросами
Многие сайты блокируют скрейперы, обнаруживая ненормальный объем запросов или фильтруя определенные IP-адреса. Существует два способа обойти эту блокировку:
- La ротация IP-адресов, через AWS или специализированные сервисы.
- Использование сторонние прокси-серверы в качестве Яркие данные Где ScrapingBee, которые автоматически управляют поворотом и антиблокировочной системой.
Каковы решения распространенных проблем с веб-скреппингом в AWS?
При веб-скрейпинге препятствия всегда поджидают: сетевые ошибки, блокировки, непредвиденные расходы. Хорошая новость заключается в том, что AWS уже предлагает сервисы, позволяющие быстро диагностировать и устранять эти проблемы.
Анализ журналов с помощью Amazon CloudWatch
Когда происходит сбой функции Lambda или экземпляра EC2, без возможности отслеживания хода выполнения сложно определить, в чем заключается причина ошибки. С помощью Amazon CloudWatch, все журналы централизованы, и их можно просматривать из консоли. Там вы быстро обнаружите типичные ошибки:
- Превышение сроков : запрос обработался слишком долго.
- Ошибки 403 : сайт блокирует твой скрейпер.
- Ошибки 429 : одновременно отправлено слишком много запросов.
- Нехватка памяти или Отсутствующие зависимости Python в коде Lambda.
Настройки оповещения CloudWatch чтобы получать автоматическое уведомление, как только какая-либо ошибка начинает повторяться слишком часто.
Обработка ошибок запросов
Скрейпер может полностью зависнуть, если хотя бы один запрос завершится сбоем. Основное правило: оберните свои вызовы в Python с помощью try…except чтобы программа не завершала работу внезапно из-за единичной ошибки.
Затем настройте стратегии повторного тестирования :
- Попробуйте ещё раз через некоторое время, а затем постепенно увеличивайте время ожидания (экспоненциальный спад).
- Переключается между несколькими прокси если какой-либо IP-адрес будет заблокирован.
- Регулируй частоту своих запросов, чтобы оставаться незаметным и не привлекать к себе внимания.
Контроль затрат
Плохо оптимизированный скрейпер может генерировать тысячи вызовов Lambda или заставлять крупный экземпляр EC2 работать впустую. Чтобы сохранить контроль, используй AWS Billing и отслеживает потребление ресурсов каждой службой.
Несколько порядков величин, чтобы ты мог сориентироваться:
- лямбда : о 0,20 $ на миллион запросов, плюс время выполнения, выставленное в ГБ-секундах. бесплатный тарифный план покрывает 1 миллион бесплатных запросов а также 400 000 ГБ-секунд ежемесячно, на постоянной основе. Извлеченные данные хранятся в контейнер S3 ; следите за объемом хранимых данных, так как S3 взимает плату и за объем хранимых данных.
- EC2 t3.micro : около 7,59 $/месяц в режиме On-Demand в регионе us-east-1, значительно меньше при использовании Spot-инстансы.
Что касается оптимизации, вот несколько простых рекомендаций:
- Для Lambda: уменьшите объем выделенной памяти и ограничьте время выполнения (Не более 15 минут при вызове; после этого функция автоматически завершает работу, и тебе нужно переключиться на EC2 или Fargate).
- Для EC2: выберите инстанс, соответствующий вашей нагрузке, или перейдите на Spot-инстансы (более дешевые, но могут быть прерваны в любой момент).
- Активировать бюджетные оповещения AWS чтобы получать уведомление, когда показатель превысит установленный тобой порог.
Часто задаваемые вопросы
Является ли веб-парсинг с помощью AWS законным?
Это зависит от твоей конкретной ситуации. Ла Законность веб-скреппинга зависит от страны, типа собираемых данных и того, как ты их используешь. Во Франции скрапинг общедоступных данных может быть законно при определенных условиях, но это не происходит автоматически.
Три момента, которые нужно проверить перед запуском твоего скрейпера:
- Les условия использования целевого сайта, которые могут запрещать скрапинг.
- в право в области баз данных, которая защищает инвестиции производителя даже в случае использования общедоступных данных.
- в RGPD, которая применяется в любом случае, когда речь идет о персональных данных, даже если они были опубликованы.
Что касается AWS, ты по-прежнему несешь ответственность за соответствие своей деятельности установленным требованиям. В случае сомнений обратись к специалисту для проверки твоего проекта.
Какой подход к веб-парсингу лучше всего подходит для AWS?
Всё зависит от масштаба и продолжительности твоего проекта:
- AWS Lambda : для разового сбора данных рекомендуется запускать под 15 минут и несколько сотен URL-адресов. Этот бесплатный тарифный план покрывает 1 миллион запросов в месяц, на постоянной основе.
- EC2 : для длительных задач (более 15 минут) или непрерывного скрапинга. Один экземпляр t3.micro составляет примерно 7,59 $/месяц в режиме «по запросу».
- Фаргейт : для крупномасштабного параллелизма без необходимости администрирования сервера.
Конкретно: начните с Lambda для тестирования, а затем перейдите на EC2 или Fargate, когда объём работы увеличится. Если вы предпочитаете подход без написания кода, то такие инструменты, как Мгновенный скребок данных позволяют собирать данные прямо из твоего браузера.
Могу ли я использовать Selenium на AWS Lambda для веб-парсинга?
Да, но это сложнее реализовать. Selenium а также браузеры без графического интерфейса, такие как Puppeteer полезны для парсинг страниц с помощью JavaScript. Однако их настройка на Lambda требует оптимизации: размер пакета, управление зависимостями и выделенная память.
Как избежать блокировки на сайте, размещённом на AWS?
Сайты часто обнаруживают скрейперы и блокируют их запросы. Вот несколько эффективных способов снизить риски:
- Регулярно изменять заголовок User-Agent чтобы казаться более человечным.
- Добавить случайные задержки между каждым запросом.
- Использование ротационных прокси чтобы сменить свой IP-адрес.
- Ограничить количество запросов отправленные одновременно с одного и того же IP-адреса.
Как интегрировать собранные данные в базу данных?
После сбора данных ты можешь внести их в реляционную базу данных, например Amazon RDS (MySQL, PostgreSQL и т. д.).
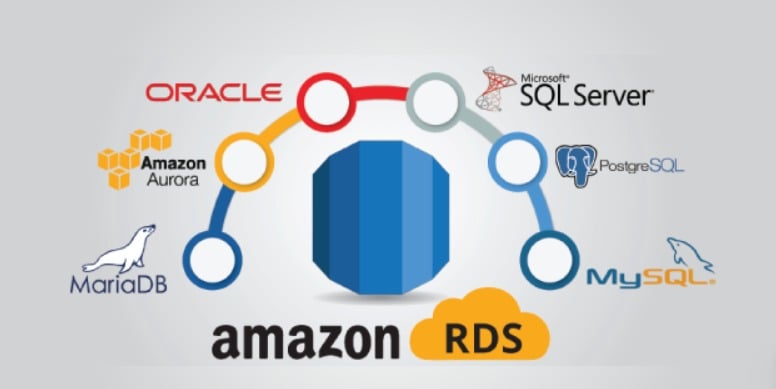
Надлежащая практика заключается в следующем очистить и систематизировать данные перед вставкой. Затем ты можешь автоматизировать интеграцию с помощью скрипта на Python или конвейера, чтобы получить чистую и готовую к использованию базу данных.
Объединяя мощь’AWS и передовые методы скрапинга, ты сможешь эффективно и безопасно извлечь свои данные. Если у тебя возникнут трудности на каком-либо этапе, не стесняйся задавать вопросы в комментариях!








 Русский