AWS サーバーを管理することなく、ウェブスクレイピングを行うことができます。.
軽量で自動化されたスクレイパーをお探しなら、, Lambda + S3 これで十分すぎるほどだ。.
数百万ページを並行して処理する場合は、 Fargate どこ EC2 と Scrapy.
ウェブスクレイピングにおいて、AWSはどのような役割を果たしているのでしょうか?
the ウェブスクレイピング 許す データを自動的に取得する ウェブサイトから取得して、分析や再利用を行う。管理する 数百万ページ, 、システムがフリーズするのを防ぎ、信頼性を確保することは、特にインフラを自分で管理しなければならない場合、すぐに大きな技術的な頭痛の種になりかねません。.
そこで……’AWS (Amazon Web Services) が登場します。このプラットフォームは Amazonクラウド サーバー管理を自動化し、以下の機能をサポートすることで、スクレイピングを簡素化します。 拡張性, 、膨大な量のデータがあっても、あなたの代わりに可用性とセキュリティを確保します。.
AWSがスクレイパーの立ち上げに最適なソリューションである理由は以下の通りです:
- スケーラビリティ : このプラットフォームは、中断することなく数百万件のリクエストを処理できるよう、自動的にスケーリングされます。.
- 信頼性 : AWSのマネージドサービスは、障害のリスクを低減し、継続的な稼働を保証します。.
- コスト管理 : モデルとともに 従量課金制, 、実際に利用した分だけ支払うことになります。.
- 安全 : AWSは、保存および転送されるお客様のデータを保護するために、強固な対策を講じています。.
AWSの関連サービスにはどのようなものがありますか?
Amazonのクラウドは、ウェブスクレイピングのあらゆるニーズに対応した幅広いサービスを提供しています。ここでは、用途別に分類した、知っておくべき主なサービスをご紹介します。.
計算:スクレイパーはどこで動作しているか
- AWS Lambda : サーバーの管理を必要とせず、ちょっとした作業やその場限りのスクレイピングに最適です。これがそのアプローチです サーバーレス まさにそのもの。.
- Amazon EC2 : 処理に時間がかかる場合や、リソースを多く消費する処理に最適です。レンタルするのは 仮想マシン そして、設定のすべてを自分で管理できます。.
ストレージ:データをどこに保存するか
- Amazon S3 : 保存するには 生データ, 、HTMLファイルやスクレイピングの結果を バケット. 各ファイルは、 key バケット内で一意 S3, 、これにより、収集されたデータへのアクセスや整理が容易になります。.
- Amazon DynamoDB : 以下の 構造化データ 非常に高速な読み取り・書き込みが求められるもの。.
オーケストレーション:各段階をスムーズに繋げるために
- AWS Step Functions : 複数の機能が特定の順序で連鎖して実行される必要がある場合、複雑なワークフローを管理するために。.
付帯サービス
- Amazon SQS : リクエストのキューを管理し、大規模なデータ処理を平滑化するため。.
- AWS IAM : アクセス管理を行い、 ポリシー 正確に設定し、スクレイパーが実際に必要な権限のみを持つようにしてください。.
実際には、単純なプロジェクトでは、しばしば以下の要素が組み合わされています Lambda + S3 + IAM. 大規模なスクレイピングを行う場合は、以下を追加してください EC2, SQS と DynamoDB 必要に応じて。.
AWS Lambdaでサーバーレススクレイパーを構築する方法
と AWS Lambda, 、サーバーの管理は必要ありません。AWSが、 拡張性 に対する 保守. 必要なのはコードと設定だけです。ここでは、サーバーレススクレイパーを初めて構築する方法を、ステップバイステップでご紹介します。.
1. サーバーレススクレイパーの基本アーキテクチャ
コーディングを始める前に、さまざまなAWSサービスがどのように連携するかをイメージしておきましょう。アーキテクチャを構成する要素は、主に3つあります。.
- トリガーを選択する
これは、コードをいつ実行するかを決定する要素です。以下のいずれかを選択できます。 CloudWatch と EventBridge.
- コンピューティングを選択する
ここは、クラウド上でコードが実行される場所です。 Lambda 短時間かつ不定期な作業に。次へ進む EC2 どこ Fargate 仕事が長引いたり、大変だったりする場合。
- ストレージの選択
使用する S3 JSON、CSV、または生データファイル用。選択してください DynamoDB データへの迅速かつ体系的なアクセスが必要な場合。.
要約すると:トリガーがLambdaを起動し、Lambdaがスクレイピングを実行し、データは S3バケット.
2. 環境の準備
コーディングを始める前に、AWSに必要な権限を付与し、ストレージを作成してください。.
- ロールの作成 IAM (権限)
- コンソールを開く AWS > IAM > 役割.
- Lambda専用のロールを作成します。.
- 彼に2つの重要な権限を与えてください:
AWS Lambda 基本実行ロールCloudWatchにログを送信するための権限と、S3バケットにファイルを書き込むための権限が必要です。.
- バケットを作成する S3 (結果の保存)
- コンソールを開く AWS > S3.
- バケットを作成し、以下のデータを保存します セキュリティ設定 有効化されています。.
Lambdaはこれで、あなたのS3バケットに書き込む権限を得たので、データを保存する場所が整いました。.
3. AWS Lambda の Python コード
「」と書いてください Pythonでのスクレイピング 図書館と Requests. このスクリプトはウェブページを取得し、その結果をS3バケットに保存します。.
- 簡単なコード例( requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # スクレイピング対象のURL (ここでは簡単な例)
    url = "https://example.com"
    response = requests.get(url)

 # ステータスの確認
    if response.status_code == 200:
 # ファイル名 (衝突を防ぐためにタイムスタンプを含む)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # S3へのアップロード
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # Lambdaの環境変数で定義してください
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"ページが {filename} に保存されました")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("スクレイピング中にエラーが発生しました")
 }
リクエスト ウェブページの内容を取得します。. boto3 は、AWSとの通信を行うための公式ライブラリです。APIの活用をさらに進めるには、この同じスキーマをリモートエンドポイントに適用することができます。.
- 依存関係の管理 (requests どこ Scrapy)
Lambdaでは、デフォルトではこれらのライブラリは提供されていません。2つの選択肢があります。.
オプション 1:パッケージを作成する ZIP
- 自分のマシンにフォルダを作成してください:
mkdir package && cd package pip install requests -t .- ファイルを追加する
ラムダ関数.pyこのファイルに。 - すべてを圧縮して
.zipそして、それをLambdaにアップロードします。.
オプション2:以下の Lambda Layers
- Requests(あるいは、より高度なスクレイピングを行う場合はScrapy)を含むLambdaレイヤーを作成します。.
- このレイヤーをLambda関数に紐付けます。.
メリット : 複数の関数で同じ依存関係を再利用した方が、コードがすっきりします。.
4. 展開とテスト
あとは、コードをオンラインに公開して、正常に動作するか確認するだけです。.
- コードをアップロードする Lambda
- AWSコンソールにログインし、Lambdaサービスに移動してください。.
- をクリックする。 関数を作成する, 、そして選択する ゼロから作成する著者.
- 関数に名前を付けてください(例:
スクレイパーラムダ) を選択し、 Python 3.12ランタイム (または、あなたが使用しているバージョン)。. - 先ほど作成したIAMロールを、S3およびCloudWatchの権限に関連付けます。.
- タブ コード化, 選択 アップロード元 > .zipファイル そして、ファイルをインポートしてください
ラムダパッケージ.zip. - 環境変数を追加します:
バケット名= S3バケット名。. - をクリックする。 保存 Lambda関数の設定を保存するには。.
- 機能をテストする
- Lambda関数内で、[ ] をクリックします。 テスト.
- 小さなJSONを使用して、新しいテストイベントを作成します。例えば:
{ "url": "https://example.com" }- をクリックする。 保存そして テスト 機能を実行するために。
- タブ ログ, ステータスを確認してください:次のように表示されるはずです コード 200 すべてが順調に進んだのであれば。.
- S3のバケットを開いてみてください。ファイルが表示されるはずです。
scraping_xxxx.html.
大規模なウェブスクレイピングの解決策とは?
~を収集するために 数百万ページ, 、そのためには堅牢なインフラが必要です。AWSでのアプローチは、負荷を分散させ、複数のスクレイパーを並行して実行することです。.
1. ScrapyとAWS Fargate/EC2を使用する
Scrapy は、複雑なプロジェクトに最適なPythonフレームワークです。デフォルトでは、スクレイパーはローカルマシン上で実行されるため、処理量にはすぐに制限が生じます。スケールアップするには、AWS上で2つの選択肢があります。.
AWS Fargate Scrapyスクラッパーを Dockerコンテナ, 、サーバーの管理を一切行わずに実現できます。これは、サーバーレスでスケーラブルなスクレイピングに最適な選択肢です。その手順は以下の3つのステップで構成されています:
- Scrapyのスクレイパーを作成します。.
- それを容器に入れる Docker.
- このコンテナは、以下のコマンドでデプロイします ファーゲート 大規模に自動的に実行されるようにするため。.
Amazon EC2 環境をより細かく制御したい場合には、これが最適な選択肢です。インスタンスにPythonとScrapyを自分でインストールし、実行を自動化します。インスタンス t3.micro およそ 7.59 $/月 us-east-1 でのオンデマンド配信。.
どちらの場合も、抽出されたデータは S3バケット, 、ここにスクレイピングしたすべてのファイルを一元的に保存します。.
2. 分散型スクレイピングアーキテクチャ
真の並列化を実現するには、以下のものに頼る Amazon SQS (Simple Queue Service)。仕組みは簡単だ。すべてのURLをSQSに登録すれば、複数の関数が ラムダ または、複数のコンテナ(EC2またはFargate上)がこれらのURLを取得する 並行して スクレイピングを実行するために。各Lambda関数は、キューからURLを読み取り、スクレイピングを実行し、結果を S3バケット 一意のキーを指定して。.
このアーキテクチャにより、あなたは 仕事を分担する そして、数千ページを同時に処理することができます。これが、AWSクラウド上で高性能に動作する分散型スクレイパーの基盤となります。Ajaxで読み込まれる動的コンテンツを含むページについては、レンダリング後にデータを取得できるよう、アプローチを調整する必要があります。.
3. プロキシとブロックされたリクエストの管理
多くのサイトでは、異常な量のリクエストを検知したり、特定のリクエストをフィルタリングしたりすることで、スクレイパーをブロックしています。 IPアドレス. このブロックを回避するには、2つの方法があります:
- The IPアドレスのローテーション, 、AWSや専門サービスを通じて。.
- 使用 サードパーティプロキシ なので ブライトデータ どこ スクレイピング・ビー, 、これらは自動的にタイヤの回転とアンチロック機能を制御する。.
AWSでよくあるウェブスクレイピングの問題の解決策は?
ウェブスクレイピングを行う際、ネットワークエラーやブロック、予期せぬコストなど、障害は常に付きものです。幸いなことに、AWSではこうした問題を迅速に診断・修正するためのサービスがすでに提供されています。.
Amazon CloudWatch を使用してログを分析する
Lambda関数やEC2インスタンスに障害が発生した場合、実行状況を把握できなければ、エラーの原因を特定するのは困難です。 Amazon CloudWatch, すべてのログは一元管理されており、コンソールから確認できます。そこで、よくあるエラーをすぐに特定できます:
- 納期超過 : リクエストの応答に時間がかかりすぎました。.
- エラー 403 : そのサイトはあなたのスクレイパーをブロックしています。.
- エラー 429 : 一度に送信されたリクエストが多すぎます。.
- 記憶力の低下か、それとも Pythonの依存関係が不足しています Lambdaコード内で。.
設定する CloudWatchアラート エラーが頻繁に発生した際に、自動的に通知を受け取るため。.
リクエストエラーの管理
たった1つのリクエストが失敗しただけで、スクレイパーが完全に停止してしまうことがあります。基本として、Pythonでの呼び出しは try…except 単発のエラーによってプログラムが突然終了するのを防ぐため。.
次に、以下のものを設定してください。 再試行の戦略 :
- 少し時間を置いてからもう一度試してみて、その後、待機時間を徐々に長くしていってください(指数関数的な減少).
- いくつかを交互に 代理人 あるIPアドレスがブロックされた場合。.
- 目立たないようにし、監視の目を逃れるために、リクエストの頻度を調整してください。.
コストの追跡
最適化が不十分なスクレイパーは、何千ものLambda呼び出しを発生させたり、大規模なEC2インスタンスを無駄に稼働させ続けたりする可能性があります。これを適切に管理するには、以下を使用してください。 AWS Billing また、各サービスの使用量を監視します。.
大まかな規模感を把握してもらうために:
- ラムダ について 0.20 $/100万クエリ, 、および請求対象となる実行時間をゴーセカンド単位で加算したものです。その 無料プラン カバー 100万件の無料リクエスト と 40万ゴーセカンド 毎月、継続的に。抽出されたデータは、ある S3バケット ; 保存容量を監視してください。S3では、保存されているデータ量に対しても課金されるためです。.
- EC2 t3.micro : について 7.59 $/月 us-east-1でのオンデマンド利用では、以下を使用した場合に比べてはるかに少ない Spotインスタンス.
最適化に関しては、いくつかの簡単なポイントがあります:
- Lambdaの場合:割り当てメモリを減らし、実行時間を制限してください(最大15分 (呼び出しにより、その機能は自動的に停止するため、EC2またはFargateに切り替える必要があります)。.
- EC2の場合:負荷に適したインスタンスを選択するか、あるいは Spotインスタンス (安いが、いつでも中断される可能性がある)。.
- アクティブにする AWSの予算アラート 自分で設定した閾値を超えそうになった際に通知を受け取るため。.
よくある質問
AWSでのウェブスクレイピングは合法ですか?
それは個々の状況次第です。その ウェブ・スクレイピングの合法性 国や収集するデータの種類、そのデータの用途によって異なります。フランスでは、公開データのスクレイピングは 条件付きで合法, 、しかし、それは自動的に行われるわけではありません。.
スクレイパーを実行する前に確認すべき3つのポイント:
- The 使用条件 対象サイトの規定により、スクレイピングが禁止されている場合があります。.
- the データベース法, 、これにより、公開データであっても制作者の投資が保護される。.
- the RGPD, 、これは、個人データが関係する場合には、たとえそれが公開されている場合でも適用される。.
AWSに関しては、事業活動のコンプライアンス確保については引き続きご自身で責任を負うことになります。不明な点がある場合は、専門家にプロジェクトの確認を依頼してください。.
AWSでのウェブスクレイピングに最適なアプローチとは?
それは、プロジェクトの規模と期間次第です:
- AWSラムダ : 単発のスクレイピングを行う場合は、以下で実行してください 15分 そして数百件のURL。その 無料プラン カバー 月間100万件のリクエスト, 、恒久的に。.
- EC2 : 長時間かかるタスク(15分以上)や、継続的なスクレイピングを行う場合。1つのインスタンス t3.micro およそ 7.59 $/月 オンデマンドで。.
- ファーゲート : サーバーの管理を必要としない、大規模な並列処理を実現します。.
具体的には、まずはLambdaでテストを開始し、トラフィックが増加したらEC2やFargateに切り替えます。コードを書かずに済ませたい場合は、次のようなツールが利用できます。 インスタント・データ・スクレーパー これを使えば、お使いのブラウザから直接データを収集できます。.
AWS LambdaでSeleniumを使用してウェブスクレイピングを行うことは可能ですか?
そうですね、でも導入するのはもっと複雑です。. Selenium また、グラフィカルユーザーインターフェースを持たないブラウザとしては、 Puppeteer は、以下の用途に役立ちます JavaScriptを使ったウェブページのスクレイピング. ただし、Lambda上での設定には、パッケージサイズ、依存関係の管理、割り当てられたメモリといった点での最適化が必要です。.
AWS上のウェブサイトからブロックされないようにするにはどうすればよいですか?
多くのサイトでは、スクレイパーを検知してそのリクエストをブロックすることがよくあります。リスクを軽減するための効果的な対策をいくつかご紹介します:
- User-Agentヘッダーを定期的に変更する より人間らしく見えるように。.
- ランダムな遅延を追加する 各リクエストの間に。.
- ローテーションプロキシを使用する IPアドレスを変えるために。.
- リクエスト数を制限する 同じIPアドレスから同時に送信されたもの。.
スクレイピングしたデータをデータベースに統合するには?
データが収集されたら、次のようなリレーショナルデータベースに格納することができます。 Amazon RDS (MySQL、PostgreSQLなど)。
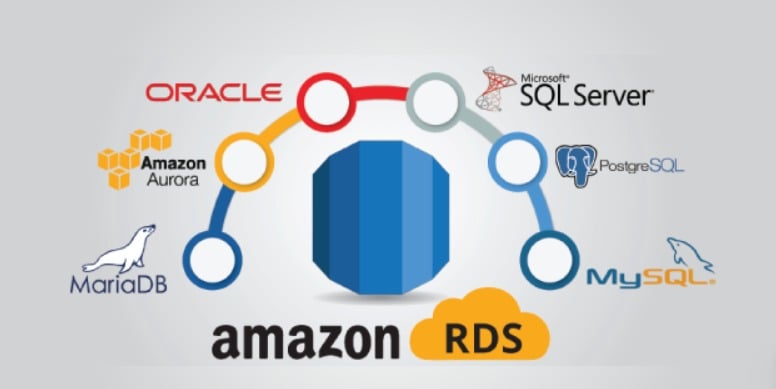
良い慣行は データのクリーニングと整理 挿入する前に。その後、あなたは 統合の自動化 Pythonスクリプトやパイプラインを通じて、クリーンで即座に活用可能なデータベースを作成します。.
のパワーを組み合わせることで’AWS そしてその スクレイピングのベストプラクティス, データを効率的かつ安全に抽出できます。もしどこかの手順で行き詰まってしまったら、遠慮なくコメント欄で質問してください!








 日本語