AWS te permite realizar web scraping sin tener que gestionar ningún servidor.
Para un scraper ligero y automatizado, Lambda + S3 es más que suficiente.
Para procesar millones de páginas en paralelo, se utiliza Fargate Donde EC2 con Scrapy.
¿Qué papel desempeña AWS en el web scraping?
la raspado web permite recuperar datos automáticamente en sitios web para analizarlos o reutilizarlos. Gestionar millones de páginas, evitar los bloqueos y garantizar la fiabilidad puede convertirse rápidamente en un auténtico quebradero de cabeza técnico, sobre todo si tienes que encargarte tú mismo del mantenimiento de tu infraestructura.
Ahí es donde…’AWS (Amazon Web Services) entra en escena. Esta plataforma nube de Amazon simplifica el scraping al automatizar la gestión de los servidores y al encargarse de la escalabilidad, la disponibilidad y la seguridad garantizadas, incluso con grandes volúmenes de datos.
He aquí por qué AWS es una solución ideal para poner en marcha un scraper:
- Escalabilidad : la plataforma se adapta automáticamente para gestionar millones de solicitudes sin interrupciones.
- Fiabilidad : los servicios gestionados de AWS reducen el riesgo de averías y garantizan un funcionamiento ininterrumpido.
- Costes controlados : con el modelo pago por uso, solo pagas lo que realmente consumes.
- Seguridad : AWS aplica medidas rigurosas para proteger tus datos almacenados y transmitidos.
¿Cuáles son los servicios relevantes de AWS?
La nube de Amazon ofrece una amplia gama de servicios adaptados a cada necesidad de web scraping. A continuación se enumeran los principales que conviene conocer, clasificados por uso.
El cálculo: ¿dónde gira tu rascador?
- AWS Lambda : ideal para pequeñas tareas y scraping puntual, sin necesidad de gestionar un servidor. Este es el enfoque sin servidor por excelencia.
- Amazon EC2 : ideal para procesos largos o que consumen muchos recursos. Alquilas una máquina virtual y tú mantienes el control sobre toda la configuración.
El almacenamiento: dónde guardas tus datos
- Amazon S3 : para almacenar los datos sin procesar, los archivos HTML o los resultados del scraping en un cubo. Cada archivo se identifica mediante un clave único en el bucket S3, lo que facilita el acceso y la organización de los datos recopilados.
- Amazon DynamoDB : para los datos estructurados que requieren una lectura y una escritura muy rápidas.
La coordinación: para encadenar las etapas
- AWS Step Functions : para gestionar flujos de trabajo complejos, cuando es necesario encadenar varias funciones en un orden concreto.
Los servicios complementarios
- Amazon SQS : para gestionar las colas de solicitudes y optimizar el procesamiento de datos a gran escala.
- AWS IAM : para gestionar los accesos y definir una política especifica, para que tu scraper solo tenga los derechos que realmente necesita.
En la práctica, un proyecto sencillo suele combinar Lambda + S3 + IAM. Para el scraping a gran escala, añade EC2, SQS y DynamoDB según tus necesidades.
¿Cómo crear un scraper sin servidor con AWS Lambda?
Con AWS Lambda, no tienes que ocuparte del servidor: AWS se encarga de toda la infraestructura, desde la escalabilidad a la mantenimiento. Solo tienes que proporcionar tu código y la configuración. A continuación te explicamos, paso a paso, cómo crear tu primer scraper sin servidor.
1. Arquitectura básica de un scraper sin servidor
Antes de empezar a programar, imagina cómo van a funcionar juntos los distintos servicios de AWS. Hay tres opciones que determinan la estructura de tu arquitectura.
- Elegir el disparador
Es el elemento que determina cuándo debe ejecutarse tu código. Puedes elegir entre CloudWatch y EventBridge.
- Elegir el ordenador
Es el lugar donde se ejecuta tu código en la nube. Toma Lambda para tareas breves y puntuales. Pasa a EC2 Donde Fargate si el trabajo es largo o pesado.
- Elegir el almacenamiento
Utiliza S3 para archivos JSON, CSV o sin procesar. Elige DynamoDB si necesitas un acceso rápido y estructurado a tus datos.
En resumen: el disparador activa Lambda, Lambda ejecuta el scraping y los datos se guardan en el depósito S3.
2. Preparación del entorno
Antes de empezar a programar, concede a AWS los permisos necesarios y crea un espacio de almacenamiento.
- Crear un rol IAM (los permisos)
- Ve a la consola AWS > IAM > Funciones.
- Crea un rol específico para Lambda.
- Concédele dos permisos esenciales:
AWSLambdaBasicExecutionRolepara enviar los registros a CloudWatch, y un permiso de S3 para escribir los archivos en tu bucket.
- Crear un bucket S3 (el almacenamiento de los resultados)
- Ve a la consola AWS > S3.
- Crea un bucket y guarda los parámetros de seguridad activados.
Ahora Lambda tiene permiso para escribir en tu bucket de S3, y ya tienes un espacio listo para almacenar tus datos.
3. El código Python para AWS Lambda
Escribe un scraper en Python con la biblioteca Requests. Este script recupera una página web y almacena el resultado en el bucket de S3.
- Ejemplo de código sencillo (con requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # URL que se va a rastrear (aquí un ejemplo sencillo)
    url = "https://example.com"
    response = requests.get(url)

 # Comprobación del estado
    if response.status_code == 200:
 # Nombre del archivo (con marca de tiempo para evitar colisiones)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Envío a S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # que debes definir en tus variables de entorno de Lambda
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"Página guardada en {filename}")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("Error al extraer los datos")
 }
peticiones recoge el contenido de la página web. boto3 es la biblioteca oficial para comunicarse con AWS. Para profundizar en el uso de las API, puedes adaptar este mismo esquema a puntos de conexión remotos.
- Gestión de dependencias (requests Donde Scrapy)
Lambda no incluye estas bibliotecas de forma predeterminada. Tienes dos opciones.
Opción 1: crear un paquete ZIP
- Crea una carpeta en tu ordenador:
mkdir paquete && cd paquete pip install requests -t .- Sube tu archivo
lambda_function.pyen este expediente. - Comprime todo en
.zipy súbelo a Lambda.
Opción 2: utilizar los Lambda Layers
- Crea una capa Lambda que contenga Requests (o Scrapy para un scraping más avanzado).
- Asigna esta capa a tu función Lambda.
Ventaja : queda más limpio si reutilizas las mismas dependencias en varias funciones.
4. Implementación y pruebas
Ahora solo tienes que subir tu código y comprobar que funciona.
- Subir el código a Lambda
- Inicia sesión en la consola de AWS y accede al servicio Lambda.
- Haga clic en Crear función, y luego elige Autor desde cero.
- Ponle un nombre a tu función (ejemplo:
scraper-lambda) y elige el tiempo de ejecución Python 3.12 (o la versión que utilices). - Asigna el rol de IAM creado anteriormente a los permisos de S3 y CloudWatch.
- En el codificado, elige Subir desde > archivo .zip e importa tu archivo
lambda_package.zip. - Añade una variable de entorno:
BUCKET_NAME= nombre de tu bucket de S3. - Haga clic en Guardar para guardar la configuración de tu función Lambda.
- Probar la función
- En tu función Lambda, haz clic en Prueba.
- Crea un nuevo evento de prueba con un pequeño JSON, por ejemplo:
{ "url": "https://example.com" }- Haga clic en Guardara continuación Prueba para ejecutar la función.
- En el Registros, comprueba el estado: deberías ver un código 200 si todo ha salido bien.
- Ve a tu bucket de S3: verás que aparece un archivo
scraping_xxxx.html.
¿Cuáles son las soluciones para el web scraping a gran escala?
Para recopilar millones de páginas, necesitas una infraestructura sólida. La idea con AWS es distribuir la carga y ejecutar varios scrapers en paralelo.
1. Usar Scrapy y AWS Fargate/EC2
Scrapy es un framework de Python ideal para proyectos complejos. Por defecto, tu scraper se ejecuta en tu ordenador, lo que pronto se ve limitado en cuanto a volumen. Para ampliar la escala, tienes dos opciones en AWS.
AWS Fargate Pon en marcha tu scraper Scrapy en contenedores Docker, sin tener que gestionar nunca un servidor. Es la opción ideal para un scraping sin servidor y escalable. El proceso consta de tres pasos:
- Crea tu propio scraper Scrapy.
- Lo metes en un recipiente Docker.
- Este contenedor se implementa con Fargate para que se ejecute automáticamente a gran escala.
Amazon EC2 es la alternativa si quieres tener más control sobre tu entorno. Tú mismo instalas Python y Scrapy en una instancia y, a continuación, automatizas la ejecución. Una instancia t3.micro equivale a aproximadamente 7,59 $/mes en modo bajo demanda en us-east-1.
En ambos casos, los datos extraídos se envían a un depósito S3, que centraliza el almacenamiento de todos tus archivos recopilados.
2. Arquitectura de scraping distribuida
Para lograr una verdadera paralelización, te basas en Amazon SQS (Simple Queue Service). El principio es sencillo: introduces todas tus URL en SQS y varias funciones lambda o varios contenedores (en EC2 o Fargate) recuperan estas URL en paralelo para iniciar el scraping. Cada función Lambda lee una URL de la cola, ejecuta el scraping y almacena el resultado en un depósito S3 con una clave única.
Esta arquitectura te permite distribuir el trabajo y avanzar por miles de páginas a la vez. Esta es la base de un scraper distribuido y eficaz en la nube de AWS. En el caso de las páginas con contenido dinámico que se cargan mediante Ajax, tendrás que adaptar tu enfoque para capturar los datos una vez que se hayan cargado.
3. Gestionar los proxys y las solicitudes bloqueadas
Muchas páginas web bloquean los rastreadores al detectar un volumen anormal de solicitudes o al filtrar algunas Direcciones IP. Hay dos soluciones para sortear este bloqueo:
- Él rotación de direcciones IP, a través de AWS o de servicios especializados.
- El uso de proxys de terceros como Datos brillantes Donde ScrapingBee, que controlan automáticamente la rotación y el sistema antibloqueo.
¿Cuáles son las soluciones a los problemas comunes de web scraping con AWS?
Los obstáculos nunca están muy lejos cuando te dedicas al web scraping: errores de red, bloqueos, costes imprevistos. La buena noticia es que AWS ya ofrece servicios para diagnosticar y solucionar estos problemas rápidamente.
Analizar los registros con Amazon CloudWatch
Cuando falla una función Lambda o una instancia de EC2, resulta difícil saber de dónde proviene el error si no se tiene visibilidad sobre la ejecución. Con Amazon CloudWatch, todos los registros están centralizados y se pueden consultar desde la consola. En ella podrás detectar rápidamente los errores más frecuentes:
- Incumplimientos de plazos : la consulta ha tardado demasiado en responder.
- Errores 403 : la página bloquea tu scraper.
- Errores 429 : se han enviado demasiadas solicitudes a la vez.
- ¿Falta de memoria o Faltan dependencias de Python en el código Lambda.
Configura unos alertas de CloudWatch para recibir una notificación automática en cuanto un error se repita con demasiada frecuencia.
Gestión de errores de consultas
Un scraper puede bloquearse por completo si falla una sola consulta. Lo básico: envuelve tus llamadas en Python con try…except para evitar que el programa se cierre de forma brusca debido a un error aislado.
A continuación, establece unas estrategias de reintento :
- Vuelve a intentarlo al cabo de un rato y, a continuación, ve aumentando poco a poco el tiempo de espera (disminución exponencial).
- Alterna entre varios apoderados si se bloquea una dirección IP.
- Ajusta la frecuencia de tus consultas para pasar desapercibido y no llamar la atención.
Seguimiento de costes
Un scraper mal optimizado puede generar miles de llamadas a Lambda o mantener en funcionamiento una instancia EC2 de gran tamaño sin motivo alguno. Para mantener el control, utiliza AWS Billing y supervisa el consumo de cada servicio.
Algunas cifras orientativas para que te hagas una idea:
- lambda : sobre 0,20 $ por millón de consultas, más el tiempo de ejecución facturado en Go-segundos. El nivel gratuito cubre 1 millón de consultas gratuitas y 400 000 Go-segundos cada mes, de forma permanente. Los datos extraídos se almacenan en un depósito S3 ; supervisa el volumen almacenado, ya que S3 también factura por la cantidad de datos conservados.
- EC2 t3.micro : en torno a 7,59 $/mes en On-Demand en us-east-1, mucho menos con instancias Spot.
En cuanto a la optimización, hay algunos consejos sencillos:
- Para Lambda: reduce la memoria asignada y limita el tiempo de ejecución (15 minutos como máximo por invocación; una vez superada esta, la función se detiene automáticamente y debes cambiar a EC2 o Fargate).
- Para EC2: elige una instancia adecuada para tu carga de trabajo o cambia a instancias Spot (más baratas, pero que pueden interrumpirse en cualquier momento).
- Activa los alertas presupuestarias de AWS para recibir una notificación antes de superar un límite que tú mismo establezcas.
preguntas frecuentes
¿Es legal el web scraping con AWS?
Depende de tu caso concreto. La legalidad del web scraping varía según el país, el tipo de datos recopilados y el uso que les des. En Francia, la extracción de datos públicos puede ser lícito con condiciones, pero no es algo automático.
Tres cosas que debes comprobar antes de poner en marcha tu scraper:
- Él condiciones de uso del sitio web en cuestión, que pueden prohibir el scraping.
- la derecho de las bases de datos, que protege la inversión del productor incluso en el caso de datos públicos.
- la RGPD, que se aplica siempre que se trate de un dato personal, incluso si está publicado.
En lo que respecta a AWS, sigues siendo responsable del cumplimiento normativo de tu actividad. En caso de duda, haz que un profesional revise tu proyecto.
¿Cuál es el mejor enfoque para el web scraping con AWS?
Todo depende del tamaño y la duración de tu proyecto:
- AWS Lambda : para un scraping puntual, una ejecución bajo 15 minutos y unos cientos de URL. El nivel gratuito cubre 1 millón de consultas al mes, de forma permanente.
- CE2 : para tareas largas (más de 15 minutos) o para el scraping continuo. Una instancia t3.micro ronda los 7,59 $/mes en On-Demand.
- Fargate : para la paralelización a gran escala, sin tener que gestionar ningún servidor.
En la práctica, empieza en Lambda para hacer pruebas y luego pasa a EC2 o Fargate cuando aumente el volumen. Si prefieres un enfoque sin código, herramientas como Raspador de datos instantáneo permiten recopilar datos directamente desde tu navegador.
¿Puedo usar Selenium en AWS Lambda para el web scraping?
Sí, pero es más complicado de poner en práctica. Selenium y los navegadores sin interfaz gráfica, como Puppeteer son útiles para Extraer datos de páginas con JavaScript. Sin embargo, su configuración en Lambda requiere algunas optimizaciones: tamaño del paquete, gestión de dependencias y memoria asignada.
¿Cómo puedo evitar que una página web alojada en AWS me bloquee el acceso?
Los sitios web suelen detectar los rastreadores y bloquear sus solicitudes. A continuación te ofrecemos algunas tácticas eficaces para reducir los riesgos:
- Modificar periódicamente el encabezado «User-Agent» para parecer más humano.
- Añadir retrasos aleatorios entre cada solicitud.
- Usar proxies rotativos para cambiar tu dirección IP.
- Limitar el número de solicitudes enviadas simultáneamente desde la misma dirección IP.
¿Cómo integrar los datos extraídos en una base de datos?
Una vez recopilados los datos, puedes introducirlos en una base de datos relacional como Amazon RDS (MySQL, PostgreSQL, etc.).
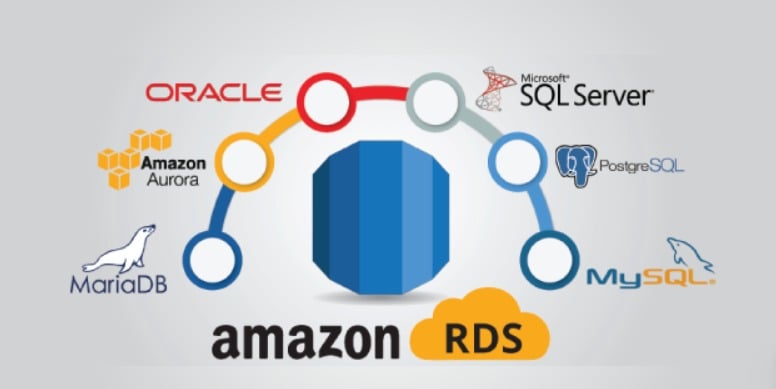
La buena práctica consiste en limpiar y estructurar los datos antes de la inserción. A continuación, puedes automatizar la integración mediante un script de Python o un proceso automatizado, para obtener una base de datos limpia y lista para su uso.
Al combinar la potencia de’AWS y los buenas prácticas de scraping, podrás extraer tus datos de forma eficaz y segura. Si te quedas atascado en algún paso, ¡no dudes en hacernos tus preguntas en los comentarios!








 Español