la raspado web, es la automatización de la recogida de datos en páginas web. Un programa llamado scraper visita las páginas, lee su código HTML y extrae la información útil: precios, datos de contacto, opiniones o contenido de los artículos.
A continuación te explicamos cómo funciona, para qué sirve y cómo empezar, con o sin Python.
Web scraping: ¿qué es?

Todo empieza con un programa automatizado llamado bot de web scraping.
Funciona como un usuario de Internet, pero a gran escala y de forma automática. En concreto, envía una solicitud HTTP a una página web, exactamente igual que si la abrieras en tu navegador, y luego analiza la estructura del documento HTML o XML para extraer los datos útiles.
El proceso se lleva a cabo en tres etapas principales :
- Recuperar la página : EL scraper accede a la URL de destino, como un visitante normal.
- Análisis de páginas : con ayuda de un parser, lee el código de la página web para localizar dónde se encuentra la información que le interesa.
- Extracción de datos : extrae exactamente lo que necesita, por ejemplo, precios, títulos, opiniones o direcciones.
A continuación, los datos recopilados se almacenan en un archivo o en un base de datos. Según las necesidades, el formato puede ser una hoja de cálculo, un archivo CSV o el JSON, listo para su análisis.
Algunos sitios web muestran su contenido directamente en el código HTML: un scraper basta con los métodos clásicos para analizarlos. Otros generan su información a través de JavaScript y solo los cargan una vez que se abre la página. En este caso, se necesita un robot capaz de simular un navegador real para recopilar los datos.
¿Por qué web scraping?
El web scraping no es solo un artilugio técnico. Es una verdadera herramienta estratégica para recopilar datos a gran escala desde cualquier sitio. Automatizas la recopilación de información que, de forma manual, te llevaría horas. Estos son los usos más habituales:
- Análisis de la competencia : realizar un seguimiento de los precios, las novedades y las ofertas de un competidor en su página web, sin necesidad de intervención manual. Ideal para la seguimiento de tarifas en el comercio electrónico.
- Generación de clientes potenciales : recuperar automáticamente contactos específicos de directorios o redes profesionales, respetando la RGPD.
- Investigación académica o estudio de mercado : recopilar grandes volúmenes de datos para realizar estudios sólidos, sin tener que hacer clic en todas partes manualmente.
- Agregación de contenidos : extraer información de varias fuentes y centralizarla en una base de datos. Este es el principio de los comparadores de precios y programas de indexación.
En todos estos casos, la idea sigue siendo la misma: ganar tiempo y obtener una base de datos útil, actualizada y lista para su análisis.
¿Cómo se hace el web scraping?
Hay cuatro opciones en función de tu nivel: las software y herramientas llave en mano, el codificado a medida, los extensiones de los navegadores y los agentes de IA.
1. Con herramientas dedicadas al raspado web
Muchos herramientas de raspado te permiten recopilar datos sin tener que empezar desde cero. Aquí tienes tres referencias fiables.
- Bright Data : una plataforma potente y completa, diseñada para proyectos a gran escala. Reúne apoderados, API y recursos avanzados adaptados a los usos profesionales. Un scraper Si está bien configurado en esta plataforma, puede recopilar millones de datos desde cualquier sitio web.
- Octoparse : uno de los programas más fáciles de usar para empezar. Su interfaz te permite hacer clic en los elementos de una página para definir lo que quieres extraer. Obtienes un scraper Listo para usar en unos minutos, sin escribir ni una sola línea de código.
- Apify : un mercado de scripts listos para usar, con la posibilidad de crear tus propios scrapers personalizados. Esta solución está dirigida sobre todo a perfiles técnicos y a casos complejos.

Si estás empezando o quieres probarlo sin invertir, la mayoría de estos programas ofrecen pruebas gratuitas o fórmulas freemium, lo necesario para poner en marcha tu scraper sin necesidad de prever un presupuesto desde el principio.
2. Con conocimientos de programación
Si tienes conocimientos básicos de programación, el raspado web personalizado te ofrece total libertad. El lenguaje más utilizado es Python, gracias a su sencillez y a su ecosistema, que cuenta con numerosas bibliotecas especializadas. Una biblioteca, en este contexto, es un conjunto de funcionalidades ya programadas y reutilizables que puedes integrar en tus propios scripts.
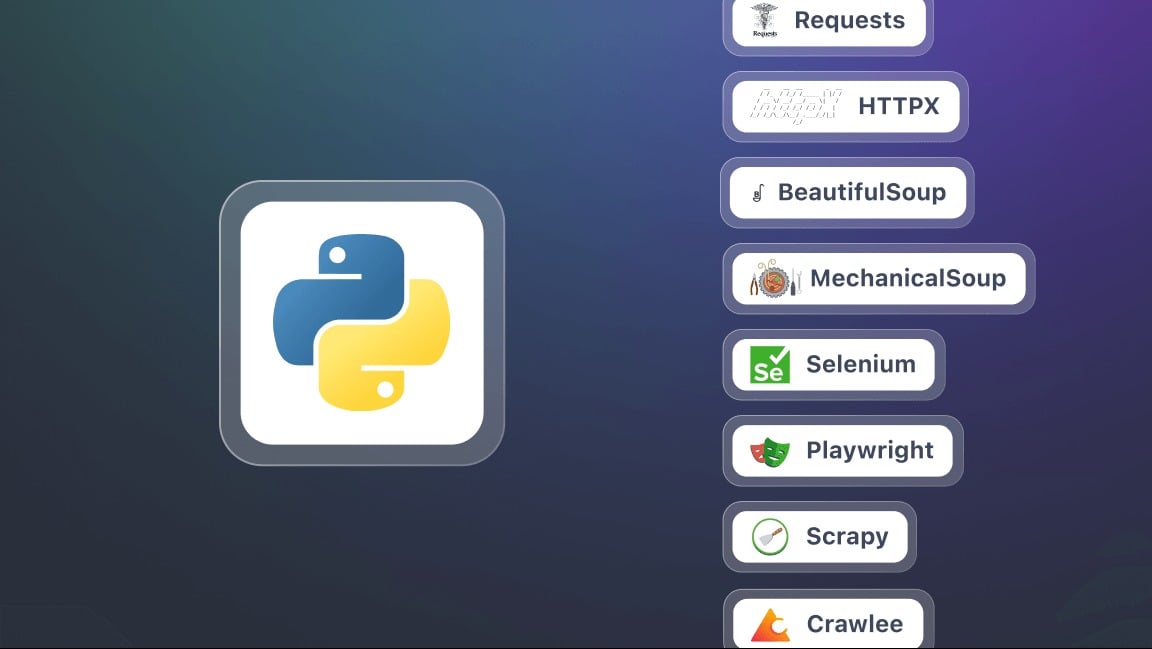
Entre las bibliotecas más populares para web scraping con Python:
- Scrapy : potente y versátil, ideal para proyectos de gran envergadura.
- BeautifulSoup : analiza el código HTML y extrae los datos de una página. Ideal para proyectos sencillos.
- Selenium : un marco de trabajo para la automatización de navegadores disponible en varios lenguajes, entre ellos Python. Permite interactuar con páginas web dinámicas controladas por JavaScript.
Atención: muchos sitios web modernos no cargan todo su contenido de una sola vez. Utilizan JavaScript Donde AJAX que muestran los datos de forma progresiva. En este caso, adopta un navegador sin cabeza (« headless browser«), que carga la página tal y como lo haría un usuario real.
Python no es la única opción. También puedes hacer scraping en PHP con Guzzle para enviar las solicitudes HTTP y Symfony DomCrawler para analizar el código HTML de las páginas.
3. Con extensiones del navegador
Puedes hacer web scraping directamente desde tu navegador gracias a unas extensiones compatibles con Chrome, Edge, Firefox u Opera. Una vez activadas, solo tienes que hacer clic en los elementos de una página para seleccionar y extraer los datos asociados: títulos, precios o imágenes.
No hay no hace falta programar. Todo se realiza a través de una interfaz gráfica. Con unos pocos clics, puedes crear una extracción, previsualizarla en tiempo real y, a continuación, exportar los resultados a formatos habituales como CSV, Excel o JSON.
4. Con métodos avanzados de web scraping
El web scraping evoluciona rápidamente y surgen nuevas técnicas. Entre ellas, el Extracción de datos web con un agente LLM (Large Language Model).

Estos agentes inteligentes, basados en modelos de lenguaje avanzados, son capaces de analizar la estructura de un sitio web de forma autónoma, comprender su contenido y extraer los datos relevantes, sin necesidad de definir reglas estrictas de antemano. En la práctica, se accede a ellas a través de herramientas que combinan IA y automatización.
preguntas frecuentes
¿Cómo puedo hacer web scraping con Python?
El web scraping con Python se basa en tres sencillos pasos :
- Recuperar la página : la biblioteca requests descarga todo el código HTML de la página de destino del sitio web.
- Analizar el HTML : un analizador sintáctico como BeautifulSoup lee la estructura del contenido y lo hace utilizable.
- Extracción de datos : gracias a los selectores HTML, puedes extraer la información útil (títulos, precios, enlaces).
En concreto, un script básico tiene este aspecto: importas requests y BeautifulSoup, tú haces requests.get(url) para obtener el código de la página web, y luego soup.find_all(« h2 ») para seleccionar los elementos deseados. En unas pocas líneas, tus scripts ya recogen datos de forma ordenada y estructurada.
Por ejemplo, en el caso de un sitio web dinámico controlado por JavaScript, requests No basta. Entonces tienes que pasar por Selenium, que automatiza un navegador real para cargar la página como lo haría un usuario real y recopilar toda la información visible.
¿Cómo puedo hacer web scraping sin que me bloqueen?
La mayoría de los sitios web cuentan con mecanismos de protección para limitar los abusos de los robots. Para evitar que te bloqueen, sigue estas recomendaciones:
- Utilice un API dedicada al web scraping cuando existe.
- Limitar el número de solicitudes para no sobrecargar el servidor del sitio.
- Recurrir a proxys para distribuir las direcciones IP de tus robots.
- Definir un User-Agent correcto que imita a un navegador real.
- Respetar el archivo robots.txt del sitio web, que indica a los robots las páginas a las que tienen acceso.
Para proyectos a gran escala, puedes implementar tus scrapers en la nube. Servicios como AWS Lambda Donde EC2 te permiten gestionar la recopilación de datos de forma escalable, con recursos adaptados al volumen.
¿Cuál es la mejor herramienta para el web scraping?
Bright Data es una de las plataformas de referencia para el scraping a gran escala. Esta plataforma ofrece una red de proxies residenciales, un centro de control avanzado y una gestión automatizada de los captchas. Para un uso sin código, Octoparse es una buena alternativa.
La mejor herramienta depende sobre todo de lo que necesites: volumen de datos, presupuesto y conocimientos técnicos disponibles.
¿Es difícil aprender a hacer web scraping?
Todo depende del método que elijas:
- Con programas sin código como Octoparse, el aprendizaje resulta sencillo gracias a una interfaz de tipo «apuntar y hacer clic». Bright Data También ofrece scrapers listos para usar, pero se dirige más bien a los equipos técnicos.
- Con la programación, por ejemplo, en Python o en PHP, se necesitan conocimientos técnicos. La curva de aprendizaje es más larga, pero ganas en flexibilidad a la hora de analizar cualquier página web.
¿Cuál es la diferencia entre el web scraping y las API?
- la raspado web extrae los datos del código HTML de una página web. Simula la navegación humana para recopilar la información visible en un sitio web.
- A API (Interfaz de programación de aplicaciones) permite acceder directamente a los datos estructurados de la página web. Es más fiable y sencillo, ya que no es necesario analizar el código HTML.

El web scraping resulta especialmente útil cuando la página web no ofrece un’API pública. En este caso, un scraper te permite recopilar los datos directamente desde las páginas.
¿Es legal el web scraping?
La legalidad del web scraping depende del contexto y del tipo de datos a los que se dirija.
Normativa clave
En Europa, el RGPD (Reglamento General de Protección de Datos) regula estrictamente el uso de datos personales. Recopilar datos personales en una página web sin una base jurídica válida (consentimiento o interés legítimo, bajo condiciones estrictas) es ilegal.
Él protección de datos La experiencia de los usuarios sigue siendo una prioridad en cualquier proyecto de scraping.
Datos públicos: no es una autorización automática
Los datos no personales La información de libre acceso (precios, horarios) suele poder recopilarse, siempre que se respeten las condiciones generales de uso del sitio web y la legislación sobre bases de datos.
En cuanto un dato permita identificar a una persona, aunque sea una figura pública, el RGPD se aplica.
Condiciones de legalidad
El scraping es legal siempre que respete las condiciones generales de uso del sitio web, los derechos de autor, los derechos sobre las bases de datos y el RGPD. El acoso y la violación de la propiedad intelectual siguen estando prohibidos.
En resumen, el web scraping te permite extraer datos cuando no hay ninguna API disponible. Existen varios métodos, desde el script Python al software sin código.
Mantente siempre dentro del marco legal: cumple con las condiciones generales de uso de la web, haz un uso razonable y respeta el RGPD.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA