det web scraping, det er automatiseringen af indsamlingen af data på hjemmesider. Et program ved navn scraper besøg siderne, læs dem HTML-kode og udtrækker de relevante oplysninger: priser, kontaktoplysninger, anmeldelser eller artikelindhold.
Her kan du læse, hvordan det fungerer, hvad det bruges til, og hvordan du kommer i gang – med eller uden Python.
Webscraping: Hvad er det?

Det hele starter med et automatiseret program kaldet webscraping-bot.
Den fungerer som en internetbruger, men i stor skala og fuldstændig automatisk. Konkret sender den en HTTP-forespørgsel til en webside, præcis som hvis du åbnede den i din browser, og analyserer derefter strukturen i HTML- eller XML-dokumentet for at udtrække de relevante data.
Processen foregår i tre store faser :
- Hentning af siden : DET scraper åbner mål-URL’en, ligesom en almindelig besøgende.
- Sideanalyse : ved hjælp af en parser, han gennemgår webstedets kildekode for at finde ud af, hvor de relevante oplysninger befinder sig.
- Udtræk af data : Den henter netop det, den har brug for, f.eks. priser, titler, anmeldelser eller adresser.
De indsamlede data gemmes derefter i en fil eller en database. Afhængigt af behovet kan formatet være et regneark, en fil CSV eller den JSON, klar til analyse.
Nogle hjemmesider viser deres indhold direkte i HTML-koden: en scraper En klassisk metode er tilstrækkelig til at analysere dem. Andre genererer deres oplysninger via JavaScript og indlæser dem først, når siden er åbnet. I dette tilfælde er der brug for en robot, der kan simulere en rigtig browser for at indsamle dataene.
Hvorfor webscraping?
Webscraping er ikke bare en teknisk leg. Det er en rigtig strategisk værktøj til at indsamle data i stor skala fra ethvert sted. Du automatiserer indsamlingen af oplysninger, som ellers ville tage dig timer at udføre manuelt. Her er de mest almindelige anvendelsesmuligheder:
- Konkurrenceanalyse : Følg med i en konkurrents priser, nye produkter og tilbud på dennes hjemmeside uden manuel indgriben. Ideelt til prisovervågning inden for e-handel.
- Generering af leads : automatisk at hente udvalgte kontakter fra telefonbøger eller professionelle netværk, i overensstemmelse med RGPD.
- Akademisk forskning eller markedsundersøgelse : at indsamle store datamængder til pålidelige undersøgelser, uden at skulle klikke sig frem manuelt overalt.
- Samling af indhold : at udtrække oplysninger fra flere kilder og samle dem i en database. Det er princippet bag prissammenligningssider og indekseringssoftware.
I alle disse tilfælde er tanken den samme: at vinde tid og opnå en brugbar, opdateret og analyseklar database.
Hvordan laver jeg webscraping?
Der findes fire muligheder afhængigt af dit niveau: de software og værktøjer nøglefærdig, den kodet efter mål, de udvidelser browsere og AI-agenter.
1. Med dedikerede webscraping-værktøjer
Mange Skrabeværktøj giver dig mulighed for at indsamle data uden at skulle starte fra bunden. Her er tre pålidelige kilder.
- Bright Data : en kraftfuld og omfattende platform, der er udviklet til store projekter. Den samler fuldmagter, API’er og avancerede ressourcer, der er tilpasset professionelle formål. En scraper En korrekt konfigureret løsning på denne platform kan indsamle millioner af data fra enhver hjemmeside.
- Octoparse : et af de mest brugervenlige programmer til begyndere. Brugergrænsefladen giver dig mulighed for at klikke på elementerne på en side for at angive, hvad du vil udtrække. Du får en scraper klar til brug på få minutter, uden en eneste linje kode.
- Apify : en markedsplads med færdige scripts, hvor du også har mulighed for at oprette dine egne skræddersyede scrapers. Denne løsning henvender sig især til tekniske brugere og komplekse opgaver.

Hvis du er nybegynder eller gerne vil prøve det uden at investere, tilbyder de fleste af disse programmer Gratis prøveversioner eller formler freemium, så du kan komme i gang med din scraper uden at der skal afsættes et budget fra starten.
2. Med programmeringsfærdigheder
Hvis du har grundlæggende kendskab til programmering, så Brugerdefineret webscraping giver dig fuldstændig frihed. Det mest anvendte sprog er Python, takket være dets enkelhed og dets omfattende økosystem af dedikerede biblioteker. Et bibliotek er her en samling af allerede programmerede og genanvendelige funktioner, som du kan integrere i dine egne scripts.
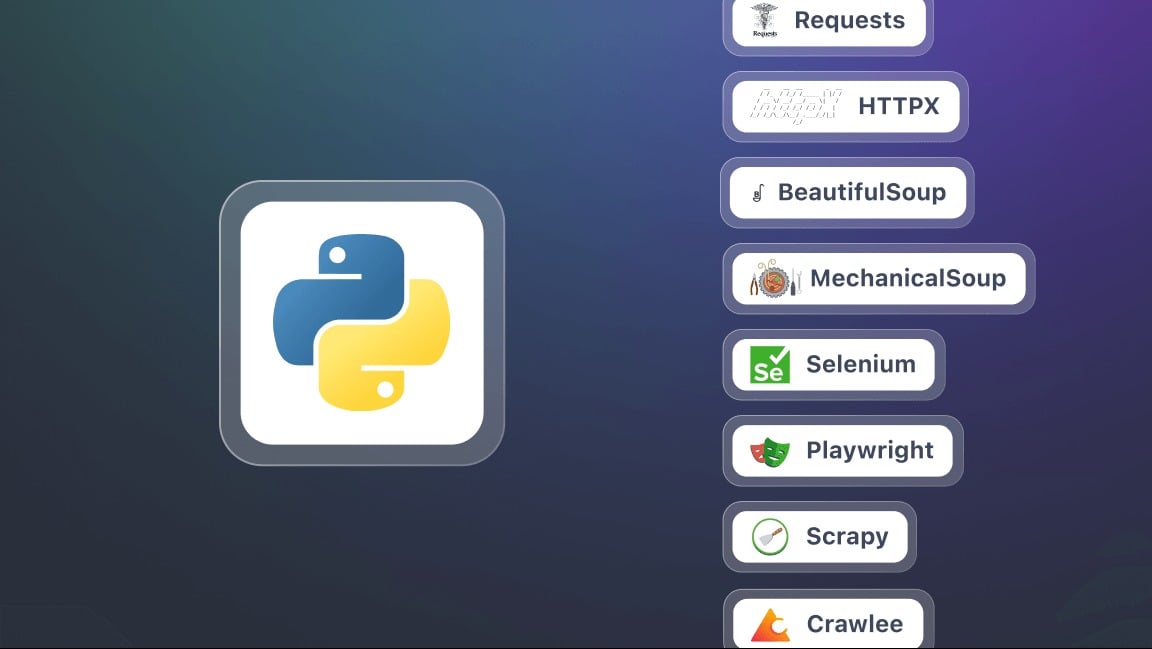
Blandt de mest populære biblioteker til web scraping med Python:
- Scrapy : kraftfuld og fleksibel, ideel til store projekter.
- BeautifulSoup : analyserer HTML-koden og udtrækker data fra en side. Perfekt til enkle projekter.
- Selenium : et framework til browserautomatisering, der findes i flere programmeringssprog, herunder Python. Det gør det muligt at interagere med dynamiske websider, der styres af JavaScript.
Bemærk: Mange moderne hjemmesider indlæser ikke alt deres indhold på én gang. De bruger JavaScript Hvor AJAX der viser dataene gradvist. I dette tilfælde anvender man en hovedløs browser (« headless browser« ), som indlæser siden, ligesom en rigtig bruger ville gøre.
Python er ikke den eneste mulighed. Du kan også lave scraping i PHP med Guzzle for at sende HTTP-forespørgsler og Symfony DomCrawler for at analysere siderne HTML-kode.
3. Med browserudvidelser
Du kan lave webscraping direkte fra din browser ved hjælp af udvidelser, der er kompatible med Chrome, Edge, Firefox eller Opera. Når de er aktiveret, skal du blot klikke på elementerne på en side for at vælge og udtrække de tilhørende data: overskrifter, priser eller billeder.
Der er ingen der er ingen grund til at programmere. Det hele foregår via en grafisk brugergrænseflade. Med blot et par klik kan du oprette en udtrækning, få et eksempel på den i realtid og derefter eksportere resultaterne til almindelige formater som CSV, Excel eller JSON.
4. Med avancerede metoder til webscraping
Webscraping udvikler sig hurtigt, og der dukker hele tiden nye teknikker op. Blandt disse er webscraping med en LLM-agent (Large Language Model).

Disse intelligente agenter, der er baseret på avancerede sprogmodeller, er i stand til selvstændigt at analysere strukturen på et websted, forstå dets indhold og udtrække de relevante data uden, at der på forhånd skal fastlægges strenge regler. I praksis får du adgang til dette via værktøjer, der kombinerer AI og automatisering.
Ofte stillede spørgsmål
Hvordan kan jeg lave webscraping med Python?
Webscraping med Python bygger på tre enkle trin :
- Hent siden : biblioteket requests henter al HTML-koden fra den pågældende side på webstedet.
- Analysere HTML-koden : en parser som BeautifulSoup læser indholdets struktur og gør den anvendelig.
- Udtræk af data : Ved hjælp af HTML-selektorer kan du hente de relevante oplysninger (titler, priser, links).
Konkret ser et minimalt script sådan ud: Du importerer requests og BeautifulSoup, du gør requests.get(url) for at hente webstedets kode, og derefter soup.find_all(« h2 ») for at udvælge de ønskede elementer. Med blot et par linjer indsamler dine scripts allerede data på en overskuelig og struktureret måde.
For eksempel for et dynamisk websted, der styres af JavaScript, requests er ikke nok. Så går du videre til Selenium, som automatiserer en rigtig browser til at indlæse siden som en rigtig bruger og indsamle alle de synlige oplysninger.
Hvordan kan jeg lave webscraping uden at blive blokeret?
De fleste hjemmesider har beskyttelsesmekanismer for at begrænse misbrug fra robotter. For at undgå at blive blokeret bør du følge disse anbefalinger:
- Brug en API til webscraping når den findes.
- Begræns antallet af anmodninger for ikke at overbelaste hjemmesidens server.
- Gå via proxys for at fordele IP-adresserne på dine robotter.
- Definér en User-Agent en korrekt browser, der efterligner en rigtig browser.
- Overhold filen robots.txt på webstedet, som angiver, hvilke sider robotterne har adgang til.
Ved store projekter kan du køre dine scrapers i skyen. Tjenester som AWS Lambda Hvor EC2 giver dig mulighed for at administrere dataindsamlingen på en skalerbar måde med ressourcer, der er tilpasset datamængden.
Hvad er det bedste værktøj til webscraping?
Bright Data er blandt de førende løsninger inden for scraping i stor skala. Denne platform tilbyder et netværk af private proxyservere, et avanceret kontrolcenter og automatiseret håndtering af captchaer. Til brug uden kodning, Octoparse er et godt alternativ.
Hvilket værktøj der er bedst, afhænger først og fremmest af dine behov: datamængde, budget og de tilgængelige tekniske kompetencer.
Er webscraping svært at lære?
Det afhænger helt af, hvilken metode du vælger:
- Med no-code-software som Octoparse, er det nemt at lære at bruge programmet takket være en »point-and-click«-brugergrænseflade. Bright Data tilbyder også færdige scrapers, men henvender sig primært til tekniske teams.
- Med programmering, for eksempel i Python eller PHP, kræver det teknisk viden. Indlæringskurven er længere, men du får større fleksibilitet til at analysere enhver hjemmeside.
Hvad er forskellen mellem webscraping og API'er?
- det web scraping udtrækker data fra HTML-koden på en webside. Den simulerer menneskelig navigation for at indsamle de oplysninger, der er synlige på et websted.
- EN API (Application Programming Interface) giver direkte adgang til webstedets strukturerede data. Det er mere pålideligt og enklere, da man ikke behøver at analysere HTML-koden.

Webscraping er især nyttigt, når hjemmesiden ikke tilbyder en’Offentlig API. I dette tilfælde er en scraper giver dig mulighed for at indsamle data direkte fra siderne.
Er webscraping lovligt?
Lovligheden af webscraping afhænger af konteksten og den type data, der er tale om.
Vigtige regler
I Europa er RGPD (Den generelle forordning om databeskyttelse) fastlægger strenge rammer for brugen af personlig data. Det er ulovligt at indsamle personoplysninger på et websted uden et gyldigt retsgrundlag (samtykke eller berettiget interesse, under strenge betingelser).
Det databeskyttelse Brugernes interesser er fortsat en prioritet i ethvert scraping-projekt.
Offentlige data: ikke automatisk grønt lys
Dataene ikke-personlige Oplysninger, der er frit tilgængelige (priser, åbningstider), kan generelt indsamles, under forbehold af webstedets brugsbetingelser og databaseretten.
Så snart en oplysning gør det muligt at identificere en person, selv en offentlig person, er RGPD gælder.
Betingelser for lovlighed
Scraping er lovligt, når det overholder webstedets brugsbetingelser, ophavsretten, databaseretten og RGPD. Chikane og krænkelse af intellektuel ejendomsret er fortsat forbudt.
Kort sagt giver web scraping dig mulighed for at udtrække data, når der ikke findes nogen API. Der findes flere metoder, fra Python-script til software uden kodning.
Hold dig altid inden for lovens rammer: overholdelse af hjemmesidens brugsbetingelser, rimelig brug og overholdelse af RGPD.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA