PHP bruges ikke kun til at oprette dynamiske hjemmesider. Med biblioteker som Guzzle og Goutte, kan du bygge en funktionel scraper og automatisk udtrække data fra enhver webside.
Virksomhederne bruger det til at overvåge priser, analysere sociale medier eller indsamle oplysninger om deres konkurrenter.
Forudsætninger for scraping med PHP
det web scraping består i automatisk at udtrække data fra websider. Et program gennemgår HTML fra et websted, udvælger de relevante oplysninger og gemmer dem derefter i en fil eller en database. I PHP, der skal kun nogle få biblioteker til at lave en velfungerende scraper, men inden du går i gang, skal du tjekke, om du opfylder følgende betingelser:
- At have Grundlæggende PHP-programmering, for du skal skrive kode til at styre udtrækningen.
- At mestre nogle grundlæggende kendskab til HTML og CSS, for præcist at udvælge de elementer på siden, der skal udtrækkes.
- At kunne bruge Drejeskive, værktøjet, der administrerer PHP-afhængigheder og installerer biblioteker som Guzzle, Symfony DomCrawler eller Goutte.
- At have en lokal webserver For at køre dit program: XAMPP, WAMP Hvor MAMP fungerer rigtig godt.
- Installere en kode-editor til at skrive og organisere dine PHP-scripts.
Når du har samlet disse værktøjer, er du klar til at indsamle og analysere de data, der interesserer dig. Hvis du leder efter gratis værktøjer Hvis man vil komme i gang uden at bruge penge, findes der flere muligheder, der er velegnede til begyndere.
Hvilke værktøjer er vigtige for webscraping med PHP?
PHP alene er ikke nok til at udføre webscraping effektivt. Det er biblioteker installeret via Composer der gør udtrækningen hurtig og pålidelig. Her er de værktøjer, du bør kende.
1. Guzzle: HTTP-klienten
Guzzle er her det mest benyttede bibliotek til at sende HTTP-anmodninger. Det er denne, der henter kildekoden til en webside. For at installere den skal du åbne din terminal, gå ind i din projektmappe og derefter skrive:
composer kræver guzzlehttp/guzzleComposer Download biblioteket, så kan du bruge det direkte i din kode. Du kan læse den officielle dokumentation til Guzzle for at lære mere.
Her er et simpelt eksempel på hent indholdet af en URL :
request('GET', $url);

    // Hent HTTP-koden
    $statusCode = $response->getStatusCode();

    // Hent sidens indhold
    $content = $response->getBody()->getContents();

    echo "HTTP-kode: " . $statusCode . PHP_EOL;
    echo "Sideindhold:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Fejl: " . $e->getMessage();
}
2. Symfony DomCrawler og Goutte: dataudtræk
Når HTML-koden er hentet, skal den analyseres for at udtrække de relevante data. Der findes to biblioteker, der er meget nyttige til dette formål:
- Symfony DomCrawler : den gør det muligt at navigere i HTML-koden ved hjælp af CSS-selektorer og at udvælge bestemte elementer (titel, pris, link …).
- Goutte : Det er en wrapper til Guzzle og DomCrawler, der i høj grad forenkler scraping-processen.
At notere : pakken Goutte er i dag udfaset og arkiveret siden 2022. Til et nyt projekt foretrækker jeg Symfony BrowserKit med DomCrawler, Hvor Symfony Panther hvis du skal håndtere indhold, der indlæses via JavaScript. Du kan også kigge nærmere på fremgangsmåden med Laravel, som tilbyder en struktureret ramme for denne type projekt.
Eksempel med Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// Udvælgelse efter klasse
$crawler->filter('.my-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Udvælgelse efter ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Udvælgelse efter tag
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Eksempel med Goutte:
request('GET', 'https://exemple.com');

// Udvælgelse efter klasse
$crawler->filter('.ma-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Udvælgelse efter ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Udvælgelse efter tag
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Andre biblioteker og værktøjer
Hvis du vil gå mere i dybden, findes der andre værktøjer, der kan tilpasses dine behov afhængigt af den mængde data, der skal indsamles.
- PHP-Scraper : et bibliotek, der gør det lettere at udtrække oplysninger ved at håndtere kompleksiteten i HTML og selektorer. Det egentlige navn på pakken er ikke »Goutte«.
# Installation med Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Sidens titel: " . $web->title;
- Lyse data : en professionel platform til dataindsamling i stor skala, med indbyggede proxyservere for at undgå IP-blokering.

- ScraperAPI : en cloudbaseret webscraping-tjeneste, der er tilgængelig via en API. Du sender blot en forespørgsel med angivelse af den URL, der skal scrapes, og tjenesten tager selv hånd om proxyserverne.
Hvordan laver jeg en simpel webscraper i PHP?
Sådan bygger man en Funktional scraper i PHP med Goutte, trin for trin: opsætning af et bibliotek, hentning af HTML, udtrækning af data og derefter eksport.
Trin 1: Installation af afhængigheder
Brug Drejeskive for at installere Goutte med denne kommando:
compose kræver fabpot/goutte
Trin 2: Hentning af sideindhold
Lav en HTTP GET-anmodning for at hente sidens HTML-indhold. Her er grundkoden:
request('GET', $url);

// Hent den rå HTML, hvis det er nødvendigt
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // preview
Trin 3: Udtræk data
Når HTML-koden er hentet, kan du målrette mod bestemte elementer ved hjælp af en CSS-vælger (Hvor XPath). Her er et eksempel på udtrække overskrifterne på en blogside. Selektoren element h2 målretter mod tags <h2> inde i fyrtårnene . :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Hvad denne kode gør:
- Vælgeren
element h2fokuserer på titlerne i tags<h2>. - Metoden
tekst()henter teksten fra hver overskrift. - Hvert værdipapir føjes til tabellen
$itler, og derefter vist medprint_r().
CSS-selektorer bruges også til at udtrække attributter HTML-elementer. Hvis hver overskrift er et link i en tag <a>, henter du attributten href for at få artiklens URL:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
Bordet $itler indeholder således for hver vare både titel og dens link :
Array
(
    [0] => Array
        (
            [title] => Artikel 1 titel
            [url] => /artikel1
        )

    [1] => Array
        (
            [title] => Artikel 2 titel
            [url] => /artikel2
        )
)
Hver post er en associeret tabel med to nøgler: titel til titlen og url til sidens adresse. Du får en overskuelig struktur, der er klar til at blive analyseret eller gemt.
Fase 4: Strukturering og lagring af data
Når dataene er hentet ind i tabellen $data, du kan eksportere i et struktureret format. De to mest nyttige formater er JSON og CSV.
det JSON er praktisk til at levere data til et API eller en webapplikation:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
Filen eksport.json vil se sådan ud:
[
    {
        "title": "Titel på artikel 1",
        "url": "/article1"
    },
    {
        "title": "Artikel 2 titel",
        "url": "/article2"
    }
]
Hvis du foretrækker en tabel CSV, brug fputcsv for at skrive hver linje til en fil:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
Filen eksport.csv vil se sådan ud:
titel,url
Artikeltitel 1,/artikel1
Titel på artikel 2,/article2
Ved store datamængder skal du huske at skrive til filen gradvist i stedet for at indlæse det hele i hukommelsen. Du kan også gemme resultatet direkte i en database, hvilket derefter gør det lettere at analysere og opdatere de indsamlede oplysninger.
Hvordan kan jeg håndtere almindelige problemer med webscraping i PHP?
Webscraping i PHP går ikke altid som planlagt. En server, der ikke svarer, en side med fejl i opbygningen, en IP-blokering: sådanne problemer opstår hurtigt. Her kan du se, hvordan du håndterer de mest almindelige problemer for at gøre dit udtrækprogram mere pålideligt.
1. Håndtering af fejl
- Forbindelsesfejl
Nogle gange når anmodningen slet ikke frem til serveren. Du kan støde på "Intet netværk, "Ugyldig URL Hvor "Serveren er utilgængelig. I så fald skal du indsætte en blok try/catch for at undgå, at dit script pludselig stopper.
Her er et konkret eksempel med Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- HTTP-statuskoder
Selv når forbindelsen fungerer, kan serveren svare med en fejl: 404 = siden blev ikke fundet, 500 = intern serverfejl. Du kan teste den returnerede kode med getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Parsing-fejl
Parsing er’HTML-analyse ved hjælp af din scraper. Hvis siden er forkert opbygget, DomCrawler Hvor Goutte kan gå ned eller ikke returnere noget. Kontroller altid, at indholdet findes, før du forsøger at hente det, med betingelser som count() Hvor filter(), og sæt derefter en try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Omgå begrænsninger og beskyttelse mod scraping
Mange hjemmesider indfører sikkerhedsforanstaltninger for at gøre webscraping vanskeligere. Her er de vigtigste hindringer og hvordan man håndterer dem korrekt:
- IP-blokering : Når du sender for mange forespørgsler, kan hjemmesiden blokere din IP-adresse. Løsningen er at bruge roterende proxyservere, ligesom dem fra Bright Data, for at fordele dine forespørgsler på flere adresser.
- Interval mellem forespørgsler : Fordel dine opkald over tid for at undgå at vække opmærksomhed og ikke overbelaste målserveren.
- Indhold i JavaScript Som standard kan PHP ikke Kør JavaScript. For at scrape en side, hvis indhold indlæses dynamisk, skal du bruge en hovedløs browser (headless browser). Værktøjer som Puppeteer Hvor Selenium gengiver siden som i en rigtig browser, inden den hentes.
- Robots.txt-filen : Inden du kører din scraper, skal du tjekke denne fil i webstedets rodmappe. Den angiver, hvad webstedet tillader og ikke tillader for robotter – et vigtigt skridt for at handle ansvarligt.
Ofte stillede spørgsmål
Er webscraping lovligt?
Det Lovligheden af webscraping afhænger af de indsamlede data og af, hvordan du udnytter dem. I Frankrig er det at scrape offentlige og ikke-personlige data tolereres generelt, men det er ikke automatisk en grøn lys.
Der er tre juridiske begrænsninger, der kan gøre dataudtræk ulovligt, selv på offentlige sider:
- det RGPD : Så snart der er tale om personoplysninger, betyder «offentlig» ikke, at de er frit tilgængelige.
- Det Brugsbetingelser for hjemmesiden : Hvis du bruger en konto til at få adgang til indholdet, har du accepteret vilkår, der ofte forbyder scraping.
- det sui generis-ret om databaser: I Europa er en database omfattet af en særlig beskyttelse.
I praksis vurderes hvert enkelt tilfælde individuelt. Se altid filen robots.txt og vilkårene for brug af hjemmesiden, inden du starter dit program.
Hvad er forskellen mellem webscraping og webcrawling?
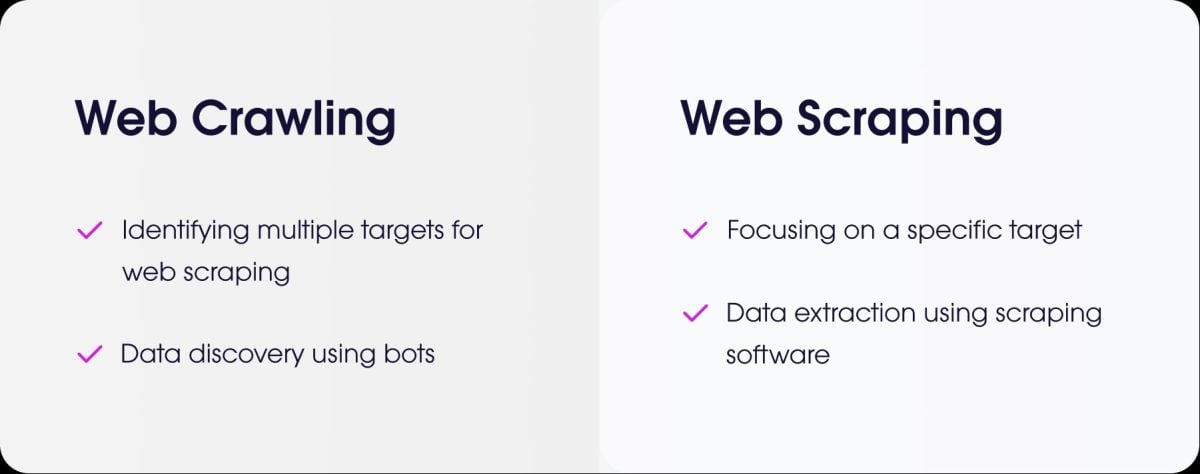
- det web scraping er at udtrække præcise data på en hjemmeside.
- det Gennemsøgning af nettet er at gennemgå sider for at indeksere dem, ligesom en søgemaskinerobot gør.
Hvordan scraper jeg et websted, der kræver autentificering (login)?
For at scrape en hjemmeside, der kræver en login, skal man simulere godkendelse. Med PHP er den mest almindelige løsning stadig Guzzle. Du sender dine loginoplysninger via en anmodning STOLPE, og så lader du sessionen være åben for at hente de beskyttede sider.
Hvordan håndterer du scraping af websteder med dynamiske sider, der indlæses i AJAX?
PHP kan ikke køre JavaScript-kode på klientsiden. Det indhold, der indlæses i AJAX kan derfor ikke opfanges af en almindelig scraper.
En første løsning er at bruge BrowserShot, et bibliotek, der bygger på en rigtig browser i baggrunden (Headless Chrome) for at indlæse siden og køre JavaScript.
Du kan også integrere PHP med værktøjer baseret på Node.js, som Puppeteer Hvor Selenium, for at generere den endelige HTML-kode og derefter hente dataene fra dit script.
Er der nogen alternativer til PHP til webscraping?
Ja, der er flere sprog, der er meget populære til web-scraping:
- Python, med sine kraftfulde biblioteker som BeautifulSoup og Scrapy.
- Node.js, meget effektiv til dynamiske websteder via biblioteker som Puppeteer Hvor Cheerio.

Hvordan programmerer man en scraper på en etisk og ansvarlig måde?
For at udføre scraping på en ansvarlig måde er der nogle enkle regler, man bør følge:
- Kontroller filen robots.txt på hjemmesiden for at læse adgangsreglerne.
- Begræns antallet af dine forespørgsler for ikke at overbelaste serveren.
- Overhold brugsbetingelserne af stedet.
- Indsamler ikke personoplysninger uden tilladelse.
Webscraping er en effektiv metode, forudsat at man bruger den systematisk og med sund fornuft. Og hvad med dig, har du allerede oprettet en scraper i PHP Eller med et andet sprog? Del dine erfaringer med os i kommentarerne!








 DA