PHP служит не только для создания динамических сайтов. С помощью таких библиотек, как Guzzle а также Goutte, ты можешь построить рабочий скребок и автоматически извлекать данные с любой веб-страницы.
Компании используют его для мониторинга цен, анализа социальных сетей или сбора информации о своих конкурентах.
Необходимые условия для выполнения скраппинга с помощью PHP
в скраппинг заключается в автоматическом извлечении данных с веб-страниц. Программа просматривает HTML сайта, отбирает полезную информацию, а затем сохраняет её в файле или базе данных. В PHP, для создания рабочего скрейпера достаточно нескольких библиотек, но прежде чем приступить к работе, убедись, что ты соответствуешь следующим требованиям:
- Наличие основы программирования на PHP, так как тебе предстоит написать код для управления процессом извлечения.
- Освоить несколько основы HTML и CSS, чтобы точно определить элементы на странице, которые необходимо извлечь.
- Уметь пользоваться Наберите, инструмент, который управляет зависимостями PHP и устанавливает библиотеки, такие как Guzzle, Symfony DomCrawler или Goutte.
- Наличие локальный веб-сервер Чтобы запустить свою программу: XAMPP, WAMP Где MAMP отлично подходят для этой цели.
- Установить редактор кода для написания и организации твоих PHP-скриптов.
Как только ты соберёшь все эти инструменты, ты будешь готов к сбору и анализу интересующих тебя данных. Если ты ищешь бесплатные инструменты Чтобы начать, не тратя денег, есть несколько вариантов, подходящих для новичков.
Какие инструменты необходимы для веб-скраппинга с помощью PHP?
Одного PHP недостаточно для эффективного веб-парсинга. Для этого нужны библиотеки, установленные через Composer которые обеспечивают быструю и надёжную добычу. Вот инструменты, о которых стоит знать.
1. Guzzle: HTTP-клиент
Guzzle здесь самая популярная библиотека для отправки HTTP-запросов. Именно она извлекает исходный код веб-страницы. Чтобы установить её, открой терминал, перейди в папку своего проекта и введи:
composer require guzzlehttp/guzzleComposer загрузи библиотеку и сразу же начни использовать её в своём коде. Для получения более подробной информации ты можешь ознакомиться с официальной документацией по Guzzle.
Вот простой пример для получение содержимого URL-адреса :
request('GET', $url);

    // Получение HTTP-кода
    $statusCode = $response->getStatusCode();

    // Получение содержимого страницы
    $content = $response->getBody()->getContents();

    echo "Код HTTP : " . $statusCode . PHP_EOL;
    echo "Содержание страницы:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Ошибка: " . $e->getMessage();
}
2. Symfony DomCrawler и Goutte: извлечение данных
После получения HTML-кода его необходимо проанализировать, чтобы извлечь из него нужные данные. Для этого очень удобно использовать две библиотеки:
- Symfony DomCrawler : она позволяет перемещаться по HTML с помощью Селекторы CSS и выделять конкретные элементы (заголовок, цена, ссылка…).
- Goutte : это обёртка для Guzzle и DomCrawler, которая значительно упрощает процесс скрапинга.
Отметить : пакет Goutte сегодня выведен из обращения и архивирован с 2022 года. При работе над новым проектом лучше Symfony BrowserKit с DomCrawler, Где Symfony Panther если тебе приходится работать с контентом, загружаемым с помощью JavaScript. Ты также можешь ознакомиться с подходом, использующим Laravel, который обеспечивает четкую структуру для реализации подобных проектов.
Пример с Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// Выборка по классу
$crawler->filter('.my-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Выборка по ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Выборка по тегам
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Пример с Goutte:
request('GET', 'https://exemple.com');

// Выборка по классу
$crawler->filter('.ma-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Выборка по ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Выборка по тегам
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Другие библиотеки и инструменты
Если тебе нужно больше возможностей, существуют и другие инструменты, которые можно подобрать в зависимости от объема собираемых данных.
- PHP-скрейпер : библиотека, упрощающая извлечение информации за счёт устранения сложностей, связанных с HTML и селекторами. На самом деле это не пакет Goutte.
# Установка с помощью Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Заголовок страницы: " . $web->title;
- Яркие данные : профессиональная платформа для сбор данных в широком масштабе, со встроенными прокси-серверами для обхода блокировки IP-адресов.

- ScraperAPI : облачный сервис для веб-парсинга, доступный через API. Достаточно отправить простой запрос с указанием URL-адреса для сбора данных, и сервис сам позаботится о прокси-серверах.
Как создать простой веб-скребок на PHP?
Вот как собрать рабочий скрейпер на PHP с Goutte, шаг за шагом: установка библиотеки, получение HTML-кода, извлечение данных, а затем экспорт.
Шаг 1: Установка зависимостей
Использует Наберите установить Goutte с помощью этой команды:
compose require fabpot/goutte
Шаг 2: Получение содержимого страницы
Сделай HTTP GET запрос чтобы извлечь HTML-содержимое страницы. Вот базовый код:
request('GET', $url);

// Получение необработанного HTML, если требуется
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // предварительный просмотр
Шаг 3: Извлечение данных
После получения HTML-кода ты выделяешь конкретные элементы с помощью CSS-селектор (Где XPath). Вот пример для извлечь заголовки страницы блога. Селектор элемент h2 нацеливается на теги <h2> внутри маяков <article> :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Что делает этот код:
- Селектор
элемент h2выделяет текст в тегах<h2>. - Метод
text()извлекает текст каждого заголовка. - Каждая позиция добавляется в таблицу
1TP65Названия, а затем отображается с помощьюprint_r().
Селекторы CSS также используются для извлечь атрибуты HTML-элементов. Если каждый заголовок представляет собой ссылку в теге <a>, ты извлекаешь атрибут href чтобы получить URL статьи:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
Стол 1TP65Названия содержит тогда для каждой позиции одновременно и название и его связь :
Массив
(
    [0] => Array ()
        (
            [title] => Заголовок статьи 1
            [url] => /article1
        )

    [1] => Array ( [1] => Array )
        (
            [title] => Заголовок статьи 2
            [url] => /article2
        )
)
Каждая запись представляет собой ассоциативный массив с двумя ключами: заголовок для названия и url для адреса страницы. В результате получается упорядоченная структура, готовая к анализу или сохранению.
Этап 4: структурирование и хранение данных
После того как данные будут выгружены в таблицу $data, ты можешь их экспортировать в структурированном формате. Двумя наиболее полезными форматами являются JSON и CSV.
в JSON удобно для передачи данных в API или веб-приложение:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
Файл export.json будет выглядеть следующим образом:
[
    {
        "title": "Заголовок статьи 1",
        "url": "/article1"
    },
    {
        "title": "Заголовок статьи 2",
        "url": "/article2"
    }
]
Если тебе больше нравится таблица CSV, использует fputcsv чтобы записать каждую строку в файл:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
Файл export.csv будет выглядеть следующим образом:
название,url
Заголовок статьи 1,/article1
Заголовок статьи 2,/article2
Если объем данных большой, не забудь записать в файл постепенно вместо того, чтобы загружать всё в память. Ты также можешь сразу сохранить результат в база данных, что впоследствии облегчает анализ и обновление собранной информации.
Как справиться с распространенными проблемами веб-скреппинга в PHP?
Веб-парсинг на PHP не всегда проходит так, как запланировано. Сервер, который не отвечает, неправильно сформированная страница, блокировка по IP-адресу: такие проблемы возникают очень быстро. Вот как справиться с наиболее распространёнными из них, чтобы повысить надёжность вашей программы для извлечения данных.
1. Управление ошибками
- Ошибки подключения
Иногда запрос даже не доходит до сервера. Ты можешь столкнуться с "Нет сети, "Недопустимый URL Где "Сервер недоступен. В этом случае предусмотри блок try/catch чтобы твой скрипт не завершился внезапно.
Вот конкретный пример с Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Коды состояния HTTP
Даже если соединение работает, сервер может ответить сообщением об ошибке: 404 = страница не найдена, 500 = внутренняя ошибка сервера. Ты можешь протестировать код, возвращаемый с помощью getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Ошибки парсинга
Разбор текста — это…’анализ HTML с помощью твоего скрейпера. Если страница оформлена некорректно, DomCrawler Где Goutte могут зависать или не возвращать никаких результатов. Всегда проверяйте наличие содержимого перед попыткой его извлечения, используя такие условия, как count() Где filter(), а затем заключает синтаксический анализ в try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Обход ограничений и средств защиты от скрапинга
Многие веб-сайты внедряют меры защиты, чтобы затруднить веб-парсинг. Ниже приведены основные препятствия и способы их правильного преодоления:
- Блокировка по IP-адресу : если ты отправляешь слишком много запросов, сайт может заблокировать твой IP-адрес. Решением этой проблемы является использование ротационные прокси, такие как Bright Data, чтобы распределить твои запросы по нескольким адресам.
- Интервал между запросами : распределяйте свои звонки во времени, чтобы оставаться незамеченными и не перегружать целевой сервер.
- Содержимое на JavaScript по умолчанию PHP не может запустить JavaScript. Чтобы скопировать страницу, содержание которой загружается динамически, тебе понадобится безголовый браузер (браузер без интерфейса). Такие инструменты, как Puppeteer Где Selenium отображают страницу как в настоящем браузере перед извлечением.
- Файл robots.txt : прежде чем запустить свой скрейпер, проверь этот файл в корневой папке сайта. В нём указано, что сайт разрешает, а что запрещает для роботов — это ключевой шаг для ответственного поведения.
Часто задаваемые вопросы
Законен ли веб-скрепинг?
La Законность веб-скреппинга зависит от собранных данных и от того, как ты их используешь. Во Франции скрапинг общедоступные и неличные данные Как правило, это допускается, но это не означает автоматического одобрения.
Существуют три правовых ограничения, из-за которых извлечение данных может быть признано незаконным даже с общедоступных страниц:
- в RGPD : когда речь идет о персональных данных, термин «общедоступный» не означает, что эти данные можно использовать без ограничений.
- Les Условия использования сайта : если ты используешь учетную запись для доступа к контенту, это означает, что ты согласился с условиями, которые зачастую запрещают скрапинг.
- в право sui generis О базах данных: в Европе база данных пользуется особой защитой.
На практике каждый случай рассматривается индивидуально. Всегда обращайся к файлу robots.txt и ознакомься с условиями использования сайта, прежде чем запускать свою программу.
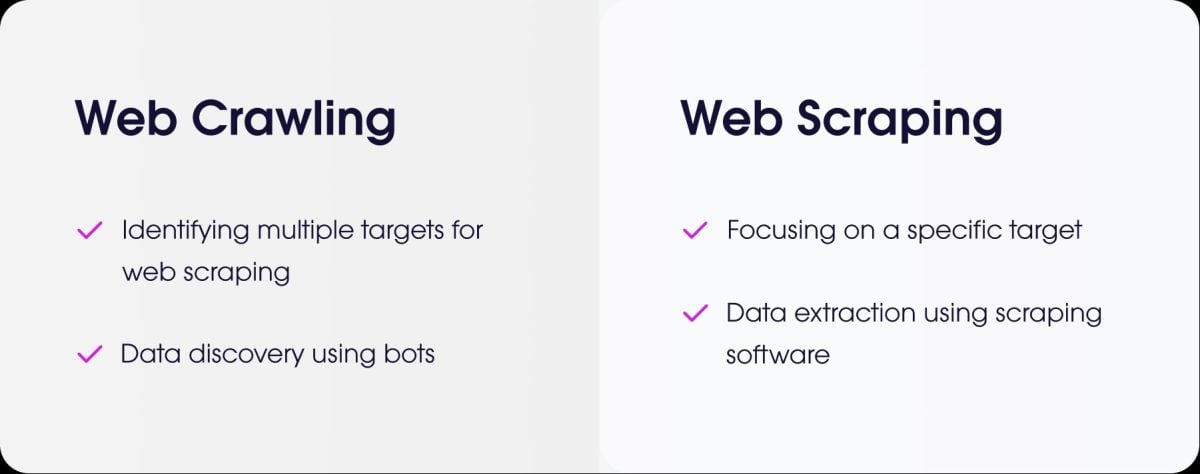
В чем разница между веб-скребком и веб-кроулингом?
- в скраппинг заключается в том, чтобы извлекать точные данные на веб-сайте.
- в просмотр веб-страниц заключается в том, чтобы просматривать страницы для их индексации, как это делает робот поисковой системы.
Как соскрести сайт, требующий аутентификации (входа)?
Чтобы скопировать данные с сайта, требующего входа в систему, необходимо симулировать аутентификацию. В PHP наиболее распространённым решением по-прежнему остаётся Guzzle. Ты отправляешь свои учетные данные с помощью запроса ПОЧТА, а затем оставь сессию открытой, чтобы получить доступ к защищенным страницам.
Как вы управляете скраппингом сайтов с динамическими страницами, загружаемыми в AJAX?
PHP не может выполнять клиентский код JavaScript. Содержимое, загруженное в AJAX поэтому не попадает в поле зрения обычного скрейпера.
Один из вариантов решения заключается в использовании BrowserShot, библиотека, в основе которой лежит реальный браузер, работающий в фоновом режиме (Headless Chrome), чтобы загрузить страницу и выполнить код JavaScript.
Ты также можешь интегрировать PHP с инструментами, основанными на Node.js, в качестве Puppeteer Где Selenium, чтобы сгенерировать конечный HTML-код, а затем получить данные из твоего скрипта.
Есть ли альтернативы PHP для веб-скреппинга?
Да, для скрапинга широко используются несколько языков программирования:
- Python, с такими мощными библиотеками, как BeautifulSoup а также Scrapy.
- Node.js, что очень эффективно для динамических сайтов благодаря использованию таких библиотек, как Puppeteer Где Cheerio.

Как разработать скрейпер с соблюдением этических норм и принципов ответственного подхода?
Чтобы заниматься скрейпингом ответственно, необходимо соблюдать несколько простых правил:
- Проверь файл robots.txt на сайте, чтобы ознакомиться с правилами доступа.
- Ограничь частоту своих запросов чтобы не перегружать сервер.
- Соблюдайте условия использования сайта.
- Не собирает персональные данные без разрешения.
Веб-скрейпинг — это мощный инструмент, при условии, что его использовать методично и с здравым смыслом. А ты уже создавал скребок в PHP или на другом языке? Поделитесь своим опытом в комментариях!








 RU