PHP 動的なサイトを作成するためだけのものではありません。次のようなライブラリを使えば、 Guzzle と Goutte, あなたは~を作ることができます 機能的なスクレイパー そして、あらゆるウェブページからデータを自動的に抽出します。.
企業は、価格の監視、ソーシャルメディアの分析、あるいは競合他社に関する情報の収集などにこれを利用している。.
PHPでスクレイピングするための前提条件
the ウェブスクレイピング ウェブページからデータを自動的に抽出することです。プログラムが HTML あるサイトから、有用な情報を抽出し、それらをファイルやデータベースに保存します。そして、 PHP, 、機能するスクレイパーを構築するにはいくつかのライブラリがあれば十分ですが、始める前に、以下の条件を満たしているか確認してください:
- 持つこと PHPプログラミングの基礎, 、というのも、抽出処理を制御するためのコードを書くことになるからです。.
- いくつか習得する HTMLとCSSの基礎知識, 、ページから抽出する要素を正確に指定するため。.
- 使い方を身につける ダイヤル, 、PHPの依存関係を管理し、次のようなライブラリをインストールするツールです Guzzle, 、Symfony DomCrawler または Goutte.
- を持つことだ。 ローカルウェブサーバー プログラムを実行するには: XAMPP, WAMP どこ MAMP これでも十分です。.
- をインストールする コードエディタ PHPスクリプトを作成・整理するために。.
これらのツールを揃えたら、興味のあるデータを収集・分析する準備が整います。もしあなたが フリーツール 費用をかけずに始めるには、初心者向けのものがいくつかあります。.
PHPを使ったウェブスクレイピングに欠かせないツールとは?
ウェブスクレイピングを効率的に行うには、PHPだけでは不十分です。重要なのは Composer 経由でインストールされたライブラリ これにより、抽出が迅速かつ確実に行えます。知っておくべきツールをご紹介します。.
1. Guzzle:HTTPクライアント
Guzzle ここにある 最も利用されている図書館 HTTPリクエストを送信するために使用します。ウェブページのソースコードを取得するのはこのツールです。インストールするには、ターミナルを開き、プロジェクトのフォルダに移動してから、次のように入力してください:
composer require guzzlehttp/guzzleComposer ライブラリをダウンロードして、コード内で直接使用できるようにします。さらに詳しく知りたい場合は、Guzzleの公式ドキュメントを参照してください。.
以下に、その簡単な例を挙げます。 URLの内容を取り出す :
request('GET', $url);

    // HTTP コードを取得する
    $statusCode = $response->getStatusCode();

    // ページコンテンツを取得する
    $content = $response->getBody()->getContents();

    echo "HTTP コード : " .$statusCode .PHP_EOL;
    echo "ページの内容:" .PHP_EOL;
    echo $content;

} catch (応答なし例外 $e) { { echo "エラー: " .
    echo "エラー: " .$e->getMessage();
}
2. Symfony DomCrawler と Goutte:データ抽出
HTMLを取得したら、それを解析して必要なデータを抽出する必要があります。その際に非常に役立つライブラリが2つあります:
- Symfony DomCrawler : これにより、HTML内を CSSセレクタ また、特定の要素(タイトル、価格、リンクなど)を絞り込むことも可能です。.
- Goutte : これはGuzzleとDomCrawlerのラッパーであり、スクレイピングのプロセスを大幅に簡素化します。.
注意します : パッケージ Goutte 今日は 2022年以降、非推奨となり、アーカイブ済み. 新しいプロジェクトでは、次を優先する Symfony BrowserKit と DomCrawler、 どこ Symfony Panther JavaScriptで読み込まれたコンテンツを処理する必要がある場合。また、以下のアプローチも参考にしてみてください。 Laravel, 、この種のプロジェクトのための体系的な枠組みを提供するものです。.
symfony DomCrawlerを使った例 :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// クラスによる選択
$crawler->filter('.my-class')->each(function ($node) {)
    echo $node->text() .PHP_EOL;
});

// IDによる選択
$crawler->filter('#mon-id')->each(関数 ($node) { )
    echo $node->text() .PHP_EOL;
});

// タグによる選択
$crawler->filter('h1')->each(function ($node) { .
    echo $node->text() .PHP_EOL;
});
「Goutte」を例に挙げると:
request('GET', 'https://exemple.com');

// クラスによる選択
$crawler->filter('.ma-class')->each(function ($node) {)
    echo $node->text() .PHP_EOL;
});

// IDによる選択
$crawler->filter('#mon-id')->each(関数 ($node) { )
    echo $node->text() .PHP_EOL;
});

// タグによる選択
$crawler->filter('p')->each(function ($node) { .
    echo $node->text() .PHP_EOL;
});
3.その他のライブラリやツール
さらに詳しく知りたい場合は、収集するデータ量に応じて、ニーズに合った他のツールも利用できます。.
- PHP-Scraper : HTMLやセレクタの複雑さを処理することで、情報の抽出を容易にするライブラリ。本来のパッケージはGoutteのものではない。.
# Composer を使ったインストール
composer require spekulatius/phpscraper
go('https://example.com');
echo "ページのタイトル: " . $web->title;
- ブライトデータ : 向けの専門プラットフォーム 大規模なデータ収集, 、IPアドレスのブロックを回避するためのプロキシ機能が組み込まれています。.

- スクレイパーAPI : クラウドベースのウェブスクレイピングサービスで、以下のURLからアクセス可能です。 API. スクレイピングしたいURLを指定して簡単なリクエストを送信するだけで、プロキシの設定はサービス側が自動的に処理してくれます。.
PHPで簡単なウェブスクレーパーを作るには?
以下に、その作り方を説明します。 PHPで動作するスクレイパー と Goutte, 、手順を追って:ライブラリのインストール、HTMLの取得、データの抽出、そしてエクスポート。.
ステップ 1: 依存関係のインストール
使用する ダイヤル インストールする Goutte 次のコマンドで:
compose require ファブポット/グート
ステップ2:ページ・コンテンツの取得
やってみて HTTP GETリクエスト ページのHTMLコンテンツを取得するためです。基本的なコードは以下の通りです:
request('GET', $url);

// 必要であれば、生のHTMLを取得する
$html = $crawler->html();
echo substr($html, 0, 500) .'...'; // プレビュー
ステップ3:データの抽出
HTMLを取得したら、 CSSセレクタ (どこ XPath). 以下に例を挙げます。 見出しをスクレイピングする ブログの一ページ。セレクタ 項目 h2 タグを対象とする <h2> ビーコン内部 <記事 :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
このコードの機能:
- セレクター
項目 h2タグ内のタイトルを対象とする<h2>. - その方法
テキスト()各タイトルのテキストを取得します。. - 各銘柄が表に追加されます
1TP65タイトル, その後、以下のように表示されますprint_r().
CSSのセレクタは、以下の目的にも使用されます。 属性を抽出する HTML要素。各見出しがタグ内のリンクである場合 <a>, 属性を取得する href = "/stock/stock_detail.html? 記事のURLを取得するには:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
テーブル 1TP65タイトル これにより、各商品について、以下の両方が含まれることになる。 タイトル そして リンク :
配列
(
    [0] => 配列
        (
            [タイトル] => 記事1タイトル
            [url] => /article1
        )

    [1] => 配列
        (
            [タイトル] => 記事2のタイトル
            [url] => /article2
        )
)
各エントリは、2つのキーを持つ連想配列です: タイトル タイトルについては、そして url ページのURLについては。これにより、分析や保存にすぐ使える、整然とした構造が得られます。.
ステージ4:データの構造化と保存
データが表に抽出されたら $data, 、それらを エクスポート 構造化された形式で。最も有用な2つの形式は、 JSON そしてその シーエスブイ.
the JSON APIやWebアプリケーションへのデータ供給に便利です:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
ファイル エクスポート.json はこのようになる:
[
    {
        "title": "記事1のタイトル"、
        "url": "/article1"
    },
    {
        "title": "記事2のタイトル"、
        "url": "/article2".
    }
]
もし表の方がいいなら シーエスブイ, を使用する fputcsv 各行をファイルに書き出すには:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
ファイル エクスポート.csv はこのようになる:
タイトル,url
記事タイトル1,/article1
記事タイトル2,/article2
データ量が多い場合は、ファイルに書き込むことを忘れないでください だんだん すべてをメモリに読み込むよりも。また、結果を直接 データベース, 、これにより、収集した情報の分析や更新が容易になります。.
PHPでよくあるWebスクレイピングの問題に対処するには?
PHPでのウェブスクレイピングは、必ずしも思い通りに進むとは限りません。サーバーが応答しない、ページの構成に問題がある、IPによるブロックなど、こうした問題はすぐに発生しがちです。ここでは、最も一般的な問題に対処し、データ抽出プログラムの信頼性を高める方法をご紹介します。.
1.エラーの管理
- 接続エラー
場合によっては、リクエストがサーバーにすら届かないこともあります。次のような状況に遭遇することがあります。 「ネットワークがない, 「無効なURL どこ 「サーバーにアクセスできません. その場合は、ブロックを1つ用意してください try/catch スクリプトが突然停止するのを防ぐために。.
具体的な例を挙げると、 Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- HTTPステータスコード
接続が正常であっても、サーバーからエラーが返ってくる場合があります: 404 = ページが見つかりません, 500 = サーバーの内部エラー. 以下のコードを使って、返されたコードをテストできます getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- 解析エラー
パーシングとは、’HTMLの解析 あなたのスクレイパーによって。ページの構成が不適切な場合、, DomCrawler どこ Goutte クラッシュしたり、何も返さなかったりする可能性があります。データを抽出しようとする前には、必ずそのデータが存在することを確認してください。例えば、次のような条件を使って確認します。 count() どこ filter(), その後、パーシングを try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. 制限やスクレイピング防止対策の回避
多くのウェブサイトでは、ウェブスクレイピングを困難にするための対策を講じています。主な障壁と、それらを適切に対処する方法をご紹介します:
- IPアドレスによるブロック : リクエストを送りすぎると、サイト側からIPアドレスがブロックされる可能性があります。その対策としては、 ローテーションプロキシ, 、例えば Bright Data, 、リクエストを複数のアドレスに分散させるためです。.
- リクエストの間隔 : ターゲットサーバーに負荷をかけすぎないように、また検知されないようにするため、通話を時間的に分散させてください。.
- JavaScript コンテンツ デフォルトでは、PHP は JavaScriptを実行する. コンテンツが動的に読み込まれるページをスクレイピングするには、 ヘッドレスブラウザ (ヘッドレスブラウザ)。次のようなツール Puppeteer どこ Selenium 抽出前に、ページを本物のブラウザのように表示します。.
- robots.txt ファイル : スクラッパーを実行する前に、サイトのルートディレクトリにあるこのファイルを確認してください。このファイルには、サイトがロボットに対して何を許可し、何を許可しないかが記載されており、責任ある行動をとるための重要な手順です。.
よくある質問
ウェブスクレイピングは合法か?
The ウェブ・スクレイピングの合法性 収集したデータと、その活用方法によって異なります。フランスでは、 公開データおよび非個人情報 一般的に容認されていますが、自動的に許可されるわけではありません。.
以下の3つの法的制約により、公開ページであってもデータ抽出が違法となる可能性があります:
- the RGPD :個人データが関係する場合、「公開」とは、自由に使用できるという意味ではありません。.
- The 本サイトの利用規約 : アカウントを使ってコンテンツにアクセスする場合、多くの場合、スクレイピングを禁止する利用規約に同意したことになります。.
- the 独自の権利 データベースについて:欧州では、データベースには特別な保護が認められている。.
具体的には、ケースごとに個別に評価します。必ずファイルを確認してください robots.txt プログラムを開始する前に、当サイトの利用規約をご確認ください。.
ウェブスクレイピングとウェブクローリングの違いは?
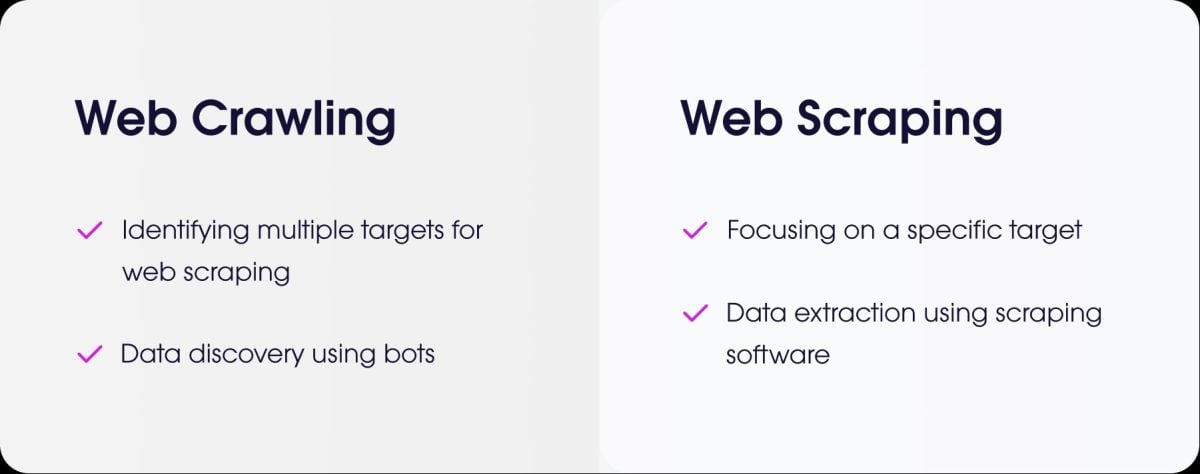
- the ウェブスクレイピング それは 正確なデータを抽出する ウェブサイト上で。.
- the ウェブクローリング それは ページを巡回してインデックスを作成する, 、検索エンジンのボットが行うように。.
認証(ログイン)が必要なサイトをスクレイピングするには?
ログインが必要なサイトをスクレイピングするには、次の手順が必要です。 認証をシミュレートする. PHPでは、最も一般的な解決策はやはり Guzzle. リクエストを通じて認証情報を送信します 役職, 、その後、保護されたページを取得するためにセッションを開いたままにしておきます。.
AJAXでロードされたダイナミックなページを持つサイトのスクレイピングをどのように管理していますか?
PHPでは、クライアントサイドのJavaScriptコードを実行することはできません。読み込まれたコンテンツは AJAX したがって、従来のスクレイパーでは検出できない。.
最初の解決策として、以下を利用する方法があります。 BrowserShot, 、バックグラウンドで実際のブラウザを利用するライブラリ(Headless Chrome) をクリックして、ページを読み込み、JavaScript を実行してください。.
また、次のこともできます PHPを以下のツールと連携させる Node.js、 なので Puppeteer どこ Selenium, レンダリングされたHTMLを生成し、その後、スクリプトからデータを取得するため。.
ウェブスクレイピングのためにPHPに代わるものはありますか?
はい、スクレイピングにはいくつか非常に人気のある言語があります:
- パイソン, 、次のような強力なライブラリを備えた BeautifulSoup と Scrapy.
- Node.js, 、動的なサイトに対して非常に効果的であり、次のようなライブラリを通じて Puppeteer どこ Cheerio.

倫理的かつ責任ある方法でスクレイパーをプログラミングするにはどうすればよいか?
責任あるスクレイピングを行うためには、いくつかの簡単なルールを守る必要があります:
- robots.txt ファイルを確認する 当サイトの利用規約については、こちらをご覧ください。.
- リクエストの頻度を制限する サーバーに過度な負荷がかからないようにするため。.
- 利用規約を遵守してください サイトの
- 個人情報を収集しません 無許可で。
ウェブスクレイピングは、体系的な方法と常識を持って行えば、非常に強力な手法です。ところで、あなたはすでに PHPスクレイパー それとも別の言語で? コメント欄であなたの体験談を教えてください!








 JA