PHP ne sert pas qu’à créer des sites dynamiques. Avec des bibliothèques comme Guzzle et Goutte, tu peux construire un scraper fonctionnel et extraire automatiquement des données depuis n’importe quelle page web.
Les entreprises l’utilisent pour surveiller les prix, analyser les réseaux sociaux ou collecter des informations sur leurs concurrents.
Prérequis pour faire du scraping avec PHP
Le web scraping consiste à extraire automatiquement des données depuis des pages web. Un programme parcourt le HTML d’un site, cible les informations utiles, puis les enregistre dans un fichier ou une base de données. En PHP, quelques bibliothèques suffisent pour construire un scraper fonctionnel, mais avant de te lancer, vérifie que tu remplis ces conditions :
- Avoir des bases en programmation PHP, car tu vas écrire du code pour piloter l’extraction.
- Maîtriser quelques notions de HTML et CSS, pour cibler précisément les éléments à extraire sur la page.
- Savoir utiliser Composer, l’outil qui gère les dépendances PHP et installe les bibliothèques comme Guzzle, Symfony DomCrawler ou Goutte.
- Disposer d’un serveur web local pour exécuter ton programme : XAMPP, WAMP ou MAMP font très bien l’affaire.
- Installer un éditeur de code pour écrire et organiser tes scripts PHP.
Une fois ces outils réunis, tu es prêt à collecter et analyser les données qui t’intéressent. Si tu cherches des outils gratuits pour démarrer sans dépenser, il en existe plusieurs adaptés aux débutants.
Quels sont les outils indispensables pour le web scraping avec PHP ?
PHP seul ne suffit pas pour faire du web scraping efficacement. Ce sont les bibliothèques installées via Composer qui rendent l’extraction rapide et fiable. Voici les outils à connaître.
1. Guzzle : le client HTTP
Guzzle est la bibliothèque la plus utilisée pour envoyer des requêtes HTTP. C’est elle qui récupère le code source d’une page web. Pour l’installer, ouvre ton terminal, place-toi dans le dossier de ton projet, puis tape :
composer require guzzlehttp/guzzleComposer télécharge la bibliothèque et la rend utilisable directement dans ton code. Tu peux consulter la documentation officielle de Guzzle pour aller plus loin.
Voici un exemple simple pour récupérer le contenu d’une URL :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;

$client = new Client();

// L'URL cible
$url = 'https://exemple.com';

try {
    // On envoie la requête GET
    $response = $client->request('GET', $url);

    // On récupère le code HTTP
    $statusCode = $response->getStatusCode();

    // On récupère le contenu de la page
    $content = $response->getBody()->getContents();

    echo "Code HTTP : " . $statusCode . PHP_EOL;
    echo "Contenu de la page :" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Erreur : " . $e->getMessage();
}
2. Symfony DomCrawler et Goutte : l’extraction des données
Une fois le HTML récupéré, il faut l’analyser pour en extraire les données utiles. Deux bibliothèques sont très pratiques pour ça :
- Symfony DomCrawler : elle permet de naviguer dans le HTML avec des sélecteurs CSS et de cibler des éléments précis (titre, prix, lien…).
- Goutte : c’est un wrapper de Guzzle et DomCrawler qui simplifie considérablement le processus de scraping.
À noter : le package Goutte est aujourd’hui déprécié et archivé depuis 2022. Pour un nouveau projet, préfère Symfony BrowserKit avec DomCrawler, ou Symfony Panther si tu dois gérer du contenu chargé en JavaScript. Tu peux aussi jeter un oeil à l’approche avec Laravel, qui offre un cadre structuré pour ce type de projet.
Exemple avec Symfony DomCrawler :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use Symfony\Component\DomCrawler\Crawler;

$client = new Client();
$response = $client->request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// Sélection par classe
$crawler->filter('.ma-classe')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Sélection par ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Sélection par balise
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Exemple avec Goutte :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$crawler = $client->request('GET', 'https://exemple.com');

// Sélection par classe
$crawler->filter('.ma-classe')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Sélection par ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Sélection par balise
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Autres bibliothèques et outils
Pour aller plus loin, d’autres outils s’adaptent à tes besoins selon le volume de données à collecter.
- PHP-Scraper : une bibliothèque qui facilite l’extraction d’informations en gérant les complexités du HTML et des sélecteurs. Son vrai package n’est pas celui de Goutte.
# Installation avec Composer
composer require spekulatius/phpscraper
<?php
require 'vendor/autoload.php';
use Spekulatius\PHPScraper\PHPScraper;
$web = new PHPScraper;
// Exemple : récupérer le titre d'une page
$web->go('https://example.com');
echo "Titre de la page : " . $web->title;
- Bright Data : une plateforme professionnelle pour la collecte de données à grande échelle, avec des proxys intégrés pour éviter le blocage d’IP.

- ScraperAPI : un service de scraping web basé sur le cloud, accessible via une API. Tu envoies une simple requête en indiquant l’URL à scraper, et le service gère lui-même les proxys.
Comment créer un web scraper simple en PHP ?
Voici comment construire un scraper fonctionnel en PHP avec Goutte, étape par étape : installation d’une bibliothèque, récupération du HTML, extraction des données, puis export.
Étape 1 : Installation des dépendances
Utilise Composer pour installer Goutte avec cette commande :
composer require fabpot/goutte
Étape 2 : Récupérer le contenu d’une page
Fais une requête HTTP GET pour récupérer le contenu HTML de la page. Voici le code de base :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();

// URL cible (ex.: page de blog)
$url = 'https://exemple.com/blog';

// Requête GET
$crawler = $client->request('GET', $url);

// Récupérer le HTML brut si besoin
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // aperçu
Étape 3 : Extraire les données
Une fois le HTML récupéré, tu cibles des éléments précis grâce à un sélecteur CSS (ou XPath). Voici un exemple pour scraper les titres d’une page de blog. Le sélecteur 'article h2' cible les balises <h2> à l’intérieur des balises <article> :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Ce que fait ce code :
- Le sélecteur
'article h2'cible les titres dans les balises<h2>. - La méthode
text()récupère le texte de chaque titre. - Chaque titre est ajouté au tableau
$titres, puis affiché avecprint_r().
Les sélecteurs CSS servent aussi à extraire des attributs d’éléments HTML. Si chaque titre est un lien dans une balise <a>, tu récupères l’attribut href pour obtenir l’URL de l’article :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
Le tableau $titres contient alors, pour chaque article, à la fois le titre et son lien :
Array
(
    [0] => Array
        (
            [title] => Titre de l'article 1
            [url] => /article1
        )

    [1] => Array
        (
            [title] => Titre de l'article 2
            [url] => /article2
        )
)
Chaque entrée est un tableau associatif avec deux clés : title pour le titre et url pour l’adresse de la page. Tu obtiens une structure propre, prête à être analysée ou stockée.
Étape 4 : Structurer et stocker les données
Une fois les données extraites dans le tableau $data, tu peux les exporter dans un format structuré. Les deux formats les plus utiles sont le JSON et le CSV.
Le JSON est pratique pour alimenter une API ou une application web :
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
Le fichier export.json ressemblera à ceci :
[
    {
        "title": "Titre de l'article 1",
        "url": "/article1"
    },
    {
        "title": "Titre de l'article 2",
        "url": "/article2"
    }
]
Si tu préfères un tableau CSV, utilise fputcsv pour écrire chaque ligne dans un fichier :
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
Le fichier export.csv ressemblera à ceci :
title,url
Titre de l'article 1,/article1
Titre de l'article 2,/article2
Pour de gros volumes de données, pense à écrire dans le fichier au fur et à mesure plutôt que de tout charger en mémoire. Tu peux aussi enregistrer directement le résultat dans une base de données, ce qui facilite ensuite l’analyse et la mise à jour des informations collectées.
Comment gérer les problèmes courants du web scraping en PHP ?
Le web scraping en PHP ne se passe pas toujours comme prévu. Un serveur qui ne répond pas, une page mal formée, un blocage par IP : ces problèmes arrivent vite. Voici comment gérer les plus courants pour fiabiliser ton programme d’extraction.
1. Gérer les erreurs
- Erreurs de connexion
Parfois, la requête n’arrive même pas jusqu’au serveur. Tu peux tomber sur « Pas de réseau », « URL invalide » ou « Serveur inaccessible ». Dans ce cas, prévois un bloc try/catch pour éviter que ton script s’arrête brutalement.
Voici un exemple concret avec Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Codes de statut HTTP
Même quand la connexion marche, le serveur peut répondre avec une erreur : 404 = page introuvable, 500 = erreur interne du serveur. Tu peux tester le code renvoyé avec getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Erreurs de parsing
Le parsing, c’est l’analyse du HTML par ton scraper. Si la page est mal formée, DomCrawler ou Goutte peuvent planter ou ne rien renvoyer. Vérifie toujours que le contenu existe avant d’essayer de l’extraire, avec des conditions comme count() ou filter(), puis entoure le parsing d’un try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Contourner les limitations et les protections anti-scraping
Beaucoup de sites web mettent en place des protections pour compliquer le web scraping. Voici les principaux obstacles et comment les gérer proprement :
- Blocage par IP : quand tu envoies trop de requêtes, le site peut bannir ton adresse IP. La solution consiste à passer par des proxys rotatifs, comme ceux de Bright Data, pour répartir tes requêtes sur plusieurs adresses.
- Espacement des requêtes : espace tes appels dans le temps pour rester sous le radar et ne pas surcharger le serveur cible.
- Contenu en JavaScript : par défaut, PHP ne peut pas exécuter le JavaScript. Pour scraper une page dont le contenu est chargé dynamiquement, tu as besoin d’un navigateur sans tête (headless browser). Des outils comme Puppeteer ou Selenium rendent la page comme un vrai navigateur avant l’extraction.
- Fichier robots.txt : avant de lancer ton scraper, vérifie ce fichier à la racine du site. Il indique ce que le site autorise ou non aux robots, une étape clé pour agir de manière responsable.
FAQ
Le web scraping est-il légal ?
La légalité du web scraping dépend des données collectées et de la manière dont tu les exploites. En France, scraper des données publiques et non personnelles est généralement toléré, mais ce n’est pas un feu vert automatique.
Trois limites juridiques peuvent rendre l’extraction illégale, même sur des pages publiques :
- Le RGPD : dès que des données personnelles sont concernées, « public » ne veut pas dire libre d’usage.
- Les CGU du site : si tu utilises un compte pour accéder au contenu, tu as accepté des conditions qui interdisent souvent le scraping.
- Le droit sui generis sur les bases de données : en Europe, une base de données bénéficie d’une protection spécifique.
Concrètement, chaque cas s’évalue individuellement. Consulte toujours le fichier robots.txt et les conditions d’utilisation du site avant de lancer ton programme.
Quelle est la différence entre le web scraping et le web crawling ?
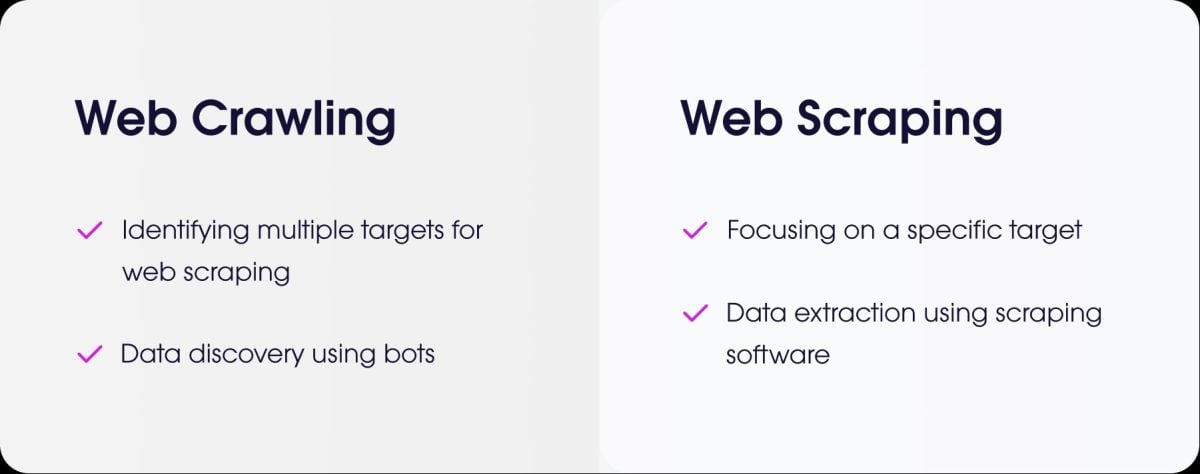
- Le web scraping consiste à extraire des données précises sur un site web.
- Le web crawling consiste à parcourir des pages pour les indexer, comme le fait un robot de moteur de recherche.
Comment scraper un site qui nécessite une authentification (login) ?
Pour scraper un site qui exige une connexion, il faut simuler l’authentification. Avec PHP, la solution la plus courante reste Guzzle. Tu envoies tes identifiants via une requête POST, puis tu gardes la session ouverte pour récupérer les pages protégées.
Comment gérer le scraping de sites avec des pages dynamiques chargées en AJAX ?
PHP ne peut pas exécuter le code JavaScript côté client. Le contenu chargé en AJAX échappe donc à un scraper classique.
Une première solution consiste à utiliser BrowserShot, une bibliothèque qui s’appuie sur un navigateur réel en arrière-plan (Headless Chrome) pour charger la page et exécuter le JavaScript.
Tu peux aussi coupler PHP avec des outils basés sur Node.js, comme Puppeteer ou Selenium, pour générer le HTML rendu et récupérer ensuite les données depuis ton script.
Existe-t-il des alternatives à PHP pour le web scraping ?
Oui, plusieurs langages sont très populaires pour le scraping :
- Python, avec ses bibliothèques puissantes comme BeautifulSoup et Scrapy.
- Node.js, très efficace pour les sites dynamiques, via des bibliothèques comme Puppeteer ou Cheerio.

Comment programmer un scraper de manière éthique et responsable ?
Pour scraper de façon responsable, quelques règles simples s’imposent :
- Vérifie le fichier robots.txt du site pour connaître les règles d’accès.
- Limite la fréquence de tes requêtes pour ne pas surcharger le serveur.
- Respecte les conditions d’utilisation du site.
- Ne collecte pas de données personnelles sensibles sans autorisation.
Le web scraping est une pratique puissante, à condition de l’utiliser avec méthode et bon sens. Et toi, tu as déjà créé un scraper en PHP ou avec un autre langage ? Partage-nous ton expérience en commentaire !







 FR