PHP 不仅用于创建动态网站。借助诸如 Guzzle 和 Goutte, ,你可以构建一个 功能性爬虫 并能从任何网页自动提取数据。.
企业利用它来监控价格、分析社交媒体或收集竞争对手的信息。.
使用 PHP 进行刮擦的先决条件
这 网络搜刮 是指从网页中自动提取数据。一个程序会遍历 HTML 从某个网站中筛选出有用的信息,然后将其保存到文件或数据库中。在 PHP, 只需几个库就能构建一个可运行的爬虫,但在开始之前,请确认你是否满足以下条件:
- 拥有 PHP编程基础, ,因为你要编写代码来控制数据提取。.
- 掌握一些 HTML和CSS的基础知识, ,以便精确定位页面上需要提取的内容。.
- 掌握使用方法 拨号, ,这是一个用于管理 PHP 依赖关系并安装库的工具,例如 Guzzle, Symfony DomCrawler 或 Goutte.
- 拥有 本地网络服务器 要运行你的程序: XAMPP, WAMP 在哪里 MAMP 非常合适。.
- 安装一个 代码编辑器 用于编写和组织你的PHP脚本。.
准备好这些工具后,你就可以开始收集和分析你感兴趣的数据了。如果你正在寻找 免费工具 如果想不花钱就开始,有几种适合初学者的选择。.
哪些工具是使用 PHP 进行网络搜索的必备工具?
仅靠PHP还不足以高效地进行网页抓取。关键在于 通过Composer安装的库 这些工具能让数据提取既快速又可靠。以下是您需要了解的工具。.
1. Guzzle:HTTP 客户端
Guzzle 在这儿 使用率最高的图书馆 用于发送 HTTP 请求。它负责获取网页的源代码。要安装它,请打开终端,进入你的项目目录,然后输入:
composer require guzzlehttp/guzzleComposer 下载该库,即可在你的代码中直接使用。如需进一步了解,可查阅 Guzzle 的官方文档。.
下面是一个简单的示例,用于 检索 URL 的内容 :
request('GET', $url);

    // 读取 HTTP 代码
    $statusCode = $response->getStatusCode();

    // 读取页面内容
    $content = $response->getBody()->getContents();

    echo "HTTP Code : " .$statusCode .PHP_EOL;
    echo "页面内容:" .PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Error: " .$e->getMessage();
}
2. Symfony DomCrawler 与 Goutte:数据提取
获取 HTML 代码后,需要对其进行解析以提取有用的数据。有两个库在这方面非常实用:
- Symfony DomCrawler : 它允许通过 CSS 选择器 并锁定具体内容(标题、价格、链接等)。.
- Goutte :这是一个基于 Guzzle 和 DomCrawler 的封装库,能大幅简化爬取过程。.
要注意 : 该软件包 Goutte 今天是 自2022年起已弃用并归档. 对于新项目,建议 Symfony BrowserKit 和 DomCrawler, 在哪里 Symfony Panther 如果你需要处理通过 JavaScript 加载的内容。你也可以看看以下方法: Laravel, ,它为这类项目提供了一个结构化的框架。.
使用 Symfony DomCrawler 的示例:
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// 按类选择
$crawler->filter('.my-class')->each(function ($node) {
    echo $node->text() .PHP_EOL;
});

// 按 ID 选择
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() .PHP_EOL;
});

// 按标签选择
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() .PHP_EOL;
});
以Goutte为例:
request('GET', 'https://exemple.com');

// 按类选择
$crawler->filter('.ma-class')->each(function ($node) {
    echo $node->text() .PHP_EOL;
});

// 按 ID 选择
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() .PHP_EOL;
});

// 按标签选择
$crawler->filter('p')->each(function ($node) {
    echo $node->text() .PHP_EOL;
});
3.其他图书馆和工具
若需进一步深入,还有其他工具可根据需要收集的数据量来满足你的需求。.
- PHP-Scraper :一个能够通过处理HTML和选择器的复杂性来简化信息提取的库。其真正的包并非Goutte。.
# 使用 Composer 安装
composer require spekulatius/phpscraper
go('https://example.com');
echo "页面标题: " . $web->title;
- 亮数据 :一个面向……的专业平台 大规模数据收集, ,并内置代理服务器以避免IP被封禁。.

- ScraperAPI :一项基于云的网页抓取服务,可通过 应用程序接口. 你只需发送一个简单的请求,注明要抓取的URL,该服务会自动处理代理设置。.
如何用 PHP 创建一个简单的网络搜索器?
以下是构建一个 PHP 功能性网页抓取工具 和 Goutte, ,分步操作:安装库、获取HTML、提取数据,然后导出。.
步骤 1:安装依赖项
使用 拨号 安装 Goutte 使用以下命令:
compose require fabpot/goutte
步骤 2:检索页面内容
做个 HTTP GET 请求 以获取页面的 HTML 内容。以下是基础代码:
request('GET', $url);

// 如果需要,读取原始 HTML
$html = $crawler->html();
echo substr($html, 0, 500) .'...'; // 预览
步骤 3:提取数据
获取 HTML 后,你可以通过一个 CSS 选择器 (在哪里 XPath). 以下是一个示例,用于 抓取标题 博客页面。选择器 项目 h2 针对标签 <h2> 烽火台内 <文章 :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
该代码的作用是:
- 选择器
项目 h2针对标签中的标题<h2>. - 方法
text()提取每个标题的文本。. - 每个标题都会被添加到表格中
$itles, ,然后以以下格式显示:print_r().
CSS选择器还用于 提取属性 HTML元素。如果每个标题都是一个位于 <a>, 获取该属性 href 要获取文章的URL:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
表格 $itles 因此,对于每项商品,其中既包含 标题 及其 关联 :
数组
(
    [0] => Array
        (
            [title] => 文章 1 标题
            [url] => /article1
        )

    [1] => Array
        (
            [title] => 文章 2 标题
            [url] => /article2
        )
)
每个条目都是一个包含两个键的关联数组: 标题 关于标题以及 网址 作为页面的地址。这样你就能得到一个整洁的结构,可直接用于分析或存储。.
第 4 阶段:构建和存储数据
将数据提取到表格中后 $data, ,你可以把它们 导出 以结构化的格式呈现。最有用的两种格式是 JSON 和 CSV.
这 JSON 适用于为API或Web应用程序提供数据:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
文件 export.json 会是这样
[
    {
        "title":"第 1 条标题"、
        "url":"/article1"
    },
    {
        "title": "Article 2 title"、
        "url": "/article2" }.
    }
]
如果你更喜欢看表格的话 CSV, 使用 fputcsv 将每一行写入文件:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
文件 export.csv 会是这样
标题,url
文章标题 1,/article1
文章标题 2,/article2
对于大量数据,请记得写入文件中 逐渐 而不是将所有内容都加载到内存中。你也可以将结果直接保存到一个 资料库, ,这进而便于对收集到的信息进行分析和更新。.
如何处理 PHP 中常见的网络搜索问题?
使用PHP进行网页抓取时,情况并不总是如预期般顺利。服务器无响应、页面结构错误、IP封锁:这些问题往往会突然出现。以下是处理这些常见问题的方法,以提高你的抓取程序的可靠性。.
1.管理错误
- 连接错误
有时,请求甚至无法到达服务器。你可能会遇到 "无网络, "无效 URL 在哪里 "服务器无法访问. 在这种情况下,请预留一个区块 try/catch 以防止你的脚本突然终止。.
下面是一个具体的示例,其中使用了 Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- HTTP 状态代码
即使连接正常,服务器仍可能返回错误: 404 = 找不到页面, 500 = 服务器内部错误. 你可以使用以下代码测试返回的结果: getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- 解析错误
语法分析是指……’HTML分析 通过你的网页抓取工具。如果页面格式有问题,, DomCrawler 在哪里 Goutte 可能会导致程序崩溃或不返回任何结果。在尝试提取内容之前,请务必先检查该内容是否存在,可使用如下条件: count() 在哪里 filter(), ,然后用一个 try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. 绕过限制和反爬虫保护措施
许多网站都设置了防护措施,以增加网络爬取的难度。以下是主要障碍以及如何妥善应对:
- 按IP地址屏蔽 :当你发送过多请求时,网站可能会封禁你的IP地址。解决方法是通过 轮换代理, ,例如那些来自 Bright Data, ,以便将你的请求分散到多个地址上。.
- 请求间隔 : 将调用分散在不同时间段内,以避免引起注意,并防止目标服务器过载。.
- JavaScript 内容 默认情况下,PHP 无法 运行 JavaScript. 要抓取内容动态加载的页面,你需要一个 无头浏览器 (无界面浏览器)。诸如 Puppeteer 在哪里 Selenium 在提取之前,将页面渲染成真正的浏览器效果。.
- robots.txt 文件 : 在运行你的爬虫之前,请检查网站根目录下的这个文件。它规定了网站允许或禁止爬虫执行哪些操作,这是以负责任的方式进行操作的关键步骤。.
常见问题
网络搜索合法吗?
这 网络搜索的合法性 这取决于收集到的数据以及你如何利用这些数据。在法国,抓取 公开数据和非个人数据 通常会被容忍,但这并不意味着自动获得批准。.
有三种法律限制可能导致数据抓取行为被视为非法,即使是在公开网页上也是如此:
- 这 RGPD :一旦涉及个人数据,«公开»并不意味着可以随意使用。.
- 这 网站使用条款 : 如果你使用账户访问内容,就意味着你已同意相关条款,而这些条款通常禁止数据抓取。.
- 这 特殊权利 关于数据库:在欧洲,数据库享有特殊的保护。.
具体来说,每个案例都要单独评估。请务必查阅该文件 robots.txt 并在开始你的课程之前,请仔细阅读本网站的使用条款。.
网络搜刮和网络爬行有什么区别?
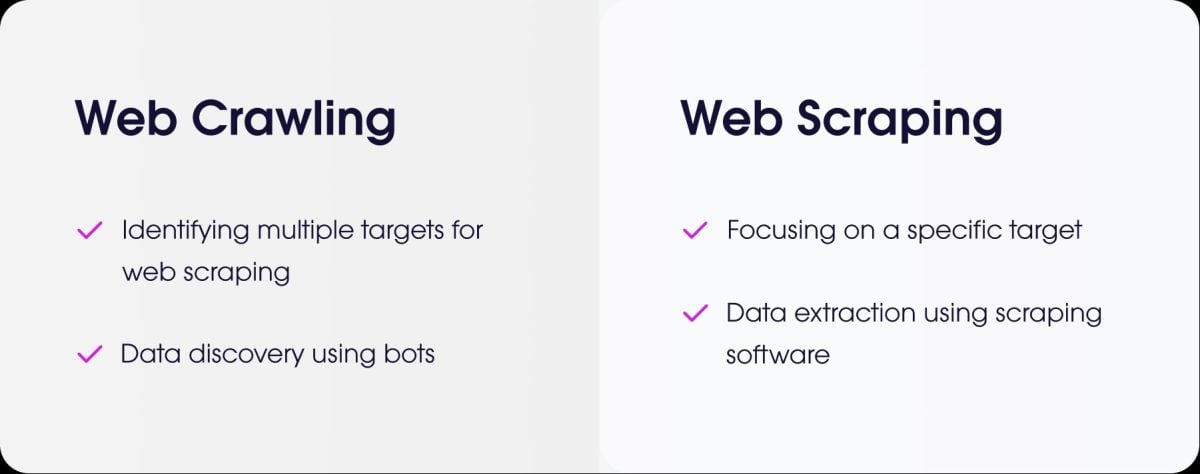
- 这 网络搜刮 就是 提取准确的数据 在某个网站上。.
- 这 网络抓取 就是 遍历页面以对其进行索引, ,就像搜索引擎机器人那样。.
如何抓取需要验证(登录)的网站?
要抓取一个需要登录的网站,必须 模拟身份验证. 在 PHP 中,最常见的解决方案仍是 Guzzle. 你通过一个请求发送你的凭据 邮政, ,然后保持会话处于打开状态,以便获取受保护的页面。.
如何管理对使用 AJAX 加载动态页面的网站的搜索?
PHP 无法执行客户端的 JavaScript 代码。加载到 AJAX 因此,它无法被传统的数据抓取工具抓取。.
一种初步的解决方案是使用 BrowserShot, ,一个在后台基于真实浏览器的库(Headless Chrome) 以加载页面并执行 JavaScript。.
你也可以 将 PHP 与基于 Node.js, 作为 Puppeteer 在哪里 Selenium, ,用于生成渲染后的HTML,然后通过你的脚本获取数据。.
有什么方法可以替代 PHP 进行网络搜索吗?
是的,有几种编程语言在网页抓取领域非常流行:
- Python, ,拥有诸如 BeautifulSoup 和 Scrapy.
- Node.js, ,对于动态网站非常有效,可通过以下库实现: Puppeteer 在哪里 Cheerio.

如何以符合道德且负责任的方式编写爬虫程序?
为了负责任地进行数据抓取,必须遵守以下几条简单规则:
- 检查 robots.txt 文件 请访问该网站了解访问规则。.
- 限制请求的频率 以免给服务器造成过载。.
- 请遵守使用条款 的。
- 不收集个人数据 未经授权。
网络爬虫是一种强大的技术,前提是必须有条不紊且明智地使用它。那么你呢,你已经创建过一个 PHP 中的刮板 还是用其他语言?请在评论中分享你的经验!








 ZH