PHP non serve solo a creare siti dinamici. Con librerie come Guzzle e Goutte, puoi costruire un scraper funzionale ed estrarre automaticamente i dati da qualsiasi pagina web.
Le aziende lo utilizzano per monitorare i prezzi, analizzare i social media o raccogliere informazioni sui propri concorrenti.
Prerequisiti per lo scraping con PHP
il scraping del web consiste nell’estrarre automaticamente i dati dalle pagine web. Un programma scansiona il HTML di un sito, individua le informazioni utili e le salva in un file o in un database. In PHP, bastano poche librerie per creare uno scraper funzionante, ma prima di iniziare, verifica di soddisfare questi requisiti:
- Avere Nozioni di base sulla programmazione in PHP, perché dovrai scrivere del codice per gestire l'estrazione.
- Padroneggiare alcune nozioni di HTML e CSS, per individuare con precisione gli elementi da estrarre dalla pagina.
- Saper usare Quadrante, lo strumento che gestisce le dipendenze PHP e installa le librerie come Guzzle, Symfony DomCrawler oppure Goutte.
- Avere un server web locale Per eseguire il tuo programma: XAMPP, WAMP Dove MAMP vanno benissimo.
- Installare un editor di codice per scrivere e organizzare i tuoi script PHP.
Una volta raccolti questi strumenti, sei pronto a raccogliere e analizzare i dati che ti interessano. Se stai cercando dei strumenti gratuiti Per iniziare senza spendere, ce ne sono diversi adatti ai principianti.
Quali strumenti sono essenziali per il web scraping con PHP?
Il PHP da solo non basta per eseguire efficacemente il web scraping. Sono i librerie installate tramite Composer che rendono l'estrazione veloce e affidabile. Ecco gli strumenti da conoscere.
1. Guzzle: il client HTTP
Guzzle è qui la biblioteca più frequentata per inviare richieste HTTP. È proprio questa che recupera il codice sorgente di una pagina web. Per installarla, apri il terminale, vai nella cartella del tuo progetto, quindi digita:
composer richiede guzzlehttp/guzzleComposer Scarica la libreria e rendila immediatamente utilizzabile nel tuo codice. Per approfondire l'argomento, puoi consultare la documentazione ufficiale di Guzzle.
Ecco un semplice esempio per recuperare il contenuto di un URL :
request('GET', $url);

    // Recuperare il codice HTTP
    $statusCode = $response->getStatusCode();

    // Recuperare il contenuto della pagina
    $content = $response->getBody()->getContents();

    echo "Codice HTTP: " . $statusCode . PHP_EOL;
    echo "Contenuto della pagina:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Errore: " . $e->getMessage();
}
2. Symfony DomCrawler e Goutte: l’estrazione dei dati
Una volta recuperato il codice HTML, è necessario analizzarlo per estrarne i dati utili. A tal fine, due librerie risultano particolarmente utili:
- Symfony DomCrawler : permette di navigare nel codice HTML con dei Selettori CSS e di individuare elementi specifici (titolo, prezzo, link…).
- Goutte : si tratta di un wrapper di Guzzle e DomCrawler che semplifica notevolmente il processo di scraping.
Da notare : il pacchetto Goutte è oggi messo fuori uso e archiviato dal 2022. Per un nuovo progetto, preferisci Symfony BrowserKit insieme a DomCrawler, Dove Symfony Panther se devi gestire contenuti caricati tramite JavaScript. Puoi anche dare un'occhiata all'approccio con Laravel, che offre un quadro strutturato per questo tipo di progetto.
Esempio con Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = nuovo Crawler($html);

// Selezione per classe
$crawler->filtro('.my-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selezione per ID
$crawler->filtro('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selezione per tag
$crawler->filtro('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Esempio con Goutte:
request('GET', 'https://exemple.com');

// Selezione per classe
$crawler->filtro('.ma-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selezione per ID
$crawler->filtro('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selezione per tag
$crawler->filtro('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Altre librerie e strumenti
Per approfondire l'argomento, esistono altri strumenti che si adattano alle tue esigenze in base al volume dei dati da raccogliere.
- PHP-Scraper : una libreria che semplifica l’estrazione di informazioni gestendo le complessità dell’HTML e dei selettori. Il suo vero pacchetto non è quello di Goutte.
# Installazione con Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Titolo della pagina: " . $web->title;
- Dati luminosi : una piattaforma professionale per la raccolta di dati su larga scala, con proxy integrati per evitare il blocco degli indirizzi IP.

- ScraperAPI : un servizio di web scraping basato su cloud, accessibile tramite un API. Basta inviare una semplice richiesta indicando l'URL da scrappare e il servizio gestisce autonomamente i proxy.
Come si crea un semplice web scraper in PHP?
Ecco come costruire un scraper funzionale in PHP insieme a Goutte, passo dopo passo: installazione di una libreria, recupero dell’HTML, estrazione dei dati e infine esportazione.
Passo 1: Installazione delle dipendenze
Utilizza Quadrante per installare Goutte con questo comando:
comporre richiedere fabpot/goutte
Passo 2: Recupero del contenuto della pagina
Fai una Richiesta HTTP GET per recuperare il contenuto HTML della pagina. Ecco il codice di base:
request('GET', $url);

// Recuperare l'HTML grezzo, se richiesto
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // anteprima
Fase 3: Estrazione dei dati
Una volta recuperato il codice HTML, puoi selezionare elementi specifici grazie a un Selettore CSS (Dove XPath). Ecco un esempio per estrarre i titoli di una pagina di blog. Il selettore voce h2 si concentra sui tag <h2> all'interno dei fari <article> :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Cosa fa questo codice:
- Il selettore
voce h2mette in evidenza i titoli nei tag<h2>. - Il metodo
testo()estrae il testo di ogni titolo. - Ogni titolo viene aggiunto alla tabella
$itoli, e poi visualizzato conprint_r().
I selettori CSS servono anche a estrarre gli attributi di elementi HTML. Se ogni titolo è un link all’interno di un tag <a>, recuperi l'attributo href per ottenere l'URL dell'articolo:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
Il tavolo $itoli contiene quindi, per ogni articolo, sia il titolo e il suo collegamento :
Array
(
    [0] => Array
        (
            [title] => Titolo dell'articolo 1
            [url] => /articolo1
        )

    [1] => Array
        (
            [title] => Titolo dell'articolo 2
            [url] => /articolo2
        )
)
Ogni voce è un array associativo con due chiavi: titolo per il titolo e url per l'indirizzo della pagina. Si ottiene una struttura pulita, pronta per essere analizzata o archiviata.
Fase 4: strutturazione e archiviazione dei dati
Una volta estratti i dati nella tabella $data, puoi esportare in un formato strutturato. I due formati più utili sono il JSON e il CSV.
il JSON è utile per alimentare un’API o un’applicazione web:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
Il file esportazione.json avrà il seguente aspetto:
[
    {
        "title": "Titolo dell'articolo 1",
        "url: "/articolo1".
    },
    {
        "title": "Titolo dell'articolo 2",
        "url": "/articolo2".
    }
]
Se preferisci una tabella CSV, utilizza fputcsv per scrivere ogni riga in un file:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
Il file esportazione.csv avrà il seguente aspetto:
titolo,url
Titolo articolo 1,/articolo1
Titolo articolo 2,/articolo2
In caso di grandi volumi di dati, ricordati di scrivere nel file progressivamente anziché caricare tutto in memoria. Puoi anche salvare direttamente il risultato in un database, il che facilita poi l'analisi e l'aggiornamento delle informazioni raccolte.
Come si possono risolvere i problemi più comuni di web scraping in PHP?
Il web scraping in PHP non sempre va come previsto. Un server che non risponde, una pagina mal formata, un blocco per IP: questi problemi possono presentarsi in un attimo. Ecco come gestire quelli più comuni per rendere più affidabile il tuo programma di estrazione.
1. Gestione degli errori
- Errori di connessione
A volte la richiesta non arriva nemmeno al server. Potresti imbatterti in "No rete, "URL non valido Dove "Server inaccessibile. In questo caso, inserisci un blocco try/catch per evitare che il tuo script si interrompa bruscamente.
Ecco un esempio concreto con Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Codici di stato HTTP
Anche quando la connessione funziona, il server può restituire un errore: 404 = pagina non trovata, 500 = errore interno del server. Puoi provare il codice restituito con getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Errori di parsing
Il parsing è l’analisi dell'HTML tramite il tuo scraper. Se la pagina è mal strutturata, DomCrawler Dove Goutte possono bloccarsi o non restituire alcun risultato. Verifica sempre che il contenuto esista prima di provare a estrarlo, con condizioni come count() Dove filter(), quindi racchiude il parsing tra un try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Aggirare le limitazioni e le protezioni anti-scraping
Molti siti web adottano misure di protezione per rendere più difficile il web scraping. Ecco i principali ostacoli e come gestirli correttamente:
- Blocco in base all'IP : quando invii troppe richieste, il sito potrebbe bloccare il tuo indirizzo IP. La soluzione consiste nel passare attraverso dei proxy a rotazione, come quelli di Bright Data, per distribuire le tue richieste su più indirizzi.
- Intervallo tra le richieste : distribuisci le tue chiamate nel tempo per passare inosservato e non sovraccaricare il server di destinazione.
- Contenuto in JavaScript per impostazione predefinita, PHP non può eseguire JavaScript. Per eseguire lo scraping di una pagina il cui contenuto viene caricato dinamicamente, è necessario un navigatore senza testa (browser senza interfaccia grafica). Strumenti come Puppeteer Dove Selenium riproducono la pagina come un vero browser prima dell'estrazione.
- File robots.txt : prima di avviare il tuo scraper, controlla questo file nella directory principale del sito. Indica ciò che il sito consente o meno ai robot: un passaggio fondamentale per agire in modo responsabile.
Domande frequenti
Il web scraping è legale?
Il legalità del web scraping dipende dai dati raccolti e dal modo in cui li utilizzi. In Francia, lo scraping di dati pubblici e non personali è generalmente tollerato, ma non significa che si abbia automaticamente il via libera.
Tre limiti giuridici possono rendere illegale l’estrazione, anche da pagine pubbliche:
- il RGPD : quando sono coinvolti dati personali, il termine «pubblico» non significa che l’uso sia libero.
- Il Condizioni generali d'uso del sito : se utilizzi un account per accedere ai contenuti, hai accettato delle condizioni che spesso vietano lo scraping.
- il diritto sui generis Per quanto riguarda le banche dati: in Europa, una banca dati gode di una protezione specifica.
In pratica, ogni caso viene valutato singolarmente. Consulta sempre il file robots.txt e le condizioni d'uso del sito prima di avviare il tuo programma.
Qual è la differenza tra web scraping e web crawling?
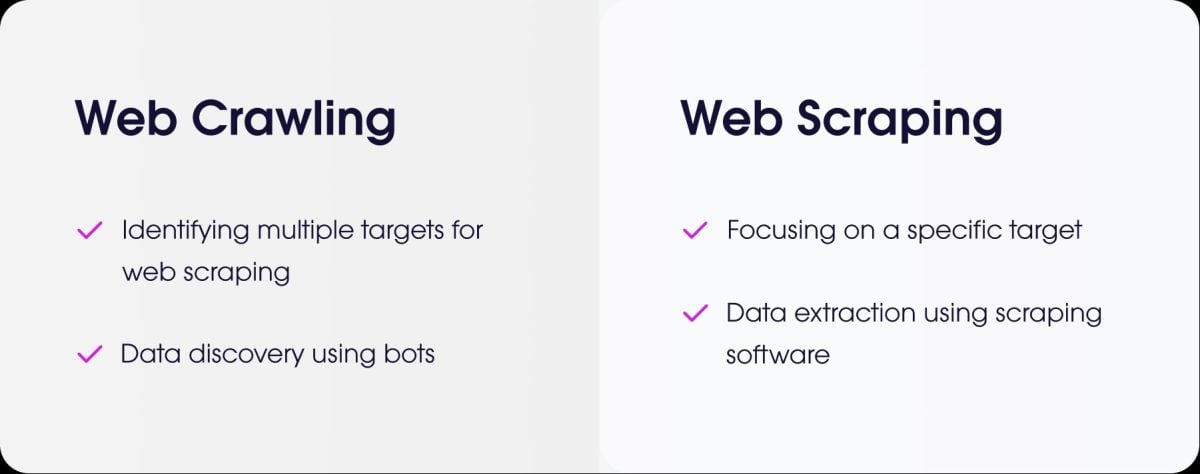
- il scraping del web è quello di estrarre dati precisi su un sito web.
- il crawling del web è quello di sfogliare le pagine per indicizzarle, proprio come fa un robot dei motori di ricerca.
Come si esegue lo scraping di un sito che richiede l'autenticazione (login)?
Per eseguire lo scraping di un sito che richiede l'accesso, è necessario simulare l'autenticazione. Con PHP, la soluzione più comune rimane Guzzle. Invii le tue credenziali tramite una richiesta INVIARE, poi tieni aperta la sessione per recuperare le pagine protette.
Come si gestisce lo scraping di siti con pagine dinamiche caricate in AJAX?
PHP non è in grado di eseguire il codice JavaScript lato client. Il contenuto caricato in AJAX sfugge quindi a uno scraper classico.
Una prima soluzione consiste nell'utilizzare BrowserShot, una libreria che si basa su un vero e proprio browser in background (Headless Chrome) per caricare la pagina ed eseguire il codice JavaScript.
Puoi anche integrare PHP con strumenti basati su Node.js, come Puppeteer Dove Selenium, per generare il codice HTML finale e poi recuperare i dati dal tuo script.
Esistono alternative a PHP per il web scraping?
Sì, ci sono diversi linguaggi molto diffusi per lo scraping:
- Pitone, con le sue potenti librerie come BeautifulSoup e Scrapy.
- Node.js, molto efficace per i siti dinamici, tramite librerie come Puppeteer Dove Cheerio.

Come programmare uno scraper in modo etico e responsabile?
Per effettuare lo scraping in modo responsabile, è necessario seguire alcune semplici regole:
- Controlla il file robots.txt del sito per conoscere le regole di accesso.
- Limita la frequenza delle tue richieste per non sovraccaricare il server.
- Rispetta le condizioni d'uso del sito.
- Non raccoglie dati personali senza autorizzazione.
Il web scraping è una pratica molto efficace, a patto di utilizzarla con metodo e buon senso. E tu, hai già creato un scraper in PHP Oppure con un altro linguaggio? Condividi la tua esperienza nei commenti!





 IT