PHP no sirve solo para crear sitios web dinámicos. Con bibliotecas como Guzzle y Goutte, puedes construir un scraper funcional y extraer datos automáticamente de cualquier página web.
Las empresas lo utilizan para hacer un seguimiento de los precios, analizar las redes sociales o recabar información sobre sus competidores.
Requisitos previos para el scraping con PHP
la raspado web consiste en extraer datos automáticamente de páginas web. Un programa recorre el HTML de una página web, selecciona la información útil y, a continuación, la guarda en un archivo o en una base de datos. En PHP, bastan unas pocas bibliotecas para crear un scraper que funcione, pero antes de ponerte manos a la obra, comprueba que cumples estos requisitos:
- En Conceptos básicos de programación en PHP, ya que vas a escribir código para controlar la extracción.
- Dominar algunos conocimientos básicos de HTML y CSS, para seleccionar con precisión los elementos que se quieren extraer de la página.
- Saber utilizar Marque, la herramienta que gestiona las dependencias de PHP e instala bibliotecas como Guzzle, Symfony DomCrawler o Goutte.
- Tener un servidor web local Para ejecutar tu programa: XAMPP, WAMP Donde MAMP funcionan muy bien.
- Instalar un editor de código para escribir y organizar tus scripts PHP.
Una vez que tengas todas estas herramientas, estarás listo para recopilar y analizar los datos que te interesan. Si buscas herramientas gratuitas Para empezar sin gastar dinero, hay varias opciones adecuadas para principiantes.
¿Qué herramientas son esenciales para el web scraping con PHP?
El PHP por sí solo no basta para realizar el web scraping de forma eficaz. Son los bibliotecas instaladas a través de Composer que hacen que la extracción sea rápida y fiable. Estas son las herramientas que debes conocer.
1. Guzzle: el cliente HTTP
Guzzle es la la biblioteca más utilizada para enviar solicitudes HTTP. Es la herramienta que permite obtener el código fuente de una página web. Para instalarla, abre tu terminal, ve a la carpeta de tu proyecto y escribe:
composer require guzzlehttp/guzzleComposer Descarga la biblioteca y utilízala directamente en tu código. Puedes consultar la documentación oficial de Guzzle para obtener más información.
He aquí un ejemplo sencillo para recuperar el contenido de una URL :
request('GET', $url);

    // Recuperar el código HTTP
    $statusCode = $response->getStatusCode();

    // Recuperar el contenido de la página
    $content = $response->getBody()->getContents();

    echo "Código HTTP : " . $statusCode . PHP_EOL;
    echo "Contenido de la página:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Error: " . $e->getMessage();
}
2. Symfony DomCrawler y Goutte: la extracción de datos
Una vez obtenido el código HTML, hay que analizarlo para extraer los datos útiles. Hay dos bibliotecas muy útiles para ello:
- Symfony DomCrawler : permite navegar por el código HTML con Selectores CSS y seleccionar elementos concretos (título, precio, enlace…).
- Goutte : es un envoltorio de Guzzle y DomCrawler que simplifica considerablemente el proceso de scraping.
Anotar : el paquete Goutte hoy es en desuso y archivado desde 2022. Para un nuevo proyecto, es mejor Symfony BrowserKit con DomCrawler, Donde Symfony Panther si tienes que gestionar contenido cargado mediante JavaScript. También puedes echar un vistazo al enfoque con Laravel, que ofrece un marco estructurado para este tipo de proyectos.
Ejemplo con Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// Selección por clase
$crawler->filter('.my-class')->each(function ($node) {
    echo $node->texto() . PHP_EOL;
});

// Selección por ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selección por etiqueta
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Ejemplo con Goutte:
request('GET', 'https://exemple.com');

// Selección por clase
$crawler->filter('.ma-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selección por ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Selección por etiqueta
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Otras bibliotecas y herramientas
Si quieres profundizar más, existen otras herramientas que se adaptan a tus necesidades en función del volumen de datos que quieras recopilar.
- PHP-Scraper : una biblioteca que facilita la extracción de información al gestionar las complejidades del HTML y los selectores. Su paquete real no es el de Goutte.
# Instalación con Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Título de la página: " . $web->title;
- Datos brillantes : una plataforma profesional para la recopilación de datos a gran escala, con proxies integrados para evitar el bloqueo de direcciones IP.

- ScraperAPI : un servicio de extracción de datos web basado en la nube, al que se puede acceder a través de una API. Solo tienes que enviar una sencilla solicitud indicando la URL que quieres rastrear, y el servicio se encarga por sí mismo de gestionar los proxies.
¿Cómo puedo crear un raspador web sencillo en PHP?
A continuación te explicamos cómo construir un Scraper funcional en PHP con Goutte, paso a paso: instalación de una biblioteca, obtención del código HTML, extracción de los datos y, a continuación, exportación.
Paso 1: Instalación de las dependencias
Utiliza Marque instalar Goutte con este comando:
compose require fabpot/goutte
Paso 2: Recuperar el contenido de la página
Haz una Solicitud HTTP GET para recuperar el contenido HTML de la página. Este es el código básico:
request('GET', $url);

// Recuperar el HTML en bruto si es necesario
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // vista previa
Paso 3: Extraer los datos
Una vez obtenido el código HTML, seleccionas elementos concretos mediante un Selector CSS (Donde XPath). He aquí un ejemplo de extraer los títulos de una página de blog. El selector artículo h2 se centra en las etiquetas <h2> dentro de las balizas <article> :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Qué hace este código:
- El selector
artículo h2se centra en los títulos de las etiquetas<h2>. - El método
texto()extrae el texto de cada título. - Cada título se añade a la tabla
$ítulos, y luego se muestra conprint_r().
Los selectores CSS también sirven para extraer atributos de elementos HTML. Si cada título es un enlace dentro de una etiqueta <a>, recuperas el atributo href Para obtener la URL del artículo:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
La mesa $ítulos contiene, pues, para cada artículo, tanto el título y su enlace :
Matriz
(
    [0] => Array
        (
            [title] => Título del artículo 1
            [url] => /artículo1
        )

    [1] => Array
        (
            [title] => Título del artículo 2
            [url] => /artículo2
        )
)
Cada entrada es un array asociativo con dos claves: título para el título y URL para la dirección de la página. Obtienes una estructura limpia, lista para ser analizada o almacenada.
Etapa 4: Estructuración y almacenamiento de datos
Una vez extraídos los datos en la tabla $data, puedes exportar en un formato estructurado. Los dos formatos más útiles son el JSON y el CSV.
la JSON es útil para alimentar una API o una aplicación web:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
El expediente export.json se verá así:
[
    {
        "title": "Título del artículo 1",
        "url": "/article1"
    },
    {
        "title": "Título del artículo 2",
        "url": "/artículo2"
    }
]
Si prefieres una tabla CSV, utiliza fputcsv Para escribir cada línea en un archivo:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
El expediente export.csv se verá así:
título,url
Título del artículo 1,/artículo1
Título del artículo 2,/artículo2
Si se trata de grandes volúmenes de datos, recuerda escribir en el archivo progresivamente en lugar de cargarlo todo en la memoria. También puedes guardar directamente el resultado en un base de datos, lo que a su vez facilita el análisis y la actualización de la información recopilada.
¿Cómo puedo hacer frente a los problemas comunes de web scraping en PHP?
El web scraping en PHP no siempre sale como se espera. Un servidor que no responde, una página mal estructurada, un bloqueo por IP: estos problemas surgen rápidamente. A continuación te explicamos cómo gestionar los más habituales para que tu programa de extracción sea más fiable.
1. Gestión de errores
- Errores de conexión
A veces, la solicitud ni siquiera llega al servidor. Es posible que te encuentres con "No network, "URL no válida Donde "Servidor inaccesible. En ese caso, incluye un bloque try/catch para evitar que tu script se detenga de forma brusca.
He aquí un ejemplo concreto con Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Códigos de estado HTTP
Incluso cuando la conexión funciona, el servidor puede responder con un error: 404 = página no encontrada, 500 = error interno del servidor. Puedes probar el código devuelto con getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Errores de análisis sintáctico
El análisis sintáctico es el’análisis del HTML por tu scraper. Si la página tiene un formato incorrecto, DomCrawler Donde Goutte pueden fallar o no devolver ningún resultado. Comprueba siempre que el contenido exista antes de intentar extraerlo, con condiciones como count() Donde filter(), y luego rodea el análisis sintáctico con un try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Eludir las restricciones y las medidas de protección contra el scraping
Muchas páginas web implementan medidas de protección para dificultar el web scraping. A continuación se detallan los principales obstáculos y cómo gestionarlos adecuadamente:
- Bloqueo por IP : si envías demasiadas solicitudes, la página web puede bloquear tu dirección IP. La solución consiste en utilizar proxies rotativos, como los de Bright Data, para distribuir tus solicitudes entre varias direcciones.
- Intervalo entre las solicitudes : espacia tus llamadas en el tiempo para pasar desapercibido y no sobrecargar el servidor de destino.
- Contenido en JavaScript por defecto, PHP no puede ejecutar JavaScript. Para extraer datos de una página cuyo contenido se carga dinámicamente, necesitas un navegador sin cabeza (navegador sin interfaz gráfica). Herramientas como Puppeteer Donde Selenium muestran la página como si fuera un navegador real antes de la extracción.
- Archivo robots.txt : antes de poner en marcha tu scraper, comprueba este archivo, que se encuentra en la raíz del sitio web. En él se indica lo que el sitio web permite o no a los robots, un paso clave para actuar de forma responsable.
preguntas frecuentes
¿Es legal el web scraping?
Él legalidad del web scraping depende de los datos recopilados y de cómo los utilices. En Francia, extraer datos de datos públicos y no personales Por lo general se tolera, pero eso no significa que se dé luz verde automáticamente.
Hay tres restricciones legales que pueden hacer que la extracción sea ilegal, incluso en páginas públicas:
- la RGPD : cuando se trata de datos personales, «público» no significa que se pueda utilizar libremente.
- Él Condiciones generales de uso del sitio web : si utilizas una cuenta para acceder al contenido, has aceptado unas condiciones que, a menudo, prohíben el scraping.
- la derecho sui generis sobre las bases de datos: en Europa, una base de datos goza de una protección específica.
En la práctica, cada caso se evalúa de forma individual. Consulta siempre el archivo robots.txt y las condiciones de uso de la página web antes de iniciar tu programa.
¿Cuál es la diferencia entre web scraping y web crawling?
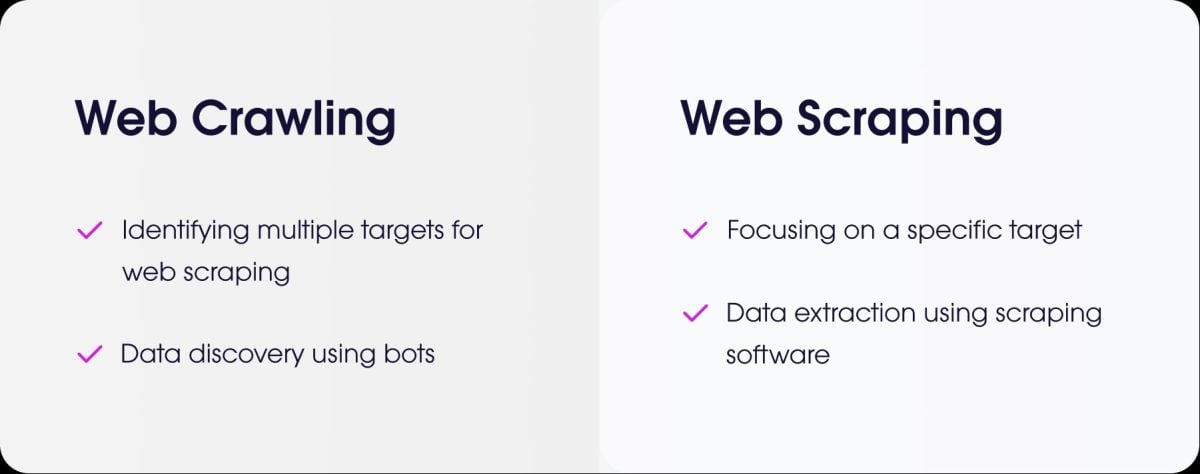
- la raspado web es extraer datos precisos en una página web.
- la rastreo web es recorrer las páginas para indexarlas, tal y como lo hace un robot de un motor de búsqueda.
¿Cómo hago scraping de un sitio que requiere autenticación (login)?
Para extraer datos de una página web que requiere iniciar sesión, hay que simular la autenticación. Con PHP, la solución más habitual sigue siendo Guzzle. Envías tus datos de acceso mediante una solicitud CORREO, y luego mantienes la sesión abierta para poder acceder a las páginas protegidas.
¿Cómo se gestiona el scraping de sitios con páginas dinámicas cargadas en AJAX?
PHP no puede ejecutar código JavaScript del lado del cliente. El contenido cargado en AJAX Por lo tanto, no puede ser extraída con un scraper clásico.
Una primera solución consiste en utilizar BrowserShot, una biblioteca que se basa en un navegador real en segundo plano (Headless Chrome) para cargar la página y ejecutar el JavaScript.
También puedes integrar PHP con herramientas basadas en Node.js, como Puppeteer Donde Selenium, para generar el código HTML final y, a continuación, recuperar los datos desde tu script.
¿Existen alternativas a PHP para el web scraping?
Sí, hay varios lenguajes muy populares para el scraping:
- Python, con sus potentes bibliotecas como BeautifulSoup y Scrapy.
- Node.js, muy eficaz para sitios web dinámicos, a través de bibliotecas como Puppeteer Donde Cheerio.

¿Cómo programar un scraper de forma ética y responsable?
Para realizar scraping de forma responsable, hay que seguir unas cuantas reglas sencillas:
- Comprueba el archivo robots.txt de la página web para conocer las normas de acceso.
- Limita la frecuencia de tus consultas para no sobrecargar el servidor.
- Respeta las condiciones de uso del sitio.
- No recopila datos personales sin autorización.
El web scraping es una práctica muy eficaz, siempre y cuando se utilice con método y sentido común. ¿Y tú, ya has creado un scraper en PHP ¿O con otro lenguaje? ¡Cuéntanos tu experiencia en los comentarios!








 ES