PHP não serve apenas para criar sites dinâmicos. Com bibliotecas como Guzzle e Goutte, podes construir um scraper funcional e extrair automaticamente dados de qualquer página da Internet.
As empresas utilizam-no para monitorizar os preços, analisar as redes sociais ou recolher informações sobre os seus concorrentes.
Pré-requisitos para a recolha de dados com PHP
a raspagem da web consiste em extrair automaticamente dados de páginas da Internet. Um programa percorre o HTML de um site, identifica as informações úteis e, em seguida, guarda-as num ficheiro ou numa base de dados. Em PHP, bastam algumas bibliotecas para criar um scraper funcional, mas antes de começares, verifica se cumpres estes requisitos:
- Ter noções básicas de programação em PHP, porque vais escrever código para controlar a extração.
- Dominar alguns noções básicas de HTML e CSS, para selecionar com precisão os elementos a extrair da página.
- Saber utilizar Marcação, a ferramenta que gere as dependências PHP e instala bibliotecas como Guzzle, Symfony DomCrawler ou Goutte.
- Ter um servidor Web local Para executar o teu programa: XAMPP, WAMP Onde MAMP servem perfeitamente.
- Instalar um editor de código para escrever e organizar os teus scripts PHP.
Depois de reunires estas ferramentas, estás pronto para recolher e analisar os dados que te interessam. Se procuras ferramentas gratuitas Para começar sem gastar dinheiro, existem várias opções adequadas para principiantes.
Que ferramentas são essenciais para a recolha de dados da Web com PHP?
O PHP, por si só, não é suficiente para fazer web scraping de forma eficaz. São os bibliotecas instaladas através do Composer que tornam a extração rápida e fiável. Eis as ferramentas que deve conhecer.
1. Guzzle: o cliente HTTP
Guzzle é aqui biblioteca mais utilizada para enviar pedidos HTTP. É ela que recupera o código-fonte de uma página web. Para a instalar, abre o teu terminal, vai até à pasta do teu projeto e, em seguida, digita:
compositor require guzzlehttp/guzzleComposer Descarrega a biblioteca e torna-a utilizável diretamente no teu código. Podes consultar a documentação oficial do Guzzle para saberes mais.
Eis um exemplo simples para obter o conteúdo de um URL :
request('GET', $url);

    // Obter o código HTTP
    $statusCode = $response->getStatusCode();

    // Obter o conteúdo da página
    $content = $response->getBody()->getContents();

    echo "Código HTTP : " . $statusCode . PHP_EOL;
    echo "Conteúdo da página:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Erro: " . $e->getMessage();
}
2. Symfony DomCrawler e Goutte: a extração de dados
Depois de obter o código HTML, é necessário analisá-lo para extrair os dados úteis. Existem duas bibliotecas que são muito úteis para isso:
- Symfony DomCrawler : permite navegar pelo HTML com Seletores CSS e selecionar elementos específicos (título, preço, link…).
- Goutte : trata-se de um wrapper do Guzzle e do DomCrawler que simplifica consideravelmente o processo de scraping.
Anotar : o pacote Goutte é hoje descontinuado e arquivado desde 2022. Para um novo projeto, prefira Symfony BrowserKit com DomCrawler, Onde Symfony Panther se precisares de gerir conteúdo carregado em JavaScript. Também podes dar uma vista de olhos à abordagem com Laravel, que oferece um quadro estruturado para este tipo de projeto.
Exemplo com o Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// Seleção por classe
$crawler->filter('.my-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleção por ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleção por etiqueta
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Exemplo com a Goutte:
request('GET', 'https://exemple.com');

// Seleção por classe
$crawler->filter('.ma-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleção por ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleção por etiqueta
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Outras bibliotecas e ferramentas
Para aprofundar o assunto, existem outras ferramentas que se adaptam às tuas necessidades, consoante o volume de dados a recolher.
- PHP-Scraper : uma biblioteca que facilita a extração de informações, gerindo as complexidades do HTML e dos seletores. O seu verdadeiro pacote não é o do Goutte.
# Instalação com o Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Título da página: " . $web->title;
- Dados brilhantes : uma plataforma profissional para a recolha de dados em grande escala, com proxies integrados para evitar o bloqueio de IPs.

- API do raspador : um serviço de scraping na Web baseado na nuvem, acessível através de uma API. Basta enviar um simples pedido indicando o URL a ser rastreado, e o serviço trata ele próprio dos proxies.
Como posso criar um raspador Web simples em PHP?
Eis como construir um scraper funcional em PHP com Goutte, passo a passo: instalação de uma biblioteca, recuperação do HTML, extração dos dados e, por fim, exportação.
Passo 1: Instalar as dependências
Utiliza Marcação para instalar Goutte com este comando:
compose require fabpot/goutte
Passo 2: Recuperar o conteúdo da página
Faz uma Pedido HTTP GET para recuperar o conteúdo HTML da página. Eis o código básico:
request('GET', $url);

// Recuperar o HTML em bruto, se necessário
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // pré-visualização
Passo 3: Extrair os dados
Depois de obter o HTML, seleciona elementos específicos através de um Seletor CSS (Onde XPath). Eis um exemplo para extrair os títulos de uma página de blogue. O seletor item h2 seleciona as balizas <h2> dentro das balizas <article> :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
O que este código faz:
- O seletor
item h2destina-se aos títulos nas balizas<h2>. - O método
texto()recupera o texto de cada título. - Cada título é adicionado à tabela
$ítulos, e depois apresentado comprint_r().
Os seletores CSS também servem para extrair atributos de elementos HTML. Se cada título for um link numa baliza <a>, recuperas o atributo href para obter o URL do artigo:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
O quadro $ítulos contém, então, para cada artigo, tanto o título e a sua link :
Matriz
(
    [0] => Matriz
        (
            [título] => Título do artigo 1
            [url] => /artigo1
        )

    [1] => Matriz
        (
            [título] => Título do artigo 2
            [url] => /artigo2
        )
)
Cada entrada é um tabuła associativa com duas chaves: título para o título e url para o endereço da página. Obtém-se uma estrutura organizada, pronta a ser analisada ou guardada.
Fase 4: Estruturação e armazenamento de dados
Depois de extraídos os dados para a tabela $data, podes exportar num formato estruturado. Os dois formatos mais úteis são o JSON e a CSV.
a JSON é útil para alimentar uma API ou uma aplicação web:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
O ficheiro exportar.json terá o seguinte aspeto:
[
    {
        "title": "Título do artigo 1",
        "url": "/article1"
    },
    {
        "título": "Título do artigo 2",
        "url": "/article2"
    }
]
Se preferires um quadro CSV, utiliza fputcsv para escrever cada linha num ficheiro:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
O ficheiro exportar.csv terá o seguinte aspeto:
título,url
Título do artigo 1,/article1
Título do artigo 2,/article2
No caso de grandes volumes de dados, lembra-te de gravar no ficheiro progressivamente em vez de carregar tudo na memória. Também podes guardar diretamente o resultado numa base de dados, o que facilita, posteriormente, a análise e a atualização das informações recolhidas.
Como posso lidar com problemas comuns de raspagem da Web em PHP?
O web scraping em PHP nem sempre corre como previsto. Um servidor que não responde, uma página mal estruturada, um bloqueio por IP: estes problemas surgem rapidamente. Eis como lidar com os mais comuns para tornar o teu programa de extração mais fiável.
1. Gestão de erros
- Erros de ligação
Por vezes, o pedido nem sequer chega ao servidor. Podes deparar-te com "Não há rede, "URL inválido Onde "Servidor inacessível. Nesse caso, prevê um bloco try/catch para evitar que o teu script pare abruptamente.
Eis um exemplo concreto com Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Códigos de estado HTTP
Mesmo quando a ligação funciona, o servidor pode responder com um erro: 404 = página não encontrada, 500 = erro interno do servidor. Podes testar o código devolvido com getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Erros de análise
A análise sintática é a’análise do HTML pelo teu scraper. Se a página estiver mal estruturada, DomCrawler Onde Goutte podem falhar ou não devolver nada. Verifica sempre se o conteúdo existe antes de tentares extraí-lo, com condições como count() Onde filter(), e, em seguida, envolve a análise com um try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Contornar as limitações e as proteções contra a extração de dados
Muitos sites implementam medidas de proteção para dificultar o web scraping. Aqui estão os principais obstáculos e como lidar com eles de forma adequada:
- Bloqueio por IP : quando envias demasiados pedidos, o site pode bloquear o teu endereço IP. A solução consiste em utilizar proxies rotativos, tal como os de Bright Data, para distribuir os teus pedidos por vários endereços.
- Intervalo entre os pedidos : espalhe as suas chamadas ao longo do tempo para passar despercebido e não sobrecarregar o servidor de destino.
- Conteúdo em JavaScript por defeito, o PHP não pode executar JavaScript. Para extrair uma página cujo conteúdo é carregado dinamicamente, precisas de um navegador sem cabeça (navegador sem interface gráfica). Ferramentas como Puppeteer Onde Selenium fazem com que a página seja apresentada como num navegador real antes da extração.
- Ficheiro robots.txt : antes de lançar o teu scraper, verifica este ficheiro na raiz do site. Ele indica o que o site permite ou não aos robôs, um passo fundamental para agir de forma responsável.
Perguntas frequentes
A raspagem da Web é legal?
o legalidade da recolha de dados na Web depende dos dados recolhidos e da forma como os aproveitas. Em França, fazer scraping de dados públicos e não pessoais é geralmente tolerado, mas não significa que seja automaticamente aprovado.
Existem três restrições legais que podem tornar a extração ilegal, mesmo em páginas públicas:
- a RGPD : sempre que estejam em causa dados pessoais, «público» não significa que a utilização seja livre.
- o Termos e Condições Gerais de Utilização do site : se utilizares uma conta para aceder ao conteúdo, estás a aceitar condições que, muitas vezes, proíbem o scraping.
- a direito sui generis sobre as bases de dados: na Europa, uma base de dados beneficia de uma proteção específica.
Na prática, cada caso é avaliado individualmente. Consulta sempre o ficheiro robots.txt e as condições de utilização do site antes de iniciares o teu programa.
Qual é a diferença entre web scraping e web crawling?
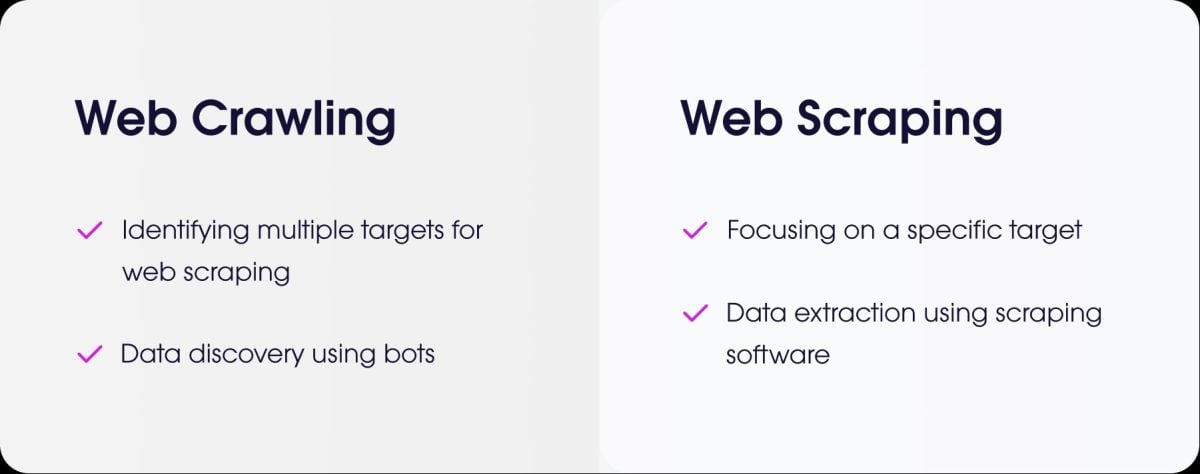
- a raspagem da web é extrair dados precisos num sítio web.
- a rastreio da web é navegar pelas páginas para as indexar, tal como faz um robô de um motor de busca.
Como é que faço scraping de um sítio que requer autenticação (login)?
Para fazer scraping de um site que exige uma ligação, é necessário simular a autenticação. No PHP, a solução mais comum continua a ser Guzzle. Envias os teus dados de identificação através de uma solicitação PUBLICAR, e depois manténs a sessão aberta para aceder às páginas protegidas.
Como é que se gere a recolha de dados de sítios com páginas dinâmicas carregadas em AJAX?
O PHP não consegue executar o código JavaScript do lado do cliente. O conteúdo carregado em AJAX por isso, não pode ser captado por um scraper clássico.
Uma primeira solução consiste em utilizar BrowserShot, uma biblioteca que se baseia num navegador real em segundo plano (Headless Chrome) para carregar a página e executar o JavaScript.
Também podes integrar o PHP com ferramentas baseadas em Node.js, Como Puppeteer Onde Selenium, para gerar o HTML final e, em seguida, recuperar os dados a partir do teu script.
Existem alternativas ao PHP para a recolha de dados da Web?
Sim, existem várias linguagens de programação muito populares para o scraping:
- Python, com as suas poderosas bibliotecas, tais como BeautifulSoup e Scrapy.
- Node.js, muito eficaz para sites dinâmicos, através de bibliotecas como Puppeteer Onde Cheerio.

Como programar um scraper de forma ética e responsável?
Para fazer scraping de forma responsável, é necessário seguir algumas regras simples:
- Verifica o ficheiro robots.txt do site para conhecer as regras de acesso.
- Limita a frequência das tuas consultas para não sobrecarregar o servidor.
- Respeite as condições de utilização do sítio.
- Não recolhe dados pessoais sem autorização.
O web scraping é uma prática poderosa, desde que seja utilizada com método e bom senso. E tu, já criaste um raspador em PHP ou com outra linguagem? Partilha a tua experiência connosco nos comentários!








 PT