Para criar um bot de web scraping, precisas de Python, da biblioteca Requests para recuperar as páginas e de BeautifulSoup para extrair os dados.
Este guia mostra-te como criar um script funcional em 5 passos. Um bot de web scraping é um programa automatizado que recolhe dados na Internet a partir de sites: percorre as páginas, extrai as informações úteis e guarda-as para utilização posterior.
Antes de lançares o teu bot, não te esqueças de verificar o ficheiro robots.txt do site de destino para saberes quais as páginas que podes visitar.

Requisitos para criar um bot de raspagem da Web
A primeira coisa que tens de escolher é o teu linguagem de programação. É isso que determina as ferramentas disponíveis e a facilidade de implementação.
- Python : a linguagem mais popular para a extração de dados da Web. É fácil de aprender e dispõe de um ecossistema muito rico de bibliotecas para a extração de dados.
- Node.js : ideal para tarefas assíncronas, com ferramentas bastante avançadas (Puppeteer, Playwright) para extrair dados de sites dinâmicos que utilizam JavaScript.
- Outras línguas : para alguns projetos, também podes recorrer ao web scraping com PHP.
Depois de escolheres a linguagem, precisas das ferramentas certas bibliotecas. São elas que fazem realmente o trabalho. Aqui estão as mais úteis, consoante o ambiente.
Por Python :
- Requests : envia Pedidos HTTP para recuperar o conteúdo de uma página.
- BeautifulSoup : analisa o HTML e permite extrair as informações úteis (texto, preços, links, imagens).
- Scrapy : um framework completo para projetos de scraping mais ambiciosos, com gestão de pedidos em grande escala.
Por Node.js :
- Axios Onde Fetch : para enviar os pedidos HTTP.
- Cheerio : o equivalente a BeautifulSoup, muito prático para percorrer e manipular o DOM.
- Puppeteer Onde Playwright : indispensáveis para extrair dados de sites dinâmicos. Controlam um navegador real e executam o código JavaScript da página.
Tutorial para criar um bot de raspagem da Web
Criar um bot de scraping pode parecer complexo, mas, na prática, é bastante acessível. Seguindo estes 5 passos, obtém-se um script funcional para recolher dados na Internet. Certifica-te de que tens instalado Python e as bibliotecas necessárias antes de começar.
Passo 1: Analisar o sítio-alvo
Antes de programar qualquer coisa, tens de saber onde se encontram os dados na página. Esta etapa de’análise determina tudo o resto.
- Abre o site de destino no teu navegador.
- Clica com o botão direito do rato e, em seguida, seleciona Inspecionar sobre o tema que te interessa.
- Identifica as etiquetas HTML, as classes ou os IDs que contêm o conteúdo a extrair (por exemplo
.produto,.título,.preço). - Testa os teus Seletores CSS na consola. Se os títulos dos produtos estiverem entre balizas
<h2>, vais voltar a utilizar esse seletor no teu código.
Passo 2: Enviar um pedido HTTP
O teu bot funciona como um navegador: envia um Pedido HTTP ao servidor, que devolve o código HTML da página. É essa a função da biblioteca Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # erro se o código for 4xx ou 5xx
html = resp.text
print(html[:500])  # pré-visualização
Passo 3: Analisar o conteúdo HTML
Depois de carregar a página, tens de transformar esse HTML bruto num objeto que possa ser manipulado. Essa é a função de BeautifulSoup, a biblioteca de referência para extrair dados de HTML.
# pip install beautifulsoup4
from bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

produtos = soup.select(".product")
print(f "Produtos encontrados : {len(produtos)}")

para p em produtos[:3]:
    title = p.select_one("h2.title").get_text(strip=True)
    preço = p.select_one(".price").get_text(strip=True)
    link = p.select_one("a")["href"]
    print({"title": título, "price": preço, "link": link})
Passo 4: Extrair os dados
Esta é a etapa mais concreta: ir buscar os informações precisas como títulos, preços e links. Também podes limpá-los de passagem, por exemplo, convertendo um preço do texto por quantidade.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Passo 5: Cópia de segurança dos dados
Para não perderes os teus resultados, guarda-os num ficheiro. Os dois formatos mais comuns são o CSV (folha de cálculo) e o JSON (ideal para alimentar uma base de dados ou uma API).
importar csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
com open("export/products.csv", "w", newline="", encoding="utf-8") as f:
    fields = ["title", "price", "url"]
    escritor = csv.DictWriter(f, fieldnames=fields, delimiter=";")
    escritor.writeheader()
    writer.writerows(dados)

# JSON
com open("export/products.json", "w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("Exportação completa!")
Agora já tens um bot de scraping completo: ele envia um pedido, analisa o HTML, extrai o conteúdo e guarda os dados num ficheiro CSV ou JSON. É uma base sólida para automatizar a recolha de dados na maioria dos sites estáticos.
Como gerir as proteções contra o scraping?
Os sítios Web implementam vários mecanismos para proteger os seus dados contra os robôs. Compreender estas medidas de proteção é essencial para fazer scraping de forma responsável e evitar que a tua conta seja bloqueada.
O ficheiro robots.txt
a ficheiro robots.txt indica quais as páginas que um bot pode ou não pode percorrer num site. Atenção: controla o crawl, e não a indexação, e o seu cumprimento depende da boa vontade dos robôs.
Verifica sempre este ficheiro antes de lançares o teu scraper. Respeitá-lo reduz os riscos, mas não é suficiente para tornar a tua recolha de dados legal: os condições de utilização do site e o RGPD também se aplicam.
Os captchas
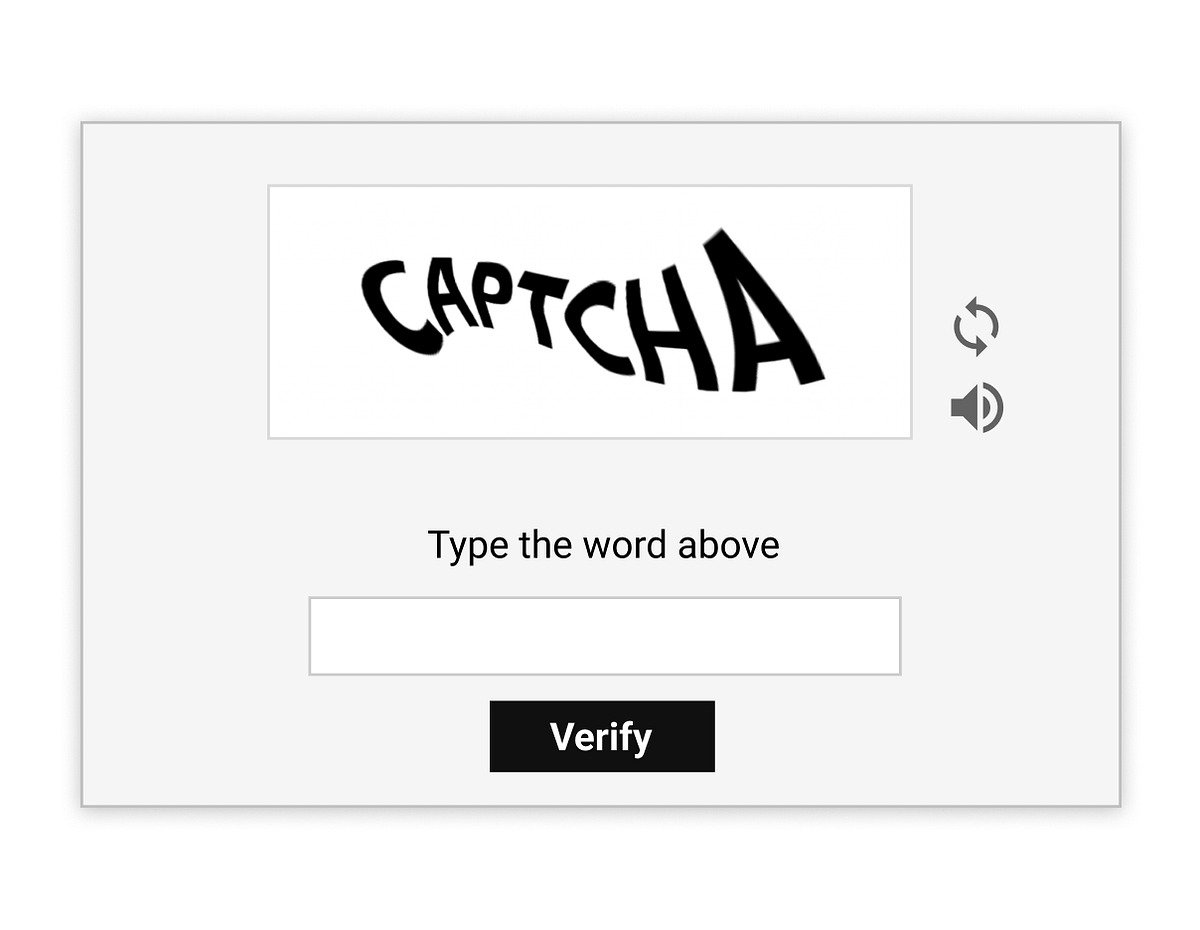
a captcha serve para verificar se o utilizador é realmente humano. É uma das medidas de proteção mais eficazes contra o scraping automático.
Para limitar o seu aparecimento, podes utilizar bibliotecas de automatização que simulam um navegador real. Também existem serviços de terceiros especializados na resolução de captchas, úteis quando o volume de pedidos se torna elevado.
Bloqueios por endereço IP
Alguns sites detetam um grande número de pedidos provenientes do mesmo Endereço IP e bloqueiam o acesso. Este é o sinal típico de um bot que recolhe dados demasiado depressa.
Para evitar isso, usa proxies ou um vpn para alterar regularmente o endereço IP. Adiciona também um intervalo entre cada pedido, para simular uma navegação humana.
Bloqueios por User-Agent
Os sites podem recusar pedidos provenientes de bots identificados por um User-Agent suspeito. Sem um User-Agent válido, muitos servidores devolvem um erro 403 ou uma página em branco.
O truque consiste em definir um User-Agent realista nas tuas requisições HTTP para pareceres um navegador normal. No entanto, deves ter em conta que essa não é a única barreira: os cookies e a assinatura do navegador também são importantes.
Sites em JavaScript
Algumas páginas carregam o seu conteúdo através de JavaScript, o que impede que as simples solicitações HTTP recuperem os dados. O HTML recebido fica, assim, sem a informação que procuras.
Nesse caso, opta por ferramentas capazes de executar JavaScript: Selenium, Playwright Onde Puppeteer. Funcionam como um verdadeiro navegador e permitem-te extrair os dados assim que a página estiver totalmente carregada.
Perguntas frequentes
Qual é a diferença entre um robot de raspagem da Web e um Web crawler?
| Raspagem da Web | Rastreador da Web |
|---|---|
| O bot concentra-se em dados precisos : títulos, preços, links de produtos. Ele lê o HTML, identifica os elementos relevantes e extrai-os para os utilizar posteriormente (análise, armazenamento numa base de dados, exportação para CSV ou JSON). | O crawler é um programa que percorre automaticamente as páginas, seguindo os links para descobrir conteúdos. O seu objetivo é mapear e indexar a Web, não necessariamente extrair dados específicos da mesma. |
A raspagem da Web é legal?
o legalidade da recolha de dados na Web depende do site, do tipo de dados recolhidos e da utilização que lhes dás. Muitas vezes, é possível extrair dados públicos, mas «público» não significa «de livre utilização». Muitas empresas utilizam a extração de dados da Web para análises de mercado ou para recolher informações disponíveis publicamente na Internet.
Por outro lado, assim que se toca em dados pessoais, a RGPD regulamenta rigorosamente a recolha de dados (base jurídica válida, minimização dos dados), sob pena de sanções severas. Verifique sempre os condições de utilização do site de destino antes de lançares o teu bot.
Que tipos de dados podem ser extraídos com um bot de raspagem da Web?
Com um bot de scraping, podes recolher:
- Do títulos e descrições de produtos.
- Do preços e promoções (útil para o scraping de preços e a monitorização das tarifas da concorrência).
- Do ligações internas ou externas.
- Do opiniões e avaliações dos utilizadores.
- Informações de contacto (trata-se de dados pessoais, sujeitos ao RGPD).
- Do conteúdo textual ou imagens páginas web.
Estes dados são frequentemente utilizados para a inteligência competitiva ou à análise de mercado.
Como é que um sítio Web pode detetar o meu bot de raspagem?
Os sites detetam frequentemente os bots através de comportamentos anormais, tais como:
- A velocidade das consultas demasiado elevada ou demasiado regular.
- UMA Agente de usuário não padrão, o que denota um scraper.
- EU'falha no carregamento dos recursos JavaScript necessários para a página.
- A navegação sem cookies, pouco natural para um ser humano.
Quais são os desafios comuns na criação de um bot de raspagem da Web?
Criar um bot eficaz nem sempre é fácil. Eis os desafios mais comuns:
- o estruturas HTML inconsistentes : um site pode alterar as suas classes CSS de um dia para o outro e o teu seletor deixa de apresentar resultados.
- o dados não estruturados : tens de limpar e reformatar o conteúdo antes de o guardar.
- o lentidão no carregamento das páginas, sobretudo em sites dinâmicos que apresentam o seu conteúdo através de JavaScript.
Existem serviços ou APIs de web scraping?
Sim. Existem serviços que simplificam o scraping e tratam dos aspetos mais complicados: proxies, captchas, sites dinâmicos. Também podes utilizar um API de recolha de dados da Web para recuperar diretamente dados estruturados. Bright Data é uma das soluções mais completas do mercado.
Para saber mais, consulta o nosso guia sobre o recolha de dados da Web com Python e descubra casos de utilização mais avançados.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA