Pour créer un bot de web scraping, tu as besoin de Python, de la bibliothèque Requests pour récupérer les pages et de BeautifulSoup pour en extraire les données.
Ce guide te montre comment assembler un script fonctionnel en 5 étapes. Un bot de web scraping est un programme automatisé qui collecte des données sur internet à partir de sites web : il parcourt les pages, extrait les informations utiles et les enregistre pour une utilisation ultérieure.
Avant de lancer ton bot, pense à vérifier le fichier robots.txt du site cible pour savoir quelles pages tu as le droit de parcourir.

Prérequis pour créer un bot de web scraping
La première chose à choisir, c’est ton langage de programmation. C’est lui qui conditionne les outils disponibles et la facilité de mise en œuvre.
- Python : le langage le plus populaire pour le web scraping. Il est facile à prendre en main et dispose d’un écosystème de bibliothèques très riche pour extraire des données.
- Node.js : idéal pour les tâches asynchrones, avec des outils très matures (Puppeteer, Playwright) pour scraper les sites dynamiques qui reposent sur du JavaScript.
- Autres langages : pour certains projets, tu peux aussi te tourner vers le web scraping avec PHP.
Une fois le langage choisi, il te faut les bonnes bibliothèques. Ce sont elles qui font vraiment le travail. Voici les plus utiles selon l’environnement.
Pour Python :
- Requests : envoie des requêtes HTTP pour récupérer le contenu d’une page.
- BeautifulSoup : parse le HTML et permet d’en extraire les informations utiles (texte, prix, liens, images).
- Scrapy : un framework complet pour les projets de scraping plus ambitieux, avec gestion des requêtes à grande échelle.
Pour Node.js :
- Axios ou Fetch : pour envoyer les requêtes HTTP.
- Cheerio : l’équivalent de BeautifulSoup, très pratique pour parcourir et manipuler le DOM.
- Puppeteer ou Playwright : indispensables pour scraper les sites dynamiques. Ils pilotent un vrai navigateur et exécutent le code JavaScript de la page.
Tutoriel pour créer un bot de web scraping
Créer un bot de scraping paraît complexe, mais c’est très accessible en pratique. En suivant ces 5 étapes, tu obtiens un script fonctionnel pour collecter des données sur le web. Assure-toi d’avoir installé Python et les bibliothèques nécessaires avant de commencer.
Étape 1 : Analyser le site cible
Avant de coder quoi que ce soit, tu dois savoir où se trouvent les données sur la page. Cette étape d’analyse conditionne tout le reste.
- Ouvre le site cible dans ton navigateur.
- Fais un clic droit, puis choisis Inspecter sur l’élément qui t’intéresse.
- Repère les balises HTML, les classes ou les ID qui contiennent le contenu à extraire (par exemple
.product,.title,.price). - Teste tes sélecteurs CSS dans la console. Si les titres des produits sont dans des balises
<h2>, tu réutiliseras ce sélecteur dans ton code.
Étape 2 : Envoyer une requête HTTP
Ton bot se comporte comme un navigateur : il envoie une requête HTTP au serveur, qui renvoie le code HTML de la page. C’est le rôle de la bibliothèque Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # erreur si code 4xx ou 5xx
html = resp.text
print(html[:500])  # aperçu
Étape 3 : Parser le contenu HTML
Une fois la page récupérée, tu dois transformer ce HTML brut en un objet manipulable. C’est le travail de BeautifulSoup, la bibliothèque de référence pour extraire des données depuis du HTML.
# pip install beautifulsoup4
from bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

produits = soup.select(".product")
print(f"Produits trouvés : {len(produits)}")

for p in produits[:3]:
    titre = p.select_one("h2.title").get_text(strip=True)
    prix = p.select_one(".price").get_text(strip=True)
    lien = p.select_one("a")["href"]
    print({"titre": titre, "prix": prix, "lien": lien})
Étape 4 : Extraire les données
C’est l’étape la plus concrète : aller chercher les informations précises comme les titres, les prix et les liens. Tu peux aussi les nettoyer au passage, par exemple en convertissant un prix texte en nombre.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Étape 5 : Sauvegarder les données
Pour ne pas perdre tes résultats, enregistre-les dans un fichier. Les deux formats les plus courants sont le CSV (tableur) et le JSON (idéal pour alimenter une base de données ou une API).
import csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
with open("export/produits.csv", "w", newline="", encoding="utf-8") as f:
    champs = ["titre", "prix", "url"]
    writer = csv.DictWriter(f, fieldnames=champs, delimiter=";")
    writer.writeheader()
    writer.writerows(data)

# JSON
with open("export/produits.json", "w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("Export terminé !")
Tu as désormais un bot de scraping complet : il envoie une requête, parse le HTML, extrait le contenu et sauvegarde les données dans un fichier CSV ou JSON. C’est une base solide pour automatiser la collecte de données sur la plupart des sites statiques.
Comment gérer les protections anti-scraping ?
Les sites web mettent en place plusieurs mécanismes pour protéger leurs données contre les robots. Comprendre ces protections est essentiel pour scraper de manière responsable et éviter de te faire bloquer.
Le fichier robots.txt
Le fichier robots.txt indique quelles pages un bot peut ou ne peut pas parcourir sur un site. Attention : il contrôle le crawl, pas l’indexation, et son respect repose sur la bonne volonté des robots.
Vérifie toujours ce fichier avant de lancer ton scraper. Le respecter réduit les risques, mais ne suffit pas à rendre ta collecte légale : les conditions d’utilisation du site et le RGPD s’appliquent aussi.
Les captchas
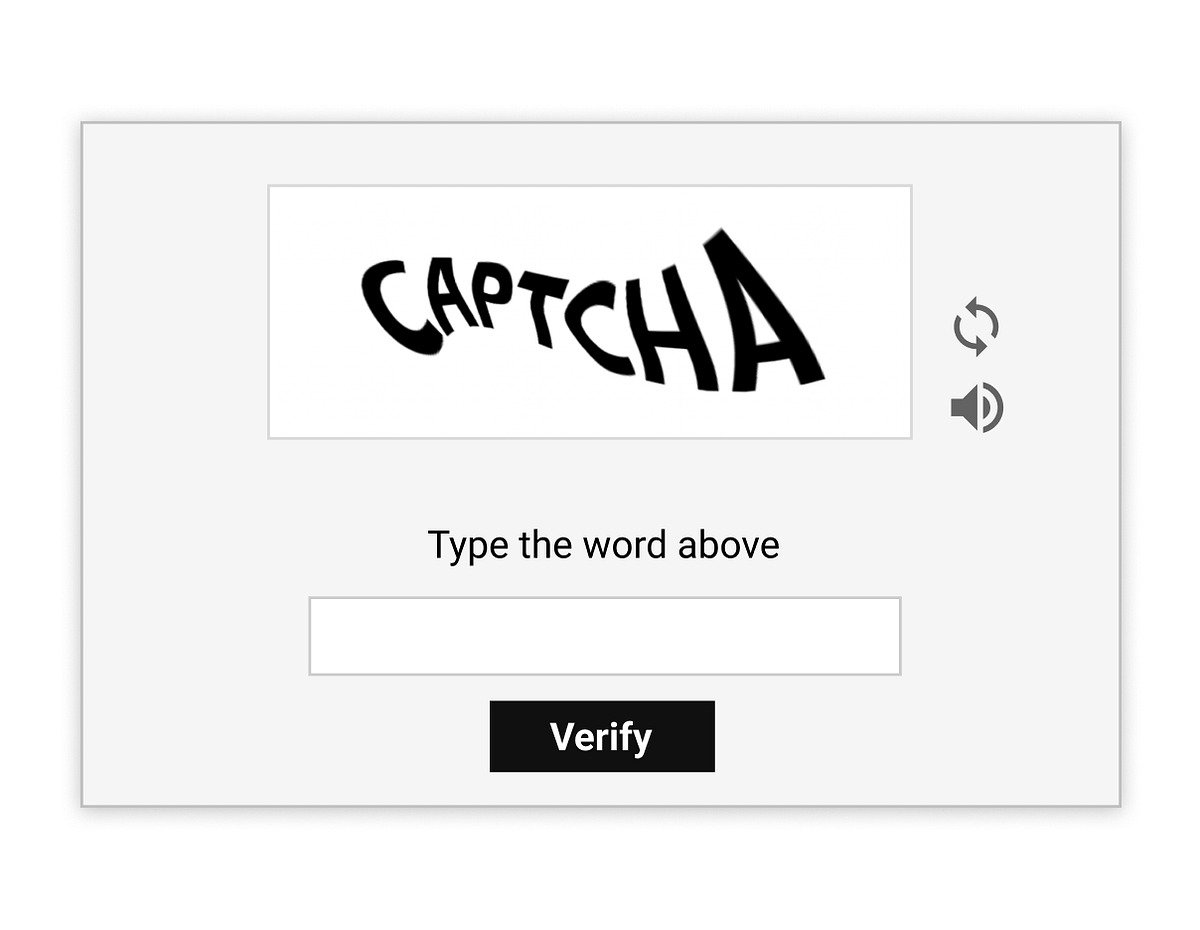
Le captcha sert à vérifier que l’utilisateur est bien humain. C’est l’une des protections les plus efficaces contre le scraping automatique.
Pour limiter leur apparition, tu peux utiliser des bibliothèques d’automatisation qui simulent un vrai navigateur. Il existe aussi des services tiers spécialisés dans la résolution de captchas, pratiques quand le volume de requêtes devient important.
Les blocages par adresse IP
Certains sites détectent un grand nombre de requêtes venant de la même adresse IP et bloquent l’accès. C’est le signal typique d’un bot qui collecte trop vite.
Pour l’éviter, utilise des proxies ou un VPN pour changer régulièrement d’IP. Ajoute aussi un délai entre chaque requête pour imiter une navigation humaine.
Les blocages par User-Agent
Les sites peuvent refuser les requêtes venant de bots identifiés par un User-Agent suspect. Sans User-Agent valide, beaucoup de serveurs renvoient une erreur 403 ou une page vide.
L’astuce est de définir un User-Agent réaliste dans tes requêtes HTTP pour ressembler à un navigateur classique. Sache toutefois que ce n’est pas la seule barrière : les cookies et l’empreinte du navigateur comptent aussi.
Les sites en JavaScript
Certaines pages chargent leur contenu via JavaScript, ce qui empêche les simples requêtes HTTP de récupérer les données. Le HTML reçu est alors vide de l’information que tu cherches.
Dans ce cas, tourne-toi vers des outils capables d’exécuter le JavaScript : Selenium, Playwright ou Puppeteer. Ils pilotent un vrai navigateur et te permettent d’extraire les données une fois la page entièrement rendue.
FAQ
Quelle est la différence entre un bot de web scraping et un crawler web ?
| Web scraping | Crawler web |
|---|---|
| Le bot se concentre sur des données précises : titres, prix, liens de produits. Il lit le HTML, repère les éléments pertinents et les extrait pour les utiliser ensuite (analyse, stockage en base de données, export en CSV ou JSON). | Le crawler est un programme qui parcourt automatiquement des pages en suivant les liens pour découvrir du contenu. Son but est de cartographier et d’indexer le web, pas forcément d’en extraire des données précises. |
Le web scraping est-il légal ?
La légalité du web scraping dépend du site, du type de données collectées et de l’usage que tu en fais. Scraper des données publiques est souvent possible, mais « public » ne veut pas dire « libre d’utilisation ». De nombreuses entreprises utilisent le web scraping pour des analyses de marché ou pour collecter des informations disponibles publiquement sur internet.
Par contre, dès que tu touches à des données personnelles, le RGPD encadre strictement la collecte (base légale valide, minimisation des données), sous peine de sanctions lourdes. Vérifie toujours les conditions d’utilisation du site cible avant de lancer ton bot.
Quels types de données peut-on extraire avec un bot de web scraping ?
Avec un bot de scraping, tu peux collecter :
- Des titres et descriptions de produits.
- Des prix et promotions (utile pour le scraping de prix et la surveillance des tarifs concurrents).
- Des liens internes ou externes.
- Des avis et notes d’utilisateurs.
- Des informations de contact (ce sont des données personnelles, soumises au RGPD).
- Des contenus textuels ou des images de pages web.
Ces données servent souvent à la veille concurrentielle ou à l’analyse de marché.
Comment un site web peut-il détecter mon bot de scraping ?
Les sites repèrent souvent les bots grâce à des comportements anormaux, comme :
- Une vitesse de requêtes trop élevée ou trop régulière.
- Un User-Agent non standard, qui trahit un scraper.
- L’absence de chargement des ressources JavaScript nécessaires à la page.
- Une navigation sans cookies, peu naturelle pour un humain.
Quels sont les défis courants lors de la création d’un bot de web scraping ?
Créer un bot efficace n’est pas toujours simple. Voici les défis les plus fréquents :
- Les structures HTML inconsistantes : un site peut changer ses classes CSS d’un jour à l’autre et ton sélecteur ne retourne plus rien.
- Les données non structurées : tu dois nettoyer et reformater le contenu avant de le stocker.
- La lenteur de chargement des pages, surtout sur les sites dynamiques qui affichent leur contenu via JavaScript.
Y a-t-il des services ou des API de web scraping ?
Oui. Il existe des services qui simplifient le scraping et gèrent les aspects les plus pénibles : proxies, captchas, sites dynamiques. Tu peux aussi utiliser une API de web scraping pour récupérer directement des données structurées. Bright Data fait partie des solutions les plus complètes du marché.
Pour aller plus loin, consulte notre guide sur le web scraping avec Python et découvre des cas d’usage plus avancés.





 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA