を作成する。 ウェブスクレイピング用ボット, 、あなたには必要なのは Python, 、図書館の Requests ページを取得するために、および BeautifulSoup データを抽出するために。.
このガイドでは、機能するスクリプトを次のように組み立てる方法について説明します。 5つのステップ. ウェブスクレイピングボットとは、ウェブサイトからインターネット上のデータを収集する自動化されたプログラムのことです。ページを巡回し、有用な情報を抽出して、後で利用できるよう保存します。.
ボットを起動する前に、ファイルを確認することを忘れないでください robots.txt 対象サイトのどのページを閲覧できるかを確認するため。.

ウェブスクレイピングボットを作成するための要件
まず最初に選ぶべきなのは、君の プログラミング言語. これが、利用可能なツールや導入の容易さを左右する要因となる。.
- Python : ウェブスクレイピングで最も普及している言語です。習得が容易で、データ抽出のための豊富なライブラリエコシステムを備えています。.
- Node.js : 非同期タスクに最適で、非常に成熟したツールが揃っています(Puppeteer, Playwright) JavaScript を使用した動的なサイトをスクレイピングするため。.
- その他の言語 : プロジェクトによっては、以下の方法も検討できる。 ウェブスクレイピングで PHP.
言語を選んだら、適切なものを用意する必要があります 図書館. 実際に仕事をこなしているのは、これらです。環境に応じて、最も役立つものを以下に紹介します。.
為に Python :
- Requests : 送信する HTTPリクエスト ページのコンテンツを取得するには。.
- BeautifulSoup : を解析する HTML また、そこから有用な情報(テキスト、価格、リンク、画像)を抽出することができます。.
- Scrapy : 大規模なリクエスト管理機能を備えた、より野心的なスクレイピングプロジェクト向けの包括的なフレームワーク。.
為に Node.js :
- Axios どこ Fetch : HTTPリクエストを送信するため。.
- Cheerio : これに相当する BeautifulSoup, 、DOMの閲覧や操作に非常に便利です。.
- Puppeteer どこ Playwright : 動的なサイトをスクレイピングするために不可欠です。これらは実際のブラウザを制御し、コードを実行します JavaScript ページの
ウェブスクレイピングボット作成のためのチュートリアル
スクレイピングボットの作成は複雑そうに見えますが、実際にはとても簡単です。以下の手順に従えば 5つのステップ, ウェブ上のデータを収集するための動作するスクリプトが完成します。必ず以下のものをインストールしておいてください Python また、作業を始める前に必要なライブラリを準備してください。.
ステップ1:ターゲット・サイトの分析
何かをコーディングする前に、ページ上のデータがどこにあるかを把握しておく必要があります。このステップは’分析 それが他のすべてを左右する。.
- 開く 対象サイト お使いのブラウザで。.
- 右クリックして、次に以下を選択してください 確認する 気になる項目をクリックしてください。.
- 抽出したいコンテンツを含むHTMLタグ、クラス、またはIDを特定します(例:
製品,タイトル,.価格). - 自分の CSSセレクタ コンソール内で。製品のタイトルがタグで囲まれている場合
<h2>, 、このセレクタをコード内で再利用することになるでしょう。.
ステップ2:HTTPリクエストの送信
君のボットはブラウザのように動作する:それは HTTPリクエスト サーバーに送信され、サーバーはページのHTMLコードを返します。これがこのライブラリの役割です Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # 4xxまたは5xxコードの場合はエラー
html = resp.text
print(html[:500])  # プレビュー
ステップ3:HTMLコンテンツの解析
ページを取得したら、この生のHTMLを操作可能なオブジェクトに変換する必要があります。これが BeautifulSoup, 、HTMLからデータを抽出するための標準的なライブラリ。.
# pip install beautifulsoup4
from bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

products = soup.select(".product")
print(f "製品が見つかりました : {len(products)}")

for p in products[:3]:
    title = p.select_one("h2.title").get_text(strip=True)
    price = p.select_one(".price").get_text(strip=True)
    link = p.select_one("a")["href"]。
    print({"title": title, "price": price, "link": link})
ステップ4:データの抽出
これが最も具体的なステップです:取りに行くのは 正確な情報 見出しや価格、リンクなど。そのついでに、例えば テキストの数量別価格.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
ステップ5:データのバックアップ
結果を紛失しないように、ファイルに保存しておきましょう。最も一般的な2つの形式は、 シーエスブイ (表計算ソフト)と JSON (~に電力を供給するのに最適です) データベース またはAPI)。.
インポート csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
with open("export/products.csv", "w", newline="", encoding="utf-8") as f:
    fields = ["title", "price", "url"].
    writer = csv.DictWriter(f, fieldnames=fields, delimiter=";")
    writer.writeheader()
    writer.writerows(データ)

# JSON
with open("export/products.json", "w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("エクスポート完了!")
これで、完全なスクレイピングボットが完成しました。このボットはリクエストを送信し、HTMLを解析してコンテンツを抽出し、データをCSVまたはJSONファイルに保存します。これは、ほとんどの静的サイトにおけるデータ収集を自動化する上で、強固な基盤となります。.
スクレイピング対策はどのように管理すればよいでしょうか?
ウェブサイトでは、以下の目的のためにいくつかの仕組みを導入しています。 データを保護する ボット対策。これらの保護措置を理解することは、責任を持ってスクレイピングを行い、アカウントのブロックを避けるために不可欠です。.
robots.txt ファイル
the robots.txtファイル サイト上でボットがアクセスできるページとできないページを指定します。注意:これは クロール, 、インデックス登録ではなく、その遵守はクローラーの善意に委ねられている。.
スクレイパーを実行する前に、必ずこのファイルを確認してください。これに従うことでリスクは軽減されますが、それだけではデータ収集が合法になるわけではありません: 使用条件 当サイトのおよび RGPD これらも適用されます。.
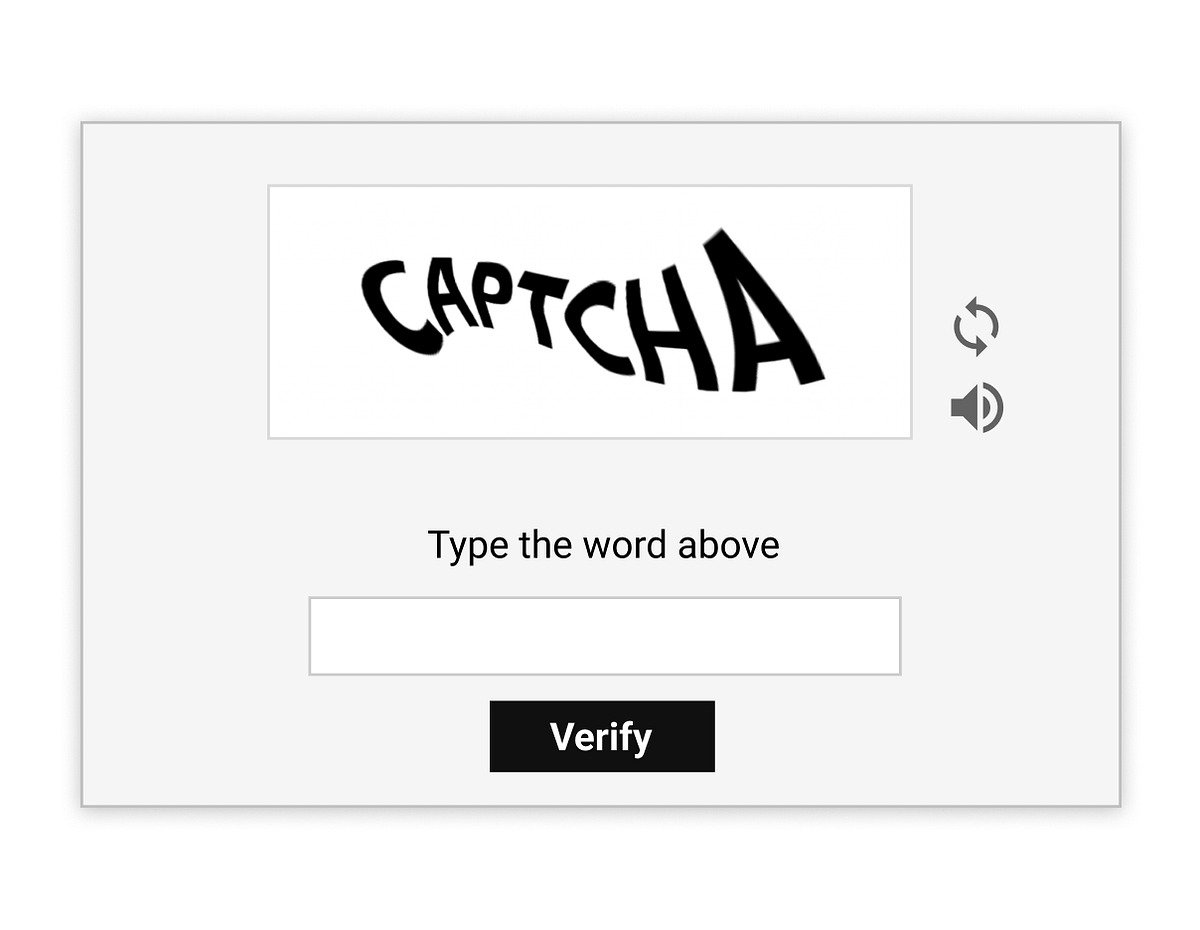
キャプチャ
the キャプチャ ユーザーが確かに人間であることを確認するために使用されます。これは、自動スクレイピングに対する最も効果的な対策の一つです。.
その発生を抑えるには、実際のブラウザをシミュレートする自動化ライブラリを利用するとよい。また、 サードパーティ・サービス キャプチャの解決を専門としており、リクエストの量が増えた際に重宝します。.
IPアドレスによるブロック
一部のサイトでは、同じIPアドレスからのリクエストが多数検出される IPアドレス そしてアクセスを遮断します。これは、ボットが速すぎるペースでデータを収集している典型的な兆候です。.
それを避けるには、 代理人 または1つ VPN IPアドレスを定期的に変更するためです。また、人間による閲覧を模倣するために、各リクエストの間に時間間隔を設けています。.
User-Agentによるブロック
サイトは、特定の識別子によって特定されたボットからのリクエストを拒否することができます。 不審なUser-Agent. 有効なUser-Agentがない場合、多くのサーバーは エラー 403 あるいは空白のページ。.
コツは、あるものを定義することです。 現実的なユーザーエージェント HTTPリクエストに、一般的なブラウザのように見えるように工夫してください。ただし、これが唯一の障壁ではないことに注意してください。クッキーやブラウザのフィンガープリントも重要な要素となります。.
JavaScriptで作成されたサイト
一部のページでは、コンテンツを ジャバスクリプト, そのため、単純なHTTPリクエストではデータを取得することができません。その結果、受け取ったHTMLには、あなたが探している情報が含まれていません。.
その場合は、JavaScriptを実行できるツールを利用してください: Selenium, Playwright どこ Puppeteer. これらは本格的なブラウザとして動作し、ページが完全にレンダリングされた後にデータを取得できるようにします。.
よくある質問
ウェブスクレイピングボットとウェブクローラーの違いは?
| ウェブ・スクレイピング | ウェブクローラー |
|---|---|
| このボットは、主に 正確なデータ : タイトル、価格、商品リンク。HTMLを読み込み、関連する要素を特定して抽出を行い、その後それらを活用します(分析、データベースへの保存、CSVまたはJSONへのエクスポート)。. | クローラーとは、リンクをたどって自動的にページを巡回するプログラムであり、 コンテンツを発見する. その目的は、ウェブをマッピングし、インデックス化することであり、必ずしも正確なデータを抽出することではない。. |
ウェブスクレイピングは合法か?
The ウェブ・スクレイピングの合法性 これは、サイトや収集するデータの種類、そしてそのデータの用途によって異なります。公開されているデータをスクレイピングすることは多くの場合可能ですが、「公開」されているからといって「自由に使用できる」とは限りません。多くの企業がウェブスクレイピングを 市場分析 あるいは、インターネット上で公開されている情報を収集するため。.
一方、もしあなたが 個人データ、 RGPD データの収集を厳格に規制しており(有効な法的根拠、データの最小化)、これに違反した場合は重い制裁が科される。常に以下の点を確認する。 使用条件 ボットを起動する前に、対象サイトの情報を確認してください。.
ウェブスクレイピングボットで抽出できるデータの種類は?
スクレイピングボットを使えば、以下の情報を収集できます:
- の タイトルと説明 製品の
- の 価格とキャンペーン (~に役立つ) 価格スクレイピング および競合他社の価格動向の監視)。.
- の 内部リンクまたは外部リンク.
- の ユーザーのレビューと評価.
- 連絡先情報(これらは個人データであり、GDPRの適用対象となります)。.
- の テキストコンテンツまたは画像 ウェブページ。
これらのデータは、しばしば以下の目的で利用されます。 コンペティティブ・インテリジェンス あるいは市場分析。.
ウェブサイトはどうやって私のスクレイピング・ボットを検知するのか?
ウェブサイトは、以下のような異常な挙動からボットを検知することがよくあります。例えば:
- あ クエリ処理速度 高すぎる、あるいは規則的すぎる。.
- A ユーザーエージェント 非標準的なもので、スクレイパーであることを露呈している。.
- L'JavaScriptリソースが読み込まれていない そのページに必要なもの。.
- あ クッキー不要のブラウジング, 、人間にとっては不自然な。.
ウェブスクレイピングボットを作成する際の一般的な課題とは?
効果的なボットを作成するのは、必ずしも簡単ではありません。以下に、最もよく見られる課題を挙げます:
- The 一貫性のないHTML構造 : ウェブサイトは、ある日突然CSSクラスを変更することがあり、その場合、あなたのセレクタは何も返さなくなってしまう。.
- The 非構造化データ : 保存する前に、内容を整理して再構成する必要があります。.
- The 読み込みが遅い ページ、特にJavaScriptを介してコンテンツを表示する動的なサイトにおいて。.
ウェブスクレイピング用のサービスやAPIはありますか?
はい。 スクレイピングを簡素化し、プロキシ、キャプチャ、動的サイトといった最も手間のかかる部分を処理してくれるサービスがあります。また、 ウェブスクレイピングAPI 構造化データを直接取得するために。. Bright Data 市場で最も包括的なソリューションの一つです。.
さらに詳しく知りたい方は、当社のガイドをご覧ください。 Pythonでウェブスクレイピング そして、より高度な活用例をご覧ください。.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA