创建一个 网络爬虫机器人, 你需要 Python, ,来自图书馆 Requests 以检索页面并 BeautifulSoup 以便从中提取数据。.
本指南将向你展示如何编写一个可运行的脚本,内容包括 5个步骤. 网络爬虫是一种自动程序,用于从网站上收集互联网数据:它会遍历网页,提取有用信息并将其保存下来以备后用。.
在启动你的机器人之前,请记得检查该文件 robots.txt 目标网站,以了解你有权浏览哪些页面。.

创建网络搜刮机器人的要求
首先要选择的是你的 编程语言. 正是它决定了可用的工具以及实施的便捷程度。.
- Python :最受欢迎的网络爬虫编程语言。它易于上手,并拥有非常丰富的库生态系统,可用于提取数据。.
- Node.js : 非常适合异步任务,且拥有非常成熟的工具(Puppeteer, Playwright) 用于抓取基于 JavaScript 的动态网站。.
- 其他语言 : 对于某些项目,你也可以考虑使用 使用……进行网页抓取 PHP.
选定编程语言后,你需要的是合适的 图书馆. 真正发挥作用的正是它们。以下是根据不同环境而定最实用的几种。.
为了 Python :
- Requests : 发送 HTTP 请求 用于获取页面内容。.
- BeautifulSoup : 解析该 HTML 并能从中提取有用的信息(文本、价格、链接、图片)。.
- Scrapy :一个面向更复杂爬虫项目的完整框架,支持大规模请求管理。.
为了 Node.js :
- Axios 在哪里 Fetch :用于发送HTTP请求。.
- Cheerio : 相当于 BeautifulSoup, ,在浏览和操作DOM时非常实用。.
- Puppeteer 在哪里 Playwright : 这是抓取动态网站不可或缺的工具。它们能够控制真实的浏览器并执行代码 JavaScript 的页面。
创建网络搜索机器人教程
创建一个爬虫机器人看似复杂,但实际上非常简单。按照以下步骤操作: 5个步骤, ,你将获得一个可用于从网络上收集数据的脚本。请确保已安装 Python 并在开始之前安装所需的库。.
步骤 1:分析目标地点
在编写任何代码之前,你必须先弄清楚页面上的数据位于何处。这一步骤的’分析 决定着其他一切。.
- 打开 目标网站 在你的浏览器中。.
- 右键单击,然后选择 检查 点击你感兴趣的项目。.
- 找出包含待提取内容的 HTML 标签、类或 ID(例如
.产品,.标题,.价格). - 测试你的 CSS 选择器 在控制台中。如果产品标题位于标签内
<h2>, ,你将在代码中再次使用这个选择器。.
步骤 2:发送 HTTP 请求
你的机器人就像一个浏览器:它会发送一个 HTTP 请求 发送到服务器,服务器再返回该页面的HTML代码。这是该库的作用 Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # 若状态码为 4xx 或 5xx 则报错
html = resp.text
print(html[:500])  # 预览
步骤 3:解析 HTML 内容
获取页面后,你需要将原始HTML转换为可操作的对象。这是 BeautifulSoup, ,这是用于从HTML中提取数据的标准库。.
# pip install beautifulsoup4
从 bs4 导入 BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

products = soup.select(".product")
print(f "找到的产品:{len(产品)}")

for p in products[:3]:
    title = p.select_one("h2.title").get_text(strip=True)
    price = p.select_one(".price").get_text(strip=True)
    link = p.select_one("a")["href"]
    print({"title": title, "price": price, "link": link})
步骤 4:提取数据
这是最实际的一步:去寻找 准确信息 例如标题、价格和链接。你也可以顺便清理它们,例如通过将一个 批量文本价格.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
步骤 5:备份数据
为了避免丢失结果,请将它们保存到文件中。最常见的两种格式是 CSV (电子表格) 和 JSON (非常适合为……供电) 资料库 或一个API)。.
导入 csv、json、pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
with open("export/products.csv", "w", newline="", encoding="utf-8") as f:
    fields = ["title", "price", "url"] 字段
    writer = csv.DictWriter(f, fieldnames=fields, delimiter=";")
    writer.writeheader()
    writer.writerows(data)

# JSON
with open("export/products.json", "w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("Export complete!")
现在你已经拥有了一个功能齐全的爬虫程序:它会发送请求、解析HTML、提取内容,并将数据保存到CSV或JSON文件中。这为在绝大多数静态网站上实现数据采集自动化奠定了坚实的基础。.
如何管理反爬虫保护措施?
网站会采取多种措施来 保护他们的数据 防范机器人。了解这些防护措施对于负责任地进行网页抓取并避免被封禁至关重要。.
robots.txt 文件
这 robots.txt 文件 指定了爬虫在网站上可以或不可以爬取的页面。注意:它控制着 crawl, ,而不是收录,而其执行情况取决于爬虫的意愿。.
在运行爬虫之前,请务必检查此文件。遵守该文件可降低风险,但并不足以确保你的数据采集行为合法: 使用条件 网站和 RGPD 也适用。.
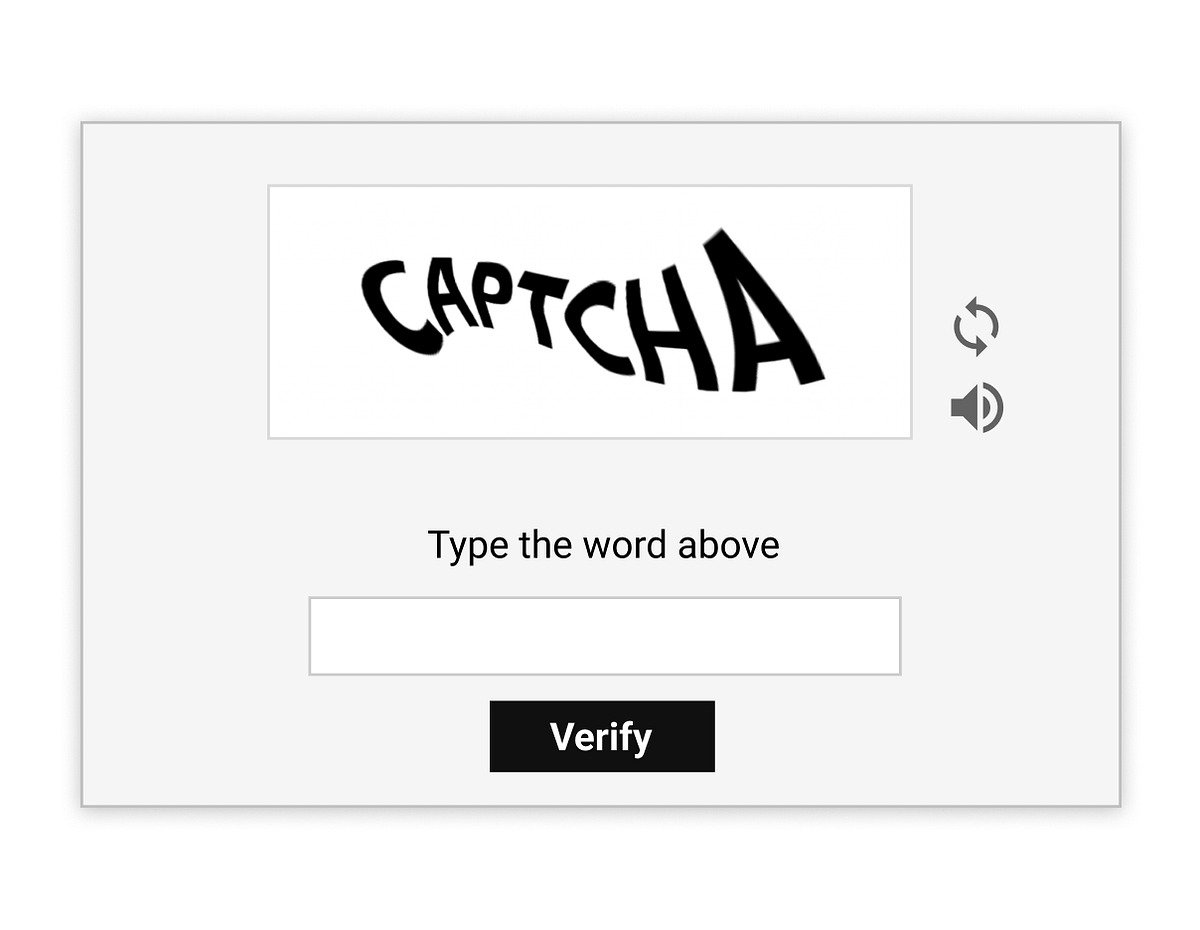
验证码
这 验证码 用于验证用户是否为真人。这是防范自动抓取最有效的防护措施之一。.
为了减少它们的出现,你可以使用能够模拟真实浏览器的自动化库。此外还有一些 第三方服务 专门用于解决验证码,当请求量较大时非常实用。.
按IP地址屏蔽
某些网站检测到大量来自同一来源的请求 IP 地址 并阻止访问。这是机器人抓取速度过快的典型迹象。.
为了避免这种情况,请使用 代理 或一个 虚拟专用网 以便定期更换IP地址。同时在每次请求之间设置延迟,以模拟人类的浏览行为。.
基于 User-Agent 的屏蔽
网站可以拒绝来自被识别为 可疑的用户代理. 如果没有有效的User-Agent,许多服务器会返回一个 403错误 或一个空白页面。.
诀窍在于定义一个 真实的用户代理 在你的HTTP请求中,使其看起来像一个普通的浏览器。不过请注意,这并非唯一的障碍:Cookie和浏览器指纹同样重要。.
使用JavaScript构建的网站
某些页面通过以下方式加载内容: JavaScript, ,这导致普通的HTTP请求无法获取数据。因此,收到的HTML中不包含你所需的信息。.
在这种情况下,请选择能够运行 JavaScript 的工具: Selenium, Playwright 在哪里 Puppeteer. 它们模拟真实的浏览器运行,并在页面完全加载后允许你提取数据。.
常见问题
网络搜刮机器人和网络爬虫有什么区别?
| 网络搜刮 | 网络爬虫 |
|---|---|
| 该机器人专注于 准确的数据 :标题、价格、产品链接。它会解析HTML代码,识别相关元素并将其提取出来,以便后续使用(分析、存储到数据库、导出为CSV或JSON格式)。. | 爬虫是一种通过追踪链接自动遍历网页的程序,用于 发现内容. 其目的是对网络进行地图绘制和索引,而不一定是为了从中提取具体数据。. |
网络搜索合法吗?
这 网络搜索的合法性 这取决于网站、所收集数据的类型以及你的使用目的。抓取公开数据通常是可行的,但«公开»并不意味着«可自由使用»。许多企业利用网络爬虫来 市场分析 或者用于收集互联网上公开可获取的信息。.
不过,一旦你涉及到 个人资料, 这 RGPD 对数据收集实施严格监管(需具备有效的法律依据,并遵循数据最小化原则),否则将面临严厉处罚。请务必核查 使用条件 在启动你的机器人之前,请先访问目标网站。.
网络搜刮机器人可以提取哪些类型的数据?
借助爬虫机器人,你可以收集:
- 的 标题和描述 的产品。
- 的 价格与促销活动 (适用于 价格抓取 以及对竞争对手价格的监控)。.
- 的 内部或外部链接.
- 的 用户评价与评分.
- 联系方式(属于个人数据,受《通用数据保护条例》(GDPR)约束)。.
- 的 文本或图像 网页。
这些数据通常用于 竞争情报 或市场分析。.
网站如何检测到我的刮擦机器人?
网站通常会通过异常行为来识别机器人,例如:
- A 查询速度 过高或过于稳定。.
- 一个 用户代理 非标准格式,这暴露了抓取行为。.
- L'未加载 JavaScript 资源 该页面所需的。.
- A 无 cookie 浏览, ,这对人类来说很不自然。.
创建网络搜刮机器人时常见的挑战是什么?
创建一个高效的聊天机器人并非总是那么简单。以下是最常见的挑战:
- 这 不一致的 HTML 结构 :一个网站可能会在一天之内更改其CSS类,导致你的选择器无法返回任何结果。.
- 这 非结构化数据 : 在存储内容之前,你必须先对其进行清理和重新格式化。.
- 这 加载缓慢 网页,尤其是那些通过JavaScript显示内容的动态网站。.
有没有网络爬虫服务或API?
是的。 有些服务可以简化数据抓取过程,并处理其中最繁琐的部分:代理、验证码、动态网站。你也可以使用一个 网络搜索 API 以便直接检索结构化数据。. Bright Data 是市场上功能最全面的解决方案之一。.
如需进一步了解,请参阅我们的指南: 使用 Python 进行网络搜索 并探索更高级的应用场景。.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA