是的,您可以在 Firefox 上进行刮擦 无编码, 即使范围比 Chrome 浏览器更有限。.
适用于大多数用途、, 网络抓取器是最好的 起点。.
但在开始之前,请注意, 高级功能 (解析、云服务、计划)是收费的,上手需要一点耐心,尤其是分页功能。.
只需单击一下即可完成截图,无需任何设置,, Hexofy 更直接。.
在这篇文章中,我们将介绍适用于以下设备的最佳火狐扩展 网络搜刮优势、功能、目标受众、使用方法……我们为您全面解析!
| 🧩扩展 | ⭐ 亮点 | 🌈 为谁而设? |
|---|---|---|
| 网络抓取器 |
|
初学者和高级用户 |
| Hexofy |
|
初学者和偶尔使用者 |
| UI.Vision RPA |
|
高级用户 |
Firefox网页抓取三大最佳扩展程序
1. Web Scraper (webscraper.io)

非常受欢迎的 Firefox上的网页抓取Web Scraper 是一款功能强大的扩展程序。它能够 创建抓取计划 (“网站地图”)用于浏览网站并提取数据。
你也可以 配置选择器 用于抓取特定元素(标题、图片、价格等)。
👉 主要特点 :
- 📌 点击式界面
- 📌 支持动态网站(JavaScript)和分页功能
- 📌 通过选择器实现更佳的页面浏览体验
- 📌 将数据导出为 CSV、Excel 和 JSON 格式
- 📌 免费扩展程序,仅限本地使用
很高兴知道 :
当地对 网络抓取器 该工具免费使用,对于大多数小型项目已足够。不过,高级功能(云端存储、排程、部分导出选项)则需要付费订阅。此外,您可能需要一些时间来适应,尤其是分页功能。.
👉 为谁而设?
Web Scraper非常适合 初学者 ET 至 经验丰富的刮板.
该扩展主要面向 小型项目,但您可以在Firefox浏览器上使用它来抓取任何网页。
2. Hexofy(hexofy.com)
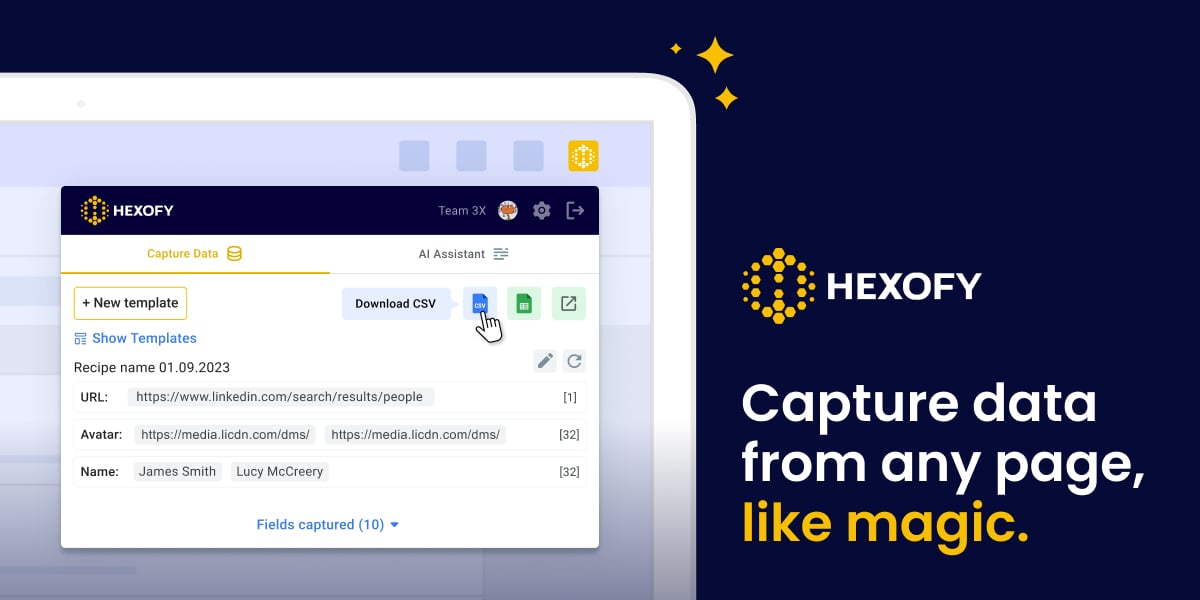
Hexofy 如果您需要一个 简单快捷 用于在Firefox上进行网页抓取。
与其配置复杂的选择器,该扩展更注重效率。它能够将网页转换为电子表格。 只需点击一下.
您只需访问网页,点击扩展程序即可。Hexofy将为您自动收集所有数据!
👉 主要特点 :
- 📌 点击式界面
- 📌 内置人工智能助手(GPT)
- 📌 简单配置,快速提取信息
- 📌 可直接将数据导出至Google表格
👉 为谁而设?
Hexofy是理想的选择,如果 您刚开始接触网页抓取. .该扩展还能吸引那些偶尔需要无需代码或复杂配置即可进行废品处理的用户。.
3.UI.Vision RPA
如果您的需求超出了一次性刮擦的范围,UI.Vision RPA 是您的不二之选。.
开放源码和免费,它结合了 数据提取 和 任务自动化 (如 Selenium IDE),具有可视化识别功能。作为对其强大功能的回报,学习曲线可能会更长。这是一个用于经常性项目的工具,而不是快速点击的工具。.
👉 主要特点 :
- 📌 Selenium IDE 型高级自动化
- 视觉识别和 OCR
- 📌 重复数据提取
- 📌 开源和免费
- 📌 本地处理的数据(保密性)
👉 为谁而设?
UI.Vision RPA 的目标用户是希望实现以下功能的高级用户 在火狐浏览器上自动重复提取. .如果您刚开始使用,Web Scraper 或 Hexofy 会更方便。.
如何使用Firefox配合Web Scraper进行网页抓取?
以下是使用方法 网络抓取器 使 在Firefox上进行网页抓取我们将逐步为您说明:
步骤 1:安装和配置
- 🔹 请通过此链接访问 Firefox 扩展商店:https://addons.mozilla.org
- 🔹 搜索 Web Scraper(由 webscraper.io 开发)。
- 🔹 点击 “添加到 Firefox”,然后确认安装。
安装完成后,浏览器工具栏中将出现一个新的Web Scraper图标。
第二步:创建网站地图
网站地图是一个定义需要抓取哪些页面以及提取哪些元素的计划。它是所有使用网页抓取工具项目的基石。创建网站地图的步骤如下:
- 🔹 在浏览器中点击 Web Scraper 图标,然后点击 「开放站点地图」 ».
- 🔹 然后点击 " 创建新的网站地图 ».
- 🔹 为您的网站地图命名。
- 🔹 输入起始页面的URL(您想要抓取的页面)。
- 🔹 点击 " 创建网站地图 ».
💡 网站地图随后将包含您为其定义的所有元素(选择器)。 提取特定数据。
步骤3:元素选择(选择器)
下一步是告诉网页抓取工具 提取哪些数据。 这很简单:
- 🔹 点击 「选择器」 在您的网站地图中。
- 🔹 添加一个 新选择器 (例如:“标题”、“价格”、“描述”)。
- 🔹 借助可视化工具,您可直接点击页面中的元素(Web Scraper将为此打开一个专用界面)。
- 🔹 然后选择 要提取的数据类型 : 文本、链接、图片…
- 🔹 然后对所有您想要恢复的项目重复此操作。
请放心,界面是 直观的即使没有技术知识,您也能轻松选中所有感兴趣的元素。
步骤4:启动抓取
当您的网站地图准备就绪且选择器定义完成后,您终于可以 启动抓取。 去做这个 :
- 🔹 点击您的网站地图,然后点击 刮擦.
- 🔹 将打开一个新窗口:这是 Web Scraper 的内部浏览器。
- 🔹 然后点击 「开始抓取」.
在新窗口中,您可以 跟踪抓取进度 实时显示访问过的页面和收集的数据。该窗口还会显示错误和失败的页面。
步骤5:导出数据
抓取完成后,您即可获取数据。
- 🔹 返回 Web Scraper 的主菜单。
- 🔹 然后点击 「浏览数据」 查看结果预览。
- 🔹 点击选择格式 「将数据导出为CSV格式」 在哪里 「将数据导出为JSON格式」.
随后,您可以根据需要在电子表格、数据库或脚本中使用这些文件。
使用Firefox扩展进行网页抓取有哪些替代方案?
这 网络搜刮扩展 主要适用于小型项目。但请放心,还有更强大的替代方案可供选择。 在Firefox上进行批量网页抓取:
网络爬虫工具
这 网络搜刮工具 是专门的平台,提供完整的基础设施和集成服务。您将能够快速高效地批量抓取数据。
👉 亮数据 Bright Data是目前最受欢迎且高效的网络爬虫工具之一。该平台提供网络爬虫所需的所有核心功能:数据采集、代理管理、反封锁系统……Bright Data的每个设计细节都旨在为您简化操作流程!
Vous pouvez consulter notre 全面评测 Bright Data 详情请见。
编程软件和库
您正在寻找一种用于 复杂项目 高度 个性化 ? 使用 软件 和 编程库 是最佳选择。
他们提供更多 权力 和 灵活性 相对于网页抓取扩展程序和工具而言。
以下是最佳选择:
- 📌 Python及其库
Python 是网络爬虫领域最受欢迎的语言之一。这得益于诸如 美丽汤, 废料 或者 硒它们能够以结构化的方式提取信息、实现导航自动化,甚至能够 管理动态页面.
这 使用 Python 进行网络搜索 使您能够完全掌控数据收集过程。
- 📌 Node.js:Cheerio 和 Puppeteer
借助 Node.js,您可以找到强大的工具来实现 JavaScript 中的网络搜刮.
加油 允许操作 HTML内容,类似于jQuery的方式。 傀儡师它用于像真正的浏览器一样与网页交互,包括用于 JavaScript 渲染.
- 📌 PHP
PHP也可用于网页抓取,特别是配合以下工具使用: cURL 或 DOMDocument. 即使它不是完成这项任务最常用的编程语言, 使用 PHP 进行网络搜刮 仍是一个可行的选择 基本需求.
常见问题
什么是网络爬虫?
网络搜刮是一种技术,可让您 自动获取数据 通过脚本或软件在网站上自动抓取信息。这就像一个机器人代替您访问网页,并复制您感兴趣的所有信息(标题、价格、描述等)。
例如,与其手动复制电子商务网站上的所有产品,不如使用一个工具或一个 网络搜刮扩展 您可以’只需点击几下即可提取数据.
网络搜索合法吗?
这 网络搜索的合法性 这是一个复杂的问题,取决于多个因素:
- 📌 网站使用条款
- 📌 提取的数据类型
- 📌 地方法律
一般来说 搜索公共数据 并非非法,但 受保护数据的抓取 或私人信息可能被泄露。使用Firefox 用于网页抓取的扩展程序 也受相同规则的约束。
网页抓取扩展功能的价格是多少?
2026年7月记录的费率,可能会有变动。.
| 🦊 Firefox 扩展 | 🎁 免费增值计划? | 🏷️ 高级计划 |
|---|---|---|
| 网络抓取器 | ✅ 是(免费本地版本) | 每月50欧元起(云端) |
| Hexofy | ✅ 是(功能受限的免费版) | 每月7 $起(年度订阅) |
| UI.Vision RPA | ✅ 是(完全免费版本) | 299 起 $(一次性购买) |
Chrome 浏览器中有哪些最佳的网页抓取扩展程序?
您使用的是谷歌浏览器而非火狐浏览器?请放心,存在... 网络搜刮扩展 使 在谷歌浏览器上使用网页抓取工具.
其中包括 刮刀 在哪里 即时数据抓取器 这些非常受欢迎。想了解更多吗?您可以查阅我们关于 Chrome的网页抓取扩展程序.
简而言之,以下是 Firefox 的 3 个网络搜刮扩展的简要介绍:
| 您的要求 | 🛠️ 推荐的工具 |
|---|---|
| 快速捕捉页面 | Hexofy |
| 抓取完整的电子商务网站 | 网络抓取器 |
| 每周启动相同的刮擦 | UI.Vision RPA |
现在您已经了解了 网络搜刮扩展 对于Firefox,您打算使用哪一款?欢迎在评论区分享您的使用体验或提出问题。.









 简体中文