For at oprette en webscraping-bot, du skal bruge Python, fra biblioteket Requests for at hente siderne og BeautifulSoup for at udtrække dataene.
Denne vejledning viser dig, hvordan du sammensætter et velfungerende script i 5 trin. En web-scraping-bot er et automatiseret program, der indsamler data på internettet fra hjemmesider: Den gennemgår siderne, udtrækker de relevante oplysninger og gemmer dem til senere brug.
Inden du starter din bot, skal du huske at tjekke filen robots.txt på målsiden for at finde ud af, hvilke sider du har adgang til.

Krav til oprettelse af en webscraping-bot
Det første, du skal vælge, er din programmeringssprog. Det er netop dette, der afgør, hvilke værktøjer der er til rådighed, og hvor nemt det er at sætte dem i værk.
- Python : det mest populære sprog til webscraping. Det er nemt at lære og har et meget omfattende udvalg af biblioteker til dataudtræk.
- Node.js : ideel til asynkrone opgaver, med meget veludviklede værktøjer (Puppeteer, Playwright) til at scrape dynamiske hjemmesider, der er baseret på JavaScript.
- Andre sprog : Ved visse projekter kan du også henvende dig til webscraping med PHP.
Når du har valgt sproget, skal du have de rigtige Biblioteker. Det er dem, der virkelig gør arbejdet. Her er de mest nyttige afhængigt af omgivelserne.
Til Python :
- Requests : sender HTTP-anmodninger for at hente indholdet fra en side.
- BeautifulSoup : analyserer HTML og gør det muligt at udtrække de relevante oplysninger (tekst, priser, links, billeder).
- Scrapy : et komplet framework til de mere ambitiøse scraping-projekter, med håndtering af forespørgsler i stor skala.
Til Node.js :
- Axios Hvor Fetch : til at sende HTTP-anmodninger.
- Cheerio : svarende til BeautifulSoup, hvilket er meget praktisk til at gennemse og bearbejde DOM.
- Puppeteer Hvor Playwright : uundværlige til at scrape dynamiske hjemmesider. De styrer en rigtig browser og udfører koden JavaScript af siden.
Vejledning i at lave en webscraping-bot
Det kan virke kompliceret at oprette en scraping-bot, men i praksis er det meget overkommeligt. Ved at følge disse 5 trin, så får du et fungerende script til at indsamle data på nettet. Sørg for, at du har installeret Python og de nødvendige biblioteker, inden du går i gang.
Trin 1: Analyser målstedet
Inden du begynder at programmere, skal du vide, hvor dataene befinder sig på siden. Dette trin i’analyse bestemmer alt det øvrige.
- Åbn den målwebsted i din browser.
- Højreklik, og vælg derefter Kontrollere på det emne, der interesserer dig.
- Find de HTML-tags, klasser eller ID’er, der indeholder det indhold, der skal udtrækkes (for eksempel
.produkt,.titel,.pris). - Prøv dine CSS-selektorer i konsollen. Hvis produktnavnene er indeholdt i tags
<h2>, vil du genbruge denne selektor i din kode.
Trin 2: Afsendelse af en HTTP-anmodning
Din bot fungerer som en browser: den sender en HTTP-anmodning til serveren, som returnerer sidens HTML-kode. Det er bibliotekets opgave Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # fejl, hvis kode 4xx eller 5xx
html = resp.text
print(html[:500])  # oversigt
Trin 3: Parsing af HTML-indhold
Når siden er hentet, skal du omdanne denne rå HTML til et objekt, der kan bearbejdes. Det er opgaven for BeautifulSoup, standardbiblioteket til udtrækning af data fra HTML.
# pip install beautifulsoup4
fra bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

produkter = soup.select(".product")
print(f "Produkter fundet: {len(products)}")

for p i produkter[:3]:
    title = p.select_one("h2.title").get_text(strip=True)
    price = p.select_one(".price").get_text(strip=True)
    link = p.select_one("a")["href"]
    print({"title": title, "price": price, "link": link})
Trin 4: Udtræk data
Det er det mest konkrete skridt: at hente præcise oplysninger såsom overskrifter, priser og links. Du kan også rydde op i dem i samme omgang, for eksempel ved at konvertere en pris pr. antal tekster.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Trin 5: Sikkerhedskopier data
For ikke at miste dine resultater skal du gemme dem i en fil. De to mest almindelige formater er CSV (regneark) og JSON (ideel til at forsyne en database eller et API).
import csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
med open("export/products.csv", "w", newline="", encoding="utf-8") som f:
    fields = ["title", "price", "url"]
    writer = csv.DictWriter(f, fieldnames=fields, delimiter=";")
    writer.writeheader()
    writer.writerows(data)

# JSON
med open("export/products.json", "w", encoding="utf-8") som f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("Eksport fuldført!")
Du har nu en komplet scraping-bot: den sender en forespørgsel, analyserer HTML-koden, udtrækker indholdet og gemmer dataene i en CSV- eller JSON-fil. Det er et solidt grundlag for at automatisere dataindsamlingen på de fleste statiske hjemmesider.
Hvordan håndteres beskyttelse mod scraping?
Hjemmesiderne indfører en række mekanismer for at beskytte deres data mod robotter. Det er afgørende at forstå disse beskyttelsesforanstaltninger for at kunne udføre web-scraping på en ansvarlig måde og undgå at blive blokeret.
Filen robots.txt
det robots.txt-filen angiver, hvilke sider en bot må eller ikke må gennemgå på et websted. Bemærk: Den styrer crawl, ikke indeksering, og overholdelsen af dette afhænger af søgerobotternes velvilje.
Tjek altid denne fil, før du kører din scraper. At følge den mindsker risikoen, men er ikke nok til at gøre din dataindsamling lovlig: de Betingelser for brug på hjemmesiden og RGPD gælder også.
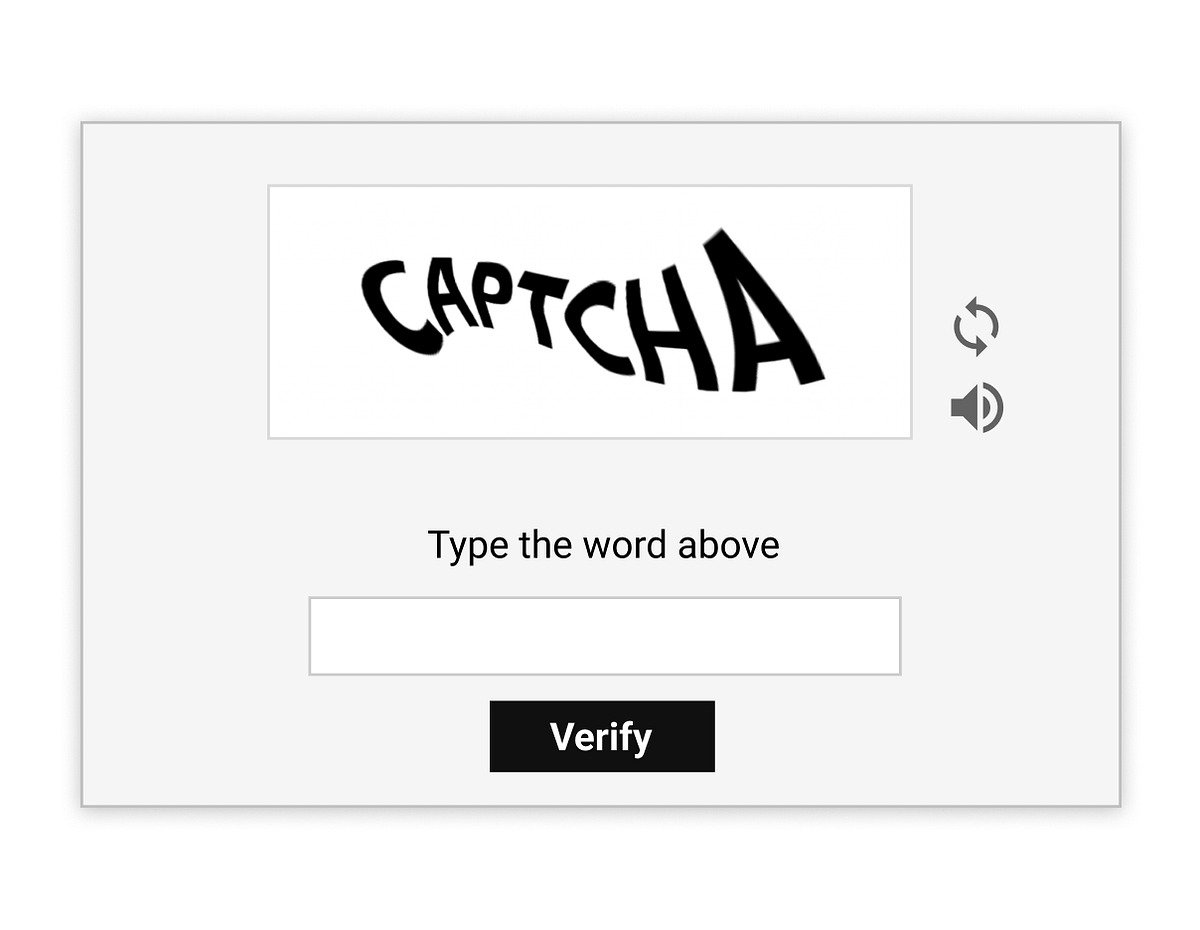
Captcha'er
det captcha bruges til at kontrollere, at brugeren rent faktisk er et menneske. Det er en af de mest effektive beskyttelsesforanstaltninger mod automatisk scraping.
For at begrænse deres forekomst kan du bruge automatiseringsbiblioteker, der simulerer en rigtig browser. Der findes også nogle Tredjepartstjenester der er specialiseret i at løse captchaer, hvilket er praktisk, når antallet af forespørgsler bliver stort.
Blokeringer baseret på IP-adresse
Nogle websteder registrerer et stort antal forespørgsler fra den samme IP-adresse og blokerer adgangen. Det er det typiske tegn på, at en bot indsamler data for hurtigt.
For at undgå det skal du bruge fuldmagter eller en vpn for regelmæssigt at skifte IP-adresse. Indsæt også en forsinkelse mellem hver forespørgsel for at efterligne menneskelig browsing.
Blokeringer baseret på User-Agent
Websteder kan afvise forespørgsler fra bots, der identificeres ved hjælp af en Mistænkelig User-Agent. Uden en gyldig User-Agent returnerer mange servere en Fejl 403 eller en tom side.
Tricket er at definere en Realistisk brugeragent i dine HTTP-forespørgsler, så de ligner en almindelig browser. Du skal dog være opmærksom på, at dette ikke er den eneste hindring: cookies og browserens fingeraftryk spiller også en rolle.
Websteder i JavaScript
Nogle sider indlæser deres indhold via JavaScript, hvilket forhindrer almindelige HTTP-forespørgsler i at hente dataene. Den modtagne HTML-kode indeholder derfor ikke de oplysninger, du leder efter.
I så fald bør du vælge værktøjer, der kan køre JavaScript: Selenium, Playwright Hvor Puppeteer. De styrer en rigtig browser og giver dig mulighed for at hente dataene, når siden er fuldt indlæst.
Ofte stillede spørgsmål
Hvad er forskellen på en webscraping-bot og en webcrawler?
| Skrabning på nettet | Web-crawler |
|---|---|
| Botten fokuserer på nøjagtige data : titler, priser, produktlinks. Den læser HTML-koden, identificerer de relevante elementer og udtrækker dem til senere brug (analyse, lagring i en database, eksport til CSV eller JSON). | Crawleren er et program, der automatisk gennemgår sider ved at følge linkene for at Opdag indhold. Formålet er at kortlægge og indeksere internettet, ikke nødvendigvis at udtrække specifikke data derfra. |
Er webscraping lovligt?
Det Lovligheden af webscraping afhænger af hjemmesiden, hvilken type data der indsamles, og hvordan du bruger dem. Det er ofte muligt at scrape offentlige data, men «offentlige» betyder ikke nødvendigvis «frie til brug». Mange virksomheder bruger webscraping til markedsanalyser eller for at indsamle oplysninger, der er offentligt tilgængelige på internettet.
Men så snart du rører ved personlig data, det RGPD regulerer indsamlingen strengt (gyldigt retsgrundlag, dataminimering), og der kan pålægges strenge sanktioner ved overtrædelse. Kontroller altid Betingelser for brug på målwebstedet, før du starter din bot.
Hvilke typer data kan udvindes med en webscraping-bot?
Med en scraping-bot kan du indsamle:
- Af titler og beskrivelser af produkter.
- Af priser og tilbud (nyttigt til prisscraping og overvågning af konkurrenternes priser).
- Af interne eller eksterne links.
- Af anmeldelser og brugeranmeldelser.
- Kontaktoplysninger (dette er personoplysninger, der er omfattet af GDPR).
- Af tekstindhold eller billeder websider.
Disse data bruges ofte til Konkurrencemæssig intelligens eller markedsanalyse.
Hvordan kan en hjemmeside opdage min scraping-bot?
Websteder opdager ofte bots på baggrund af unormalt adfærd, såsom:
- EN forespørgselshastighed for høj eller for regelmæssig.
- EN Brugeragent ikke-standard, hvilket afslører en scraper.
- L'JavaScript-ressourcerne indlæses ikke der er nødvendige for siden.
- EN Cookie-fri browsing, hvilket er unaturligt for et menneske.
Hvad er de mest almindelige udfordringer, når man laver en webscraping-bot?
Det er ikke altid nemt at udvikle en effektiv bot. Her er de mest almindelige udfordringer:
- Det inkonsistente HTML-strukturer : Et websted kan ændre sine CSS-klasser fra den ene dag til den anden, og så returnerer din selektor ikke længere noget.
- Det ustrukturerede data : Du skal rense og omformatere indholdet, før du gemmer det.
- Det langsom indlæsning sider, især på dynamiske websteder, der viser deres indhold via JavaScript.
Findes der tjenester eller API’er til webscraping?
Ja. Der findes tjenester, der gør scraping nemmere og tager sig af de mest besværlige aspekter: proxyservere, captchaer og dynamiske hjemmesider. Du kan også bruge en API til webscraping for direkte at hente strukturerede data. Bright Data er en af markedets mest omfattende løsninger.
Hvis du vil vide mere, kan du læse vores guide om web scraping med Python og opdag mere avancerede anvendelsesmuligheder.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA