AWS giver dig mulighed for at udføre webscraping uden at skulle administrere en server.
Hvis du vil have en let og automatiseret scraper, Lambda + S3 er rigeligt.
Hvis der er millioner af sider, der skal behandles samtidigt, skal du gå over til Fargate Hvor EC2 med Scrapy.
Hvilken rolle spiller AWS inden for webscraping?
det web scraping tillader automatisk hente data på hjemmesider for at analysere eller genbruge dem. Administrere millioner sider, at undgå nedbrud og sikre driftssikkerheden kan hurtigt blive en rigtig teknisk hovedpine, især hvis du selv skal vedligeholde din infrastruktur.
Det er her, at’AWS (Amazon Web Services) kommer ind i billedet. Denne platform Amazon-skyen forenkler scraping ved at automatisere serveradministrationen og understøtte skalérbarhed, tilgængelighed og sikkerhed på dine vegne, selv med enorme datamængder.
Her er grundene til, at AWS er en ideel løsning til at sætte en scraper i gang:
- Skalerbarhed : Platformen skalerer automatisk op for at kunne håndtere millioner af forespørgsler uden afbrydelser.
- Pålidelighed : AWS’ managed services mindsker risikoen for nedbrud og sikrer uafbrudt drift.
- Omkostningsstyring : med modellen pay-as-you-go, du betaler kun for det, du rent faktisk forbruger.
- Sikkerhed : AWS iværksætter strenge foranstaltninger for at beskytte dine lagrede og overførte data.
Hvilke relevante tjenester tilbyder AWS?
Amazons cloud tilbyder et bredt udvalg af tjenester, der er tilpasset alle behov inden for webscraping. Her er de vigtigste, man bør kende til, opdelt efter anvendelsesområde.
Beregningen: hvor kører din scraper?
- AWS Lambda : ideel til små opgaver og lejlighedsvis scraping, uden at man skal administrere en server. Det er den tilgang serverløs par excellence.
- Amazon EC2 : perfekt til lange eller ressourcekrævende processer. Du lejer en virtuel maskine og du har fuld kontrol over hele opsætningen.
Lagring: hvor du gemmer dine data
- Amazon S3 : til opbevaring af rådata, HTML-filer eller resultater fra web-scraping i en spand. Hver fil identificeres ved hjælp af en nøgle unik i bucket'en S3, hvilket gør det lettere at få adgang til og organisere de indsamlede data.
- Amazon DynamoDB : for de strukturerede data som kræver meget hurtig læsning og skrivning.
Koordinering: for at sikre et sammenhængende forløb
- AWS Step Functions : til styring af komplekse arbejdsgange, hvor flere funktioner skal udføres i en bestemt rækkefølge.
De supplerende tjenester
- Amazon SQS : til at styre køerne af forespørgsler og udjævne databehandlingen i stor skala.
- AWS IAM : for at administrere adgangen og definere en politik angiv præcist, så din scraper kun har de rettigheder, den rent faktisk har brug for.
I praksis kombinerer et simpelt projekt ofte Lambda + S3 + IAM. Til omfattende scraping skal du tilføje EC2, SQS og DynamoDB alt efter dine behov.
Hvordan bygger man en serverløs scraper med AWS Lambda?
Med AWS Lambda, du behøver ikke at administrere serveren: AWS tager sig af hele infrastrukturen, lige fra skalérbarhed til vedligeholdelse. Du skal blot angive din kode og konfigurationen. Her er en trin-for-trin-vejledning til, hvordan du opretter din første serverløse scraper.
1. Grundlæggende arkitektur for en serverløs scraper
Inden du begynder at programmere, skal du danne dig et overblik over, hvordan de forskellige AWS-tjenester vil fungere sammen. Der er tre valg, der er afgørende for din arkitektur.
- Vælg udløseren
Det er det element, der bestemmer, hvornår din kode skal udføres. Du kan vælge mellem CloudWatch og EventBridge.
- Vælg computeren
Det er her, din kode kører i skyen. Vælg Lambda til korte og sporadiske opgaver. Gå videre til EC2 Hvor Fargate hvis arbejdet er langt eller tungt.
- Vælg lagerplads
Brug S3 til JSON-, CSV- eller råfiler. Vælg DynamoDB hvis du har brug for hurtig og struktureret adgang til dine data.
Kort sagt: Triggeren aktiverer Lambda, Lambda udfører scraping, og dataene ender i S3-bucket.
2. Forberedelse af miljøet
Inden du begynder at programmere, skal du give AWS de nødvendige tilladelser og oprette et lagringsområde.
- Opret en rolle IAM (rettigheder)
- Gå til konsollen AWS > IAM > Roller.
- Opretter en rolle, der er dedikeret til Lambda.
- Giv ham to vigtige tilladelser:
AWSLambdaBasicExecutionRolefor at sende logfilerne til CloudWatch, samt en S3-tilladelse til at skrive filer i din bucket.
- Opret en bucket S3 (lagring af resultater)
- Gå til konsollen AWS > S3.
- Opret en bucket og gem dem sikkerhedsindstillinger aktiveret.
Lambda har nu tilladelse til at skrive til din S3-bucket, og du har nu et sted, hvor du kan gemme dine data.
3. Python-koden til AWS Lambda
Skriv et scraper i Python sammen med biblioteket Requests. Dette script henter en webside og gemmer resultatet i S3-bucket.
- Eksempel på enkel kode (med requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # URL, der skal scrapes (her et simpelt eksempel)
    url = "https://example.com"
    response = requests.get(url)

 # Kontrol af status
    if response.status_code == 200:
 # Filnavn (med tidsstempel for at undgå kollisioner)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Uploading til S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # skal defineres i dine Lambda-miljøvariabler
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"Side gemt i {filename}")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("Fejl under scraping")
 }
anmodninger henter indholdet fra websiden. boto3 er det officielle bibliotek til kommunikation med AWS. Hvis du vil gå mere i dybden med API'erne, kan du tilpasse netop dette skema til eksterne endpoints.
- Håndtering af afhængigheder (requests Hvor Scrapy)
Lambda leverer ikke disse biblioteker som standard. Du har to muligheder.
Mulighed 1: Oprette en pakke ZIP
- Opret en mappe på din computer:
mkdir package && cd package pip install requests -t .- Upload din fil
lambda_function.pyi dette dossier. - Komprimér det hele til
.zipog upload den til Lambda.
Mulighed 2: Brug Lambda Layers
- Opret et Lambda-lag, der indeholder Requests (eller Scrapy til mere avanceret scraping).
- Knyt denne lag til din Lambda-funktion.
Fordel : Det er mere overskueligt, hvis du genbruger de samme afhængigheder i flere funktioner.
4. Implementering og test
Nu skal du bare lægge din kode online og kontrollere, at den virker.
- Upload koden til Lambda
- Log ind på AWS-konsollen, og gå til Lambda-tjenesten.
- Klik på Opret funktion, og vælg derefter Forfatter fra bunden.
- Giv din funktion et navn (eksempel:
scraper-lambda) og vælg den Python 3.12-kørselstid (eller den version, du bruger). - Knyt den tidligere oprettede IAM-rolle til S3- og CloudWatch-tilladelserne.
- I fanen Kodet, vælg Upload fra > .zip-fil og importer din fil
lambda_package.zip. - Tilføj en miljøvariabel:
BUCKET_NAME= navnet på din S3-bucket. - Klik på Gem for at gemme konfigurationen af din Lambda-funktion.
- Test funktionen
- I din Lambda-funktion skal du klikke på Prøve.
- Opret en ny testbegivenhed med en lille JSON-fil, for eksempel:
{ "url": "https://example.com" }- Klik på Gemog så videre Prøve for at udføre funktionen.
- I fanen Logs, tjek status: du bør kunne se en kode 200 hvis alt er gået godt.
- Gå ind i din S3-bucket: Der vises en fil
scraping_xxxx.html.
Hvad er løsningerne til web scraping i stor skala?
For at indsamle millioner sider, skal du have en solid infrastruktur. Ideen med AWS er at fordele belastningen og køre flere scrapers sideløbende.
1. Brug Scrapy og AWS Fargate/EC2
Scrapy er et Python-framework, der er perfekt til komplekse projekter. Som standard kører din scraper på din egen maskine, hvilket hurtigt sætter begrænsninger for datamængden. For at skalere op har du to muligheder på AWS.
AWS Fargate Kør din Scrapy-scraper i Docker-containere, uden nogensinde at skulle administrere en server. Det er den ideelle løsning til serverløs og skalerbar scraping. Processen består af tre trin:
- Du opretter din Scrapy-scraper.
- Du lægger det i en beholder Docker.
- Du implementerer denne container med Fargate så det kan køre automatisk i stor skala.
Amazon EC2 er alternativet, hvis du ønsker større kontrol over dit miljø. Du installerer selv Python og Scrapy på en instans og automatiserer derefter kørslen. En instans t3.micro svarer til ca. 7,59 $/måned som on-demand på us-east-1.
I begge tilfælde sendes de udtrukne data til en S3-bucket, som samler alle dine scrapede filer ét sted.
2. Distribueret scraping-arkitektur
For virkelig at kunne køre parallelt, skal du basere dig på Amazon SQS (Simple Queue Service). Princippet er simpelt: Du lægger alle dine URL’er ind i SQS, og flere funktioner Lambda eller flere containere (på EC2 eller Fargate) henter disse URL'er parallelt for at starte scraping. Hver Lambda-funktion læser en URL fra køen, udfører scraping og gemmer resultatet i en S3-bucket med en unik nøgle.
Denne arkitektur giver dig mulighed for at fordele arbejdet og at gennemgå tusindvis af sider samtidigt. Det er grundlaget for en effektiv, distribueret scraper i AWS-skyen. For sider med dynamisk indhold, der indlæses via Ajax, skal du tilpasse din fremgangsmåde, så dataene indsamles efter rendering.
3. Administrer proxyer og blokerede anmodninger
Mange hjemmesider blokerer scrapers ved at registrere et unormalt stort antal forespørgsler eller ved at filtrere visse IP-adresser. Der findes to måder at omgå denne blokering på:
- Det IP-adresserotation, via AWS eller specialiserede tjenester.
- Brug af tredjepartsproxyer som Lyse data Hvor ScrapingBee, som automatisk styrer hjulvinklen og antiblokeringssystemet.
Hvad er løsningerne på almindelige problemer med webscraping med AWS?
Der er altid forhindringer på vejen, når man arbejder med webscraping: netværksfejl, blokeringer, uforudsete omkostninger. Den gode nyhed er, at AWS allerede tilbyder tjenester, der hurtigt kan diagnosticere og løse disse problemer.
Analysere logfiler med Amazon CloudWatch
Når en Lambda-funktion eller en EC2-instans går ned, er det svært at finde ud af, hvor fejlen stammer fra, hvis man ikke har indsigt i udførelsen. Med Amazon CloudWatch, alle logfiler er samlet ét sted og kan ses fra konsollen. Her kan du hurtigt få øje på de hyppigste fejl:
- Forsinkelser : Det tog for lang tid at få svar på forespørgslen.
- Fejl 403 : Hjemmesiden blokerer din scraper.
- Fejl 429 : Der er sendt for mange forespørgsler på én gang.
- Mangel på hukommelse eller Manglende Python-afhængigheder i Lambda-koden.
Konfigurer CloudWatch-advarsler for automatisk at blive underrettet, så snart en fejl opstår for ofte.
Håndtering af fejl i forespørgsler
En scraper kan gå helt ned, hvis blot én forespørgsel mislykkes. Det grundlæggende: Indsæt dine Python-kald i try…except for at forhindre, at programmet går ned pludseligt på grund af en enkelt fejl.
Derefter skal du indføre nogle strategier for gentagne forsøg :
- Prøv igen efter et kort stykke tid, og forlæng derefter gradvist ventetiden (eksponentiel tilbagegang).
- Skifter mellem flere fuldmagter hvis en IP-adresse bliver blokeret.
- Juster hyppigheden af dine forespørgsler for at holde en lav profil og undgå at vække opmærksomhed.
Oversigt over omkostninger
En dårligt optimeret scraper kan generere tusindvis af Lambda-kald eller lade en stor EC2-instans køre unødigt. For at bevare kontrollen skal du bruge AWS Billing og overvåger forbruget for hver enkelt tjeneste.
Her er nogle størrelsesordener, så du kan danne dig et overblik:
- Lambda : om 0,20 $ pr. million forespørgsler, plus den fakturerede køretid i Go-sekunder. Den gratis niveau dækker 1 million gratis forespørgsler og 400 000 Go-sekunder hver måned, på permanent basis. De udtrukne data gemmes i en S3-bucket ; hold øje med den lagrede mængde, da S3 også opkræver betaling for den mængde data, der opbevares.
- EC2 t3.micro : omkring 7,59 $/måned på On-Demand på us-east-1, langt færre med Spot-instanser.
Hvad angår optimering, er her et par enkle tips:
- For Lambda: Reducer den tildelte hukommelse og begræns kørselstiden (Højst 15 minutter ved opkald, hvorefter funktionen automatisk stopper, og du skal skifte til EC2 eller Fargate).
- For EC2: Vælg en instans, der passer til din belastning, eller skift til Spot-instanser (billigere, men kan afbrydes når som helst).
- Aktiverer AWS-budgetadvarsler for at få besked, før du overskrider en grænse, som du selv fastsætter.
Ofte stillede spørgsmål
Er webscraping med AWS lovligt?
Det afhænger af din konkrete situation. Den Lovligheden af webscraping varierer afhængigt af landet, typen af indsamlede data og den anvendelse, du har til dem. I Frankrig kan det være lovligt at scrape offentlige data lovligt på visse betingelser, men det sker ikke automatisk.
Tre ting, du skal tjekke, før du kører din scraper:
- Det Betingelser for brug på det pågældende websted, som kan forbyde scraping.
- det databaselovgivning, som beskytter producentens investering, selv når det drejer sig om offentlige data.
- det RGPD, som finder anvendelse, så snart der er tale om personoplysninger, selvom disse er offentliggjort.
Hvad AWS angår, er du selv ansvarlig for, at din virksomhed overholder lovgivningen. Hvis du er i tvivl, bør du få dit projekt godkendt af en fagperson.
Hvad er den bedste tilgang til webscraping med AWS?
Det afhænger helt af dit projekts omfang og varighed:
- AWS Lambda : til engangs-scraping kan man køre det under 15 minutter og et par hundrede URL’er. Den gratis niveau dækker 1 million forespørgsler om måneden, på permanent basis.
- EC2 : til langvarige opgaver (over 15 minutter) eller kontinuerlig scraping. En instans t3.micro udgør ca. 7,59 $/måned on-demand.
- Fargate : til parallelisering i stor skala uden at skulle administrere en server.
Konkret set starter du på Lambda for at teste, og skifter derefter over til EC2 eller Fargate, når mængden stiger. Hvis du foretrækker en kodeløs tilgang, kan du bruge værktøjer som Øjeblikkelig dataskraber gør det muligt at indsamle data direkte fra din browser.
Kan jeg bruge Selenium på AWS Lambda til webscraping?
Ja, men det er mere kompliceret at få sat i gang. Selenium og browsere uden grafisk brugergrænseflade som Puppeteer er nyttige til udtrække data fra sider med JavaScript. Deres konfiguration på Lambda kræver dog nogle optimeringer: pakkens størrelse, håndtering af afhængigheder og tildelt hukommelse.
Hvordan undgår jeg at blive blokeret af en hjemmeside på AWS?
Websteder opdager ofte scrapers og blokerer deres forespørgsler. Her er nogle effektive taktikker til at mindske risikoen:
- Skift regelmæssigt User-Agent-hovedet for at fremstå mere menneskelig.
- Tilføj tilfældige forsinkelser mellem hver forespørgsel.
- Brug af roterende proxyer for at ændre din IP-adresse.
- Begræns antallet af forespørgsler der sendes samtidigt fra den samme IP-adresse.
Hvordan integreres de scrapede data i en database?
Når dataene er indsamlet, kan du indsætte dem i en relationsdatabase som f.eks. Amazon RDS (MySQL, PostgreSQL osv.).
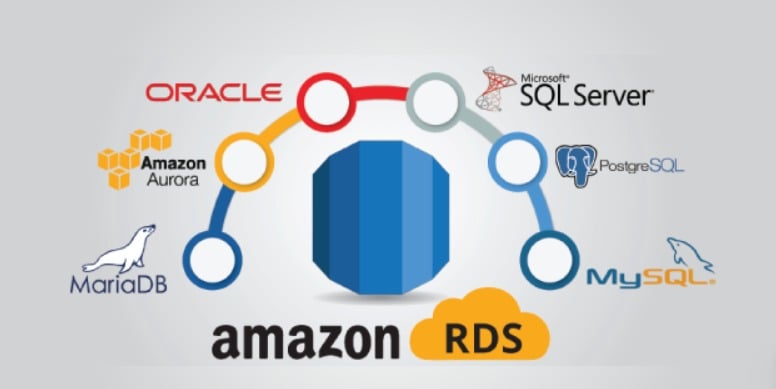
God praksis er at at rense og strukturere dataene før indsættelsen. Derefter kan du automatisere integrationen via et Python-script eller en pipeline, for at få en ren database, der er klar til brug.
Ved at kombinere styrken fra’AWS og god praksis for scraping, så kan du hente dine data effektivt og sikkert. Hvis du går i stå på et trin, er du velkommen til at stille dine spørgsmål i kommentarfeltet!








 Dansk