AWS te permet de faire du web scraping sans gérer de serveur.
Pour un scraper léger et automatisé, Lambda + S3 suffit largement.
Pour des millions de pages en parallèle, tu passes sur Fargate ou EC2 avec Scrapy.
Quel est le rôle d’AWS dans le web scraping ?
Le web scraping permet de récupérer automatiquement des données sur des sites web pour les analyser ou les réutiliser. Gérer des millions de pages, éviter les blocages et assurer la fiabilité peut vite devenir un vrai casse-tête technique, surtout si tu dois maintenir ton infrastructure toi-même.
C’est là qu’AWS (Amazon Web Services) entre en jeu. Cette plateforme cloud d’Amazon simplifie le scraping en automatisant la gestion des serveurs, en prenant en charge la scalabilité, la disponibilité et la sécurité à ta place, même avec des volumes massifs de data.
Voici pourquoi AWS est une solution idéale pour lancer un scraper :
- Scalabilité : la plateforme monte automatiquement en charge pour gérer des millions de requêtes sans interruption.
- Fiabilité : les services managés d’AWS limitent les risques de panne et assurent un fonctionnement continu.
- Coût maîtrisé : avec le modèle pay-as-you-go, tu ne payes que ce que tu consommes réellement.
- Sécurité : AWS applique des mesures solides pour protéger tes data stockées et transmises.
Quels sont les services pertinents d’AWS ?
Le cloud d’Amazon propose une large gamme de services adaptés à chaque besoin de web scraping. Voici les principaux à connaître, classés par usage.
Le calcul : où tourne ton scraper
- AWS Lambda : idéal pour les petites tâches et le scraping ponctuel, sans gérer de serveur. C’est l’approche serverless par excellence.
- Amazon EC2 : parfait pour les processus longs ou gourmands en ressources. Tu loues une machine virtuelle et tu gardes la main sur toute la configuration.
Le stockage : où tu ranges tes données
- Amazon S3 : pour stocker les data brutes, les fichiers HTML ou les résultats de scraping dans un bucket. Chaque fichier est identifié par une key unique dans le bucket S3, ce qui facilite l’accès et l’organisation des data collectées.
- Amazon DynamoDB : pour les data structurées qui exigent des lectures et écritures très rapides.
L’orchestration : pour enchaîner les étapes
- AWS Step Functions : pour piloter des flux de travail complexes, quand plusieurs fonctions doivent s’enchaîner dans un ordre précis.
Les services complémentaires
- Amazon SQS : pour gérer les files d’attente de requêtes et lisser le traitement des data à grande échelle.
- AWS IAM : pour gérer les accès et définir une policy précise, afin que ton scraper n’ait que les droits dont il a réellement besoin.
En pratique, un projet simple combine souvent Lambda + S3 + IAM. Pour du scraping massif, tu ajoutes EC2, SQS et DynamoDB selon tes besoins.
Comment construire un scraper serverless avec AWS Lambda ?
Avec AWS Lambda, tu n’as pas à gérer le serveur : AWS prend en charge toute l’infrastructure, de la scalabilité à la maintenance. Tu fournis juste ton code et la configuration. Voici comment construire ton premier scraper serverless, étape par étape.
1. Architecture de base d’un scraper serverless
Avant de coder, visualise comment les différents services AWS vont travailler ensemble. Trois choix structurent ton architecture.
- Choisir le déclencheur
C’est l’élément qui décide quand ton code doit s’exécuter. Tu as le choix entre CloudWatch et EventBridge.
- Choisir le compute
C’est l’endroit où ton code s’exécute dans le cloud. Prends Lambda pour des tâches courtes et épisodiques. Passe sur EC2 ou Fargate si le travail est long ou lourd.
- Choisir le stockage
Utilise S3 pour des fichiers JSON, CSV ou bruts. Choisis DynamoDB si tu as besoin d’accès rapides et structurés à tes data.
En résumé : le déclencheur active Lambda, Lambda exécute le scraping, et les data atterrissent dans le bucket S3.
2. Préparation de l’environnement
Avant de coder, donne à AWS les autorisations nécessaires et crée un espace de stockage.
- Créer un rôle IAM (les permissions)
- Va dans la console AWS > IAM > Rôles.
- Crée un rôle dédié à Lambda.
- Donne-lui deux permissions essentielles :
AWSLambdaBasicExecutionRolepour envoyer les logs vers CloudWatch, et une permission S3 pour écrire les fichiers dans ton bucket.
- Créer un bucket S3 (le stockage des résultats)
- Va dans la console AWS > S3.
- Crée un bucket et garde les paramètres de sécurité activés.
Lambda a désormais le droit d’écrire dans ton bucket S3, et tu as un endroit prêt pour stocker tes data.
3. Le code Python pour AWS Lambda
Écris un scraper en Python avec la bibliothèque Requests. Ce script récupère une page web et stocke le résultat dans le bucket S3.
- Exemple de code simple (avec requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # URL à scraper (ici un exemple simple)
    url = "https://example.com"
    response = requests.get(url)

    # Vérification du statut
    if response.status_code == 200:
        # Nom du fichier (avec timestamp pour éviter les collisions)
        filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # Envoi dans S3
        s3_client.put_object(
            Bucket=os.environ['BUCKET_NAME'],  # à définir dans tes variables d'environnement Lambda
            Key=filename,
            Body=response.text,
            ContentType="text/html"
        )

        return {
            'statusCode': 200,
            'body': json.dumps(f"Page sauvegardée dans {filename}")
        }
    else:
        return {
            'statusCode': response.status_code,
            'body': json.dumps("Erreur lors du scraping")
        }
requests récupère le contenu de la page web. boto3 est la bibliothèque officielle pour communiquer avec AWS. Pour aller plus loin avec les API, tu peux adapter ce même schéma à des endpoints distants.
- Gestion des dépendances (requests ou Scrapy)
Lambda ne fournit pas ces bibliothèques par défaut. Tu as deux options.
Option 1 : créer un package ZIP
- Crée un dossier sur ta machine :
mkdir package && cd package
pip install requests -t .- Ajoute ton fichier
lambda_function.pydans ce dossier. - Compresse le tout en
.zipet uploade-le dans Lambda.
Option 2 : utiliser les Lambda Layers
- Crée une couche Lambda contenant Requests (ou Scrapy pour du scraping plus avancé).
- Attache cette couche à ta fonction Lambda.
Avantage : c’est plus propre si tu réutilises les mêmes dépendances dans plusieurs fonctions.
4. Déploiement et test
Il reste à mettre ton code en ligne et vérifier qu’il fonctionne.
- Uploader le code dans Lambda
- Connecte-toi à la console AWS et va dans le service Lambda.
- Clique sur Create function, puis choisis Author from scratch.
- Donne un nom à ta fonction (exemple :
scraper-lambda) et choisis le runtime Python 3.12 (ou la version que tu utilises). - Associe le rôle IAM créé précédemment, avec les permissions S3 et CloudWatch.
- Dans l’onglet Code, choisis Upload from > .zip file et importe ton fichier
lambda_package.zip. - Ajoute une variable d’environnement :
BUCKET_NAME= nom de ton bucket S3. - Clique sur Save pour enregistrer la configuration de ta fonction Lambda.
- Tester la fonction
- Dans ta fonction Lambda, clique sur Test.
- Crée un nouvel événement de test avec un petit JSON, par exemple :
{
"url": "https://example.com"
}- Clique sur Save, puis sur Test pour exécuter la fonction.
- Dans l’onglet Logs, vérifie le statut : tu dois voir un code 200 si tout s’est bien passé.
- Va dans ton bucket S3 : tu vois apparaître un fichier
scraping_xxxx.html.
Quelles sont les solutions pour le web scraping à grande échelle ?
Pour collecter des millions de pages, il te faut une infrastructure solide. L’idée sur AWS est de répartir la charge et de lancer plusieurs scrapers en parallèle.
1. Utiliser Scrapy et AWS Fargate/EC2
Scrapy est un framework Python parfait pour les projets complexes. Par défaut, ton scraper tourne sur ta machine, ce qui est vite limité en volume. Pour passer à l’échelle, tu as deux options sur AWS.
AWS Fargate lance ton scraper Scrapy dans des conteneurs Docker, sans jamais gérer un serveur. C’est l’option idéale pour un scraping serverless et scalable. La démarche tient en trois étapes :
- Tu crées ton scraper Scrapy.
- Tu le mets dans un conteneur Docker.
- Tu déploies ce conteneur avec Fargate pour qu’il s’exécute automatiquement à grande échelle.
Amazon EC2 est l’alternative si tu veux plus de contrôle sur ton environnement. Tu installes toi-même Python et Scrapy sur une instance, puis tu automatises l’exécution. Une instance t3.micro revient à environ 7,59 $/mois en On-Demand sur us-east-1.
Dans les deux cas, les data extraites sont envoyées vers un bucket S3, qui centralise le stockage de tous tes fichiers scrapés.
2. Architecture de scraping distribuée
Pour paralléliser vraiment, tu t’appuies sur Amazon SQS (Simple Queue Service). Le principe est simple : tu déposes toutes tes URLs dans SQS, et plusieurs fonctions Lambda ou plusieurs conteneurs (sur EC2 ou Fargate) récupèrent ces URLs en parallèle pour lancer le scraping. Chaque fonction Lambda lit une URL depuis la queue, exécute le scraping et stocke le résultat dans un bucket S3 avec une key unique.
Cette architecture te permet de répartir le travail et d’avancer sur des milliers de pages simultanément. C’est le socle d’un scraper distribué performant sur le cloud AWS. Pour les pages à contenu dynamique chargé en Ajax, tu devras adapter ton approche pour capturer les data après rendu.
3. Gérer les proxys et les requêtes bloquées
Beaucoup de sites bloquent les scrapers en détectant un volume anormal de requêtes ou en filtrant certaines adresses IP. Deux solutions permettent de contourner ce blocage :
- La rotation d’adresses IP, via AWS ou des services spécialisés.
- L’utilisation de proxys tiers comme Bright Data ou ScrapingBee, qui gèrent automatiquement la rotation et l’anti-blocage.
Quelles sont les solutions aux problèmes courants du web scraping avec AWS ?
Les obstacles ne sont jamais très loin quand tu fais du web scraping : erreurs réseau, blocages, coûts imprévus. La bonne nouvelle, c’est qu’AWS propose déjà les services pour diagnostiquer et corriger ces problèmes rapidement.
Analyser les journaux avec Amazon CloudWatch
Quand une fonction Lambda ou une instance EC2 échoue, difficile de savoir d’où vient l’erreur sans visibilité sur l’exécution. Avec Amazon CloudWatch, tous les logs sont centralisés et consultables depuis la console. Tu y repères vite les erreurs fréquentes :
- Dépassements de délai : la requête a mis trop de temps à répondre.
- Erreurs 403 : le site bloque ton scraper.
- Erreurs 429 : trop de requêtes envoyées d’un coup.
- Manque de mémoire ou dépendances Python absentes dans le code Lambda.
Configure des alertes CloudWatch pour être prévenu automatiquement dès qu’une erreur revient trop souvent.
Gestion des erreurs de requêtes
Un scraper peut planter complètement si une seule requête échoue. La base : entoure tes appels en Python avec try…except pour empêcher le programme de s’arrêter brutalement sur une erreur isolée.
Ensuite, mets en place des stratégies de ré-essai :
- Réessaie après un court délai, puis augmente progressivement le temps d’attente (recul exponentiel).
- Alterne entre plusieurs proxies si une IP se fait bloquer.
- Ajuste la fréquence de tes requêtes pour rester discret et passer sous le radar.
Suivi des coûts
Un scraper mal optimisé peut générer des milliers d’appels Lambda ou laisser tourner une grosse instance EC2 pour rien. Pour garder le contrôle, utilise AWS Billing et surveille la consommation de chaque service.
Quelques ordres de grandeur pour te situer :
- Lambda : environ 0,20 $ par million de requêtes, plus le temps d’exécution facturé en Go-secondes. Le free tier couvre 1 million de requêtes gratuites et 400 000 Go-secondes chaque mois, de façon permanente. Les data extraites sont stockées dans un bucket S3 ; surveille le volume stocké, car S3 facture aussi la quantité de data conservée.
- EC2 t3.micro : autour de 7,59 $/mois en On-Demand sur us-east-1, bien moins avec des instances Spot.
Côté optimisation, quelques réflexes simples :
- Pour Lambda : réduis la mémoire allouée et limite la durée d’exécution (15 minutes maximum par invocation, au-delà la fonction s’arrête automatiquement et tu dois basculer sur EC2 ou Fargate).
- Pour EC2 : choisis une instance adaptée à ta charge, ou passe sur des instances Spot (moins chères, mais interrompues à tout moment).
- Active des alertes budgétaires AWS pour être averti avant de dépasser un seuil que tu fixes toi-même.
FAQ
Le web scraping avec AWS est-il légal ?
Ça dépend de ton cas précis. La légalité du web scraping varie selon le pays, le type de data collectées et l’usage que tu en fais. En France, scraper des données publiques peut être licite sous conditions, mais ce n’est pas automatique.
Trois points à vérifier avant de lancer ton scraper :
- Les conditions d’utilisation du site ciblé, qui peuvent interdire le scraping.
- Le droit des bases de données, qui protège l’investissement du producteur même sur des données publiques.
- Le RGPD, qui s’applique dès qu’une donnée personnelle est concernée, même publiée.
Côté AWS, tu restes responsable de la conformité de ton activité. En cas de doute, fais valider ton projet par un professionnel.
Quelle est la meilleure approche pour le web scraping avec AWS ?
Tout dépend de la taille et de la durée de ton projet :
- AWS Lambda : pour du scraping ponctuel, une exécution sous 15 minutes et quelques centaines d’URLs. Le free tier couvre 1 million de requêtes par mois, de façon permanente.
- EC2 : pour des tâches longues (plus de 15 minutes) ou du scraping continu. Une instance t3.micro tourne à environ 7,59 $/mois en On-Demand.
- Fargate : pour de la parallélisation à grande échelle, sans gérer de serveur.
Concrètement, commence sur Lambda pour tester, puis bascule sur EC2 ou Fargate quand le volume augmente. Si tu préfères une approche sans code, des outils comme Instant Data Scraper permettent de collecter des data directement depuis ton navigateur.
Puis-je utiliser Selenium sur AWS Lambda pour le web scraping ?
Oui, mais c’est plus complexe à mettre en place. Selenium et les navigateurs sans interface graphique comme Puppeteer sont utiles pour scraper des pages en Javascript. Leur configuration sur Lambda demande cependant des optimisations : taille du package, gestion des dépendances et mémoire allouée.
Comment éviter de me faire bloquer par un site web sur AWS ?
Les sites détectent souvent les scrapers et bloquent leurs requêtes. Voici quelques tactiques efficaces pour réduire les risques :
- Modifier régulièrement l’en-tête User-Agent pour paraître plus humain.
- Ajouter des délais aléatoires entre chaque requête.
- Utiliser des proxies rotatifs pour varier ton adresse IP.
- Limiter le nombre de requêtes envoyées simultanément depuis la même IP.
Comment intégrer les données scrapées dans une base de données ?
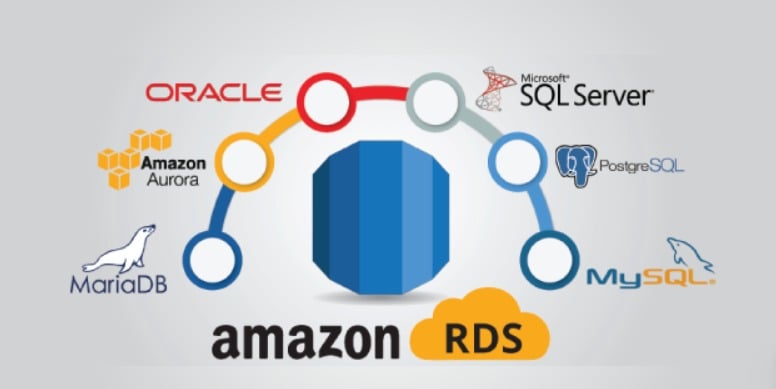
Une fois les data collectées, tu peux les insérer dans une base relationnelle comme Amazon RDS (MySQL, PostgreSQL, etc.).
La bonne pratique est de nettoyer et structurer les data avant l’insertion. Tu peux ensuite automatiser l’intégration via un script Python ou un pipeline, pour obtenir une base propre et prête à exploiter.
En combinant la puissance d’AWS et les bonnes pratiques du scraping, tu extrais tes data efficacement et en toute sécurité. Si tu bloques sur une étape, n’hésite pas à nous poser tes questions en commentaire !







 Français