AWS 让你无需管理服务器即可进行网页抓取。.
若要开发一款轻量级且自动化的数据抓取工具,, Lambda + S3 已经绰绰有余了。.
若需并行处理数百万个页面,请访问 Fargate 在哪里 EC2 和 Scrapy.
AWS在网页抓取中扮演什么角色?
这 网络搜刮 允许 自动获取数据 从网站上获取数据以进行分析或再利用。管理 数百万页, ,避免系统死锁并确保系统可靠性,这很快就会变成一个真正的技术难题,尤其是当你需要自己维护基础设施的时候。.
就在那里……’AWS (亚马逊网络服务) 便派上了用场。该平台 亚马逊云 通过自动化服务器管理,简化了数据抓取,并支持 可扩展性, ,即使面对海量数据,也能为你确保系统可用性和安全性。.
以下是 AWS 为何是启动爬虫程序的理想解决方案:
- 可扩展性 :该平台会自动扩展,以不间断地处理数百万次请求。.
- 可靠性 : AWS 的托管服务可降低故障风险,并确保系统持续运行。.
- 成本可控 : 采用该模型 按量付费, ,你只需按实际消耗量付费。.
- 安全 : AWS 采取了严格的措施来保护你存储和传输的数据。.
AWS有哪些相关服务?
亚马逊云服务提供了种类繁多的服务,可满足各种网络爬虫需求。以下是按用途分类的主要服务,值得了解。.
计算:你的爬虫在哪个地方运行
- AWS Lambda : 非常适合处理小型任务和临时抓取,无需管理服务器。这就是这种方法 无服务器 堪称典范。.
- Amazon EC2 : 非常适合耗时较长或资源消耗较大的流程。你可以租用一台 虚拟机 而且你可以完全掌控整个配置过程。.
存储:你把数据存放在哪里
- Amazon S3 : 用于存储 原始数据, HTML 文件或抓取结果保存在一个 bucket. 每个文件都通过一个 key 在该桶中唯一 S3, ,这使得对所收集数据的访问和整理更加便捷。.
- Amazon DynamoDB : 对于 结构化数据 这些操作需要非常快的读写速度。.
协调:衔接各个阶段
- AWS Step Functions :用于管理复杂的工作流,即当多个功能需要按特定顺序依次执行时。.
附加服务
- Amazon SQS :用于管理请求队列并平滑处理大规模数据。.
- AWS IAM : 用于管理访问权限并设置一个 政策 请明确指定,以确保你的爬虫仅拥有其真正需要的权限。.
实际上,一个简单的项目通常会结合 Lambda + S3 + IAM. 若要进行大规模数据抓取,请添加 EC2, SQS 和 DynamoDB 根据你的需求。.
如何使用AWS Lambda构建无服务器抓取器?
和 AWS Lambda, ,你无需管理服务器:AWS 负责管理整个基础设施,从 可扩展性 到 维护. 你只需提供代码和配置即可。以下是分步构建你的第一个无服务器爬虫的指南。.
1. 无服务器抓取器的基本架构
在编写代码之前,先设想一下各个AWS服务将如何协同工作。有三种选择将决定你的架构结构。.
- 选择触发器
这是决定你的代码何时执行的关键要素。你可以选择以下选项之一: CloudWatch 和 EventBridge.
- 选择计算
这是你的代码在云端运行的地方。请 Lambda 适用于短暂且不定期的任务。跳过 EC2 在哪里 Fargate 如果工作时间长或工作量大。
- 选择存储
使用 S3 适用于 JSON、CSV 或原始文件。请选择 DynamoDB 如果你需要快速且有条理地访问你的数据。.
简而言之:触发器会激活Lambda,Lambda执行数据抓取,数据最终会被发送到 S3 存储桶.
2. 环境准备
在编写代码之前,请向 AWS 授予必要的权限并创建一个存储空间。.
- 创建角色 IAM (权限)
- 进入控制台 AWS > IAM > 角色.
- 为 Lambda 创建一个专用角色。.
- 授予他两项关键权限:
AWS Lambda 基本执行角色用于将日志发送到CloudWatch,以及一项S3权限,用于将文件写入你的存储桶。.
- 创建一个存储桶 S3 (结果存储)
- 进入控制台 AWS > S3.
- 创建一个存储桶并保存这些 安全设置 已启用。.
Lambda 现在有权向你的 S3 存储桶写入数据,你已经有一个可以存储数据的地方了。.
3. AWS Lambda 的 Python 代码
写一个 Python中的网页抓取 与图书馆 Requests. 该脚本用于抓取网页,并将结果存储到 S3 存储桶中。.
- 简单代码示例(包含 requests) :
import json
import boto3
import requests
import os
from datetime import datetime

s3_client = boto3.client('s3')

def lambda_handler(event, context):
    # 待抓取的URL (此处为一个简单示例)
    url = "https://example.com"
    response = requests.get(url)

 # 状态检查
    if response.status_code == 200:
 # 文件名 (带时间戳以避免冲突)
 filename = f"scraping_{datetime.utcnow().isoformat()}.html"

        # 上传至 S3
 s3_client.put_object(
 Bucket=os.environ['BUCKET_NAME'],  # 需在 Lambda 环境变量中定义
 Key=filename,
            Body=response.text,
 ContentType="text/html"
 )

 return {
 'statusCode': 200,
 'body': json.dumps(f"页面已保存至 {filename}")
        }
    else:
 return {
 'statusCode': response.status_code,
 'body': json.dumps("抓取时发生错误")
 }
要求 获取网页内容。. boto3 是用于与 AWS 通信的官方库。若要进一步利用 API,你可以将此方案应用于远程端点。.
- 依赖项管理(requests 在哪里 Scrapy)
Lambda 默认不提供这些库。你有两种选择。.
选项 1:创建一个软件包 ZIP
- 在你的电脑上创建一个文件夹:
mkdir package && cd packagepip install requests -t .- 上传你的文件
lambda_function.py在此文件中。 - 将所有内容压缩为
.zip并将其上传到Lambda。.
选项 2:使用 Lambda Layers
- 创建一个包含 Requests(或用于更高级爬取的 Scrapy)的 Lambda 层。.
- 将该层绑定到你的Lambda函数上。.
优势 : 如果在多个函数中复用相同的依赖项,代码会更简洁。.
4. 部署与测试
接下来只需将你的代码上传到网上,并确认它能否正常运行。.
- 将代码上传到 Lambda
- 登录 AWS 控制台,进入 Lambda 服务。.
- 点击 创建函数, ,然后选择 作者从零开始.
- 为你的函数命名(例如:
scraper-lambda) 并选择 Python 3.12 运行时 (或你使用的版本)。. - 将之前创建的IAM角色与S3和CloudWatch权限关联起来。.
- 在 编码, 选择 从 > .zip 文件上传 并导入你的文件
lambda_package.zip. - 添加一个环境变量:
BUCKET_NAME= 你的 S3 存储桶名称。. - 点击 保存 以保存你的Lambda函数的配置。.
- 测试功能
- 在你的 Lambda 函数中,点击 测试.
- 创建一个包含一小段 JSON 数据的新测试事件,例如:
{ "url": "https://example.com" }- 点击 保存然后 测试 执行该功能。
- 在 日志, ,检查状态:你应该会看到一个 代码 200 如果一切顺利的话。.
- 进入你的 S3 存储桶:你会看到出现一个文件
scraping_xxxx.html.
大规模网络爬虫有哪些解决方案?
为了收集 数百万页, ,你需要一个坚实的基础设施。在AWS上的思路是分散负载,并并行运行多个爬虫。.
1. 使用 Scrapy 和 AWS Fargate/EC2
Scrapy 是一个非常适合复杂项目的 Python 框架。默认情况下,你的爬虫在本地机器上运行,这很快就会受到处理量的限制。若要实现规模化,你可以在 AWS 上选择以下两种方案。.
AWS Fargate 将你的 Scrapy 爬虫工具投入到 Docker容器, ,且无需管理任何服务器。这是实现无服务器且可扩展的爬取任务的理想选择。该流程分为三个步骤:
- 创建你的Scrapy爬虫。.
- 把它放进容器里 Docker.
- 你使用以下命令部署该容器: Fargate 以便其能够在大规模范围内自动执行。.
亚马逊弹性计算云(Amazon EC2) 如果你希望对运行环境拥有更多控制权,这是一种可选方案。你可以自行在某个实例上安装 Python 和 Scrapy,然后实现自动化执行。一个实例 t3.micro 大约相当于 7.59 $/月 在 us-east-1 上以按需方式提供。.
在这两种情况下,提取的数据都会被发送到一个 S3 存储桶, ,该服务将集中存储你所有抓取的文件。.
2. 分布式抓取架构
要想真正实现并行化,你需要依靠 Amazon SQS (简单队列服务)。原理很简单:你将所有URL放入SQS中,然后有多个函数 拉姆达 或多个容器(在 EC2 或 Fargate 上)获取这些 URL 并行 以启动数据抓取。每个 Lambda 函数都会从队列中读取一个 URL,执行数据抓取,并将结果存储在 S3 存储桶 并配有一个唯一密钥。.
这种架构使你能够 分工 并能同时处理数千个网页。这是在AWS云端构建高效分布式爬虫的基础。对于通过Ajax加载动态内容的网页,你需要调整处理方式,以便在页面渲染完成后捕获数据。.
3. 管理代理和被阻止的请求
许多网站会通过检测异常大量的请求或过滤某些请求来阻止爬虫 IP 地址. 有两种方法可以绕过这一限制:
- 这 IP地址轮换, ,通过AWS或专业服务。.
- 使用 第三方代理 作为 亮数据 在哪里 ScrapingBee, ,可自动控制车轮转速和防抱死功能。.
使用 AWS 解决常见网络搜索问题的方法有哪些?
进行网页抓取时,障碍总是如影随形:网络错误、阻塞、意外成本。好消息是,AWS 已经提供了相关服务,能够快速诊断并解决这些问题。.
使用 Amazon CloudWatch 分析日志
当一个 Lambda 函数或 EC2 实例发生故障时,如果无法查看其执行情况,就很难确定错误的来源。借助 Amazon CloudWatch, 所有日志均已集中管理,可通过控制台进行查看。您可以在其中快速识别常见错误:
- 逾期情况 :该请求的响应时间过长。.
- 错误 403 :该网站阻止了你的爬虫程序。.
- 错误 429 : 一次性发送的请求过多。.
- 内存不足还是 缺少 Python 依赖项 在Lambda代码中。.
配置 CloudWatch警报 以便在错误频繁出现时自动收到通知。.
查询错误管理
如果仅有一个请求失败,爬虫就可能完全崩溃。基本原则:在 Python 调用周围添加 try…except 以防止程序因单个错误而突然终止。.
接下来,请设置 重试策略 :
- 稍等片刻后再试一次,然后逐步延长等待时间(指数级下降).
- 在多个之间交替 代理 如果某个IP地址被封禁。.
- 调整查询频率,以保持低调,不引人注目。.
成本跟踪
优化不当的爬虫可能会触发数千次 Lambda 调用,或让一个大型 EC2 实例无谓地持续运行。为了保持控制,请使用 AWS Billing 并监控每个服务的资源消耗情况。.
给你一些数量级供参考:
- 拉姆达 关于 每百万次查询 0.20 $, ,加上按Go-秒计费的运行时间。该 免费套餐 覆盖 100万次免费查询 和 400 000 戈秒 每月定期进行。提取的数据存储在 S3 存储桶 ; 请监控存储容量,因为S3还会根据保留的数据量计费。.
- EC2 t3.micro : 围绕 7.59 $/月 在 us-east-1 上的按需服务,而使用 Spot 实例.
在优化方面,有几个简单的技巧:
- 对于 Lambda:减少分配的内存并限制执行时间(最多15分钟 (通过调用,超过该限制后函数会自动停止,你需要切换到 EC2 或 Fargate)。.
- 对于 EC2:选择一款适合你工作负载的实例,或者切换到 Spot 实例 (价格更便宜,但随时可能中断)。.
- 激活 AWS 预算警报 以便在超过你自己设定的阈值之前收到提醒。.
常见问题
使用AWS进行网络爬虫是否合法?
这要看你的具体情况。该 网络搜索的合法性 这取决于所在国家、所收集数据的类型以及你的使用方式。在法国,抓取公共数据可能 在一定条件下合法, ,但这并非自动发生的。.
在启动数据抓取程序之前,有三个要点需要检查:
- 这 使用条件 目标网站的规则,这些规则可能会禁止数据抓取。.
- 这 数据库法, ,即使涉及公共数据,也能保护制作方的投资。.
- 这 RGPD, ,只要涉及个人数据,即使该数据已被公开,该规定即刻生效。.
在AWS方面,你仍需对自身业务的合规性负责。如有疑问,请请专业人士对你的项目进行审核。.
使用AWS进行网络爬虫的最佳方法是什么?
这完全取决于你的项目规模和持续时间:
- AWS Lambda : 对于一次性数据抓取,可在 15 分钟 以及几百个URL。该 免费套餐 覆盖 每月100万次查询, ,永久性地。.
- EC2 :适用于耗时较长的任务(超过15分钟)或持续的网页抓取。一个实例 t3.micro 大约为 7.59 $/月 点播。.
- Fargate :适用于大规模并行化,无需管理服务器。.
具体来说,先在Lambda上进行测试,待业务量增加后再切换到EC2或Fargate。如果你更倾向于无代码方案,可以使用以下工具: 即时数据抓取器 可直接从你的浏览器收集数据。.
我可以在AWS Lambda上使用Selenium进行网页抓取吗?
是的,但这在实施上比较复杂。. Selenium 以及没有图形界面的浏览器,例如 Puppeteer 对……很有用 使用JavaScript抓取网页. 不过,它们在Lambda上的配置仍需进行优化:包大小、依赖项管理以及内存分配。.
如何避免被运行在AWS上的网站屏蔽?
网站通常会检测到爬虫并阻止其请求。以下是一些有效的策略,可降低相关风险:
- 定期修改 User-Agent 标头 为了显得更有人情味。.
- 添加随机延迟 在每次请求之间。.
- 使用轮换代理 以更改你的IP地址。.
- 限制请求数量 从同一IP地址同时发送。.
如何将抓取的数据整合到数据库中?
数据收集完成后,你可以将其导入关系型数据库中,例如 Amazon RDS (MySQL、PostgreSQL等)。
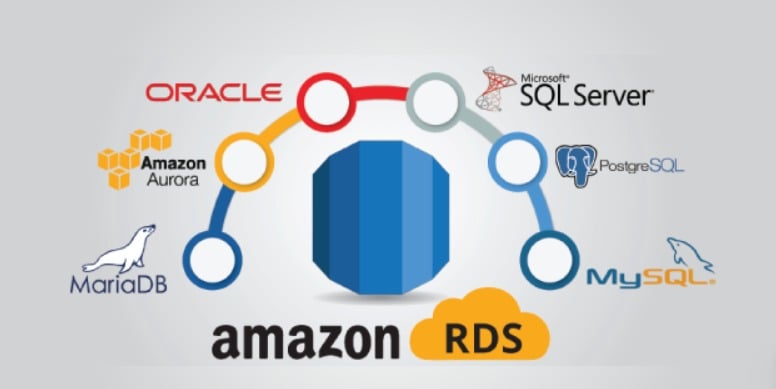
最佳实践是 清理和整理数据 在插入之前。然后你可以 自动化集成 通过Python脚本或管道,以获得一个干净且可直接使用的数据库。.
通过结合’AWS 和 网页抓取的最佳实践, ,你可以高效且安全地提取数据。如果在某个步骤遇到困难,欢迎在评论区向我们提问!








 简体中文