Webscraping med Python bygger på to hovedbiblioteker: requests for at hente websiderne og BeautifulSoup for at udtrække dataene.
I denne artikel vil du lære, hvordan du installerer dem, skriver dit første script og gemmer dine resultater, selvom du ikke har nogen erfaring med programmering.
Forudsætninger for scraping med Python

Inden du går i gang, skal der opfyldes tre betingelser. Her er de i logisk rækkefølge.
1. En grundlæggende viden om programmering
Du skal kende Grundlæggende programmering : variabler, kontrolstrukturer, funktioner, ordbøger, filhåndtering og biblioteker. Disse begreber giver dig mulighed for at forstå Scriptlogik, at bearbejde de hentede data og håndtere fejl korrekt.
2. Beherskelse af strukturen på en webside (HTML, CSS)
Python ser ikke websider på samme måde som dig. Det ser kun HTML-kode der udgør siden. Hvis du vil hente en bestemt oplysning, skal du vide, hvor den befinder sig i denne kode, ellers kan Python ikke udtrække den.

3. Forståelse af HTTP-anmodninger (GET, POST)
Inden Python læser koden på en side, skal det anmode hjemmesiden om den via en forespørgsel. En GET-anmodning henter siden, mens en POST-anmodning sender data til hjemmesiden. Uden denne forståelse kan dit script hverken hente siden eller de oplysninger, den indeholder.
Et andet vigtigt punkt: den web scraping er forskellig fra crawling. Crawling gennemgår alle siderne på et websted for at registrere og analysere dem. Scraping derimod er udelukkende rettet mod bestemte oplysninger. Denne skelnen er nyttig, når du skal planlægge dit arbejde ordentligt.

Hvad er de vigtigste værktøjer til webscraping med Python?
For at komme i gang skal du forberede dit arbejdsmiljø i tre trin: installere Python, isolere dit projekt og derefter tilføje de nødvendige biblioteker.
1. Installation af Python
Download Python fra den officielle hjemmeside python.org. Under installationen på Windows skal du huske at markere indstillingen Føj Python til PATH. Dette afkrydsningsfelt tilføjer Python-mappen og undermappen Scripts\ i PATH, hvilket gør kommandoen pip kan bestilles direkte online.
Siden Python 3.4, pip er inkluderet som standard. Det er pakkehåndteringen, der giver dig mulighed for at installere alle de biblioteker, du får brug for. Hvis den ikke genkendes, skal du bruge kommandoen python -m pip fungerer under alle omstændigheder.
2. Forberedelse af et virtuelt miljø
EN virtuelt miljø adskiller biblioteker i dit Python-projekt, uden at det påvirker de andre programmer på din computer. Du opretter det med python -m venv venv, og så aktiverer du den. Dine installationer forbliver dermed knyttet til netop dette projekt.
3. Installer de vigtigste biblioteker til scraping
EN bibliotek er en samling af forprogrammerede funktioner, som du kan bruge direkte i din kode. Det sparer dig for at skulle skrive det hele selv og gør gentagne opgaver nemmere. Her er de vigtigste:
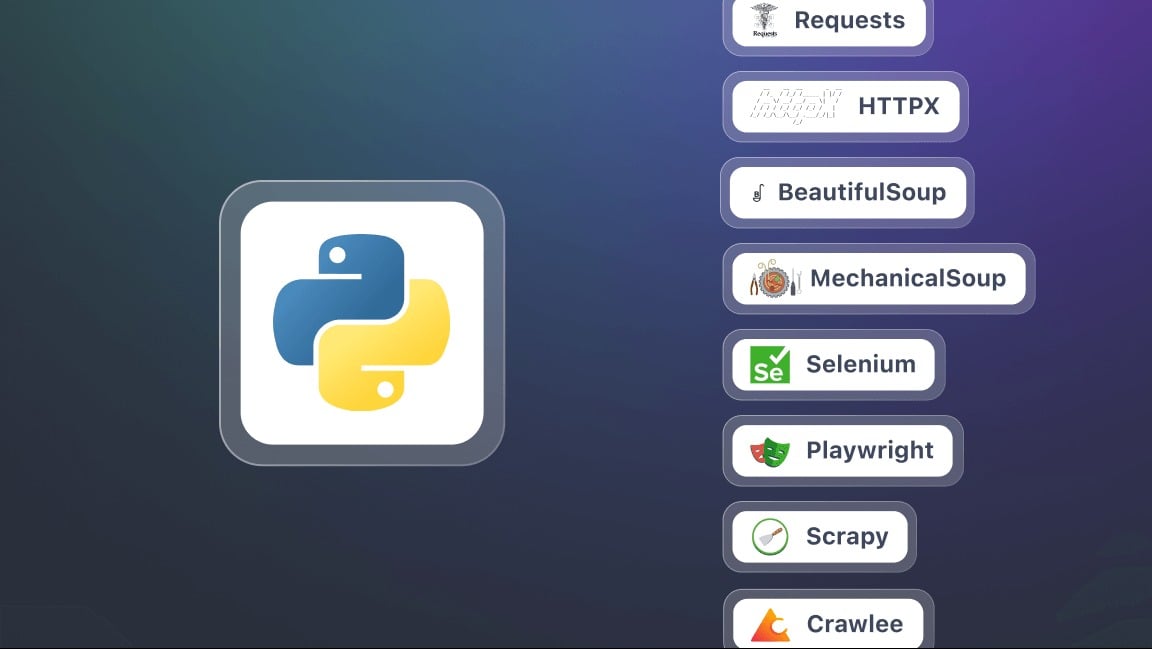
- Requests : sender HTTP-forespørgsler og henter indholdet fra websider. Det er grundlaget for al scraping.
- BeautifulSoup : analyserer HTML-koden og udtrækker oplysninger ved hjælp af praktiske selektorer som f.eks. find(), find_all() Hvor select().
- Selenium : nyttigt, når indholdet genereres dynamisk i JavaScript. Det simulerer en rigtig browser og interagerer med siden.
- lxml : en meget hurtig HTML- og XML-analysator, der er mere effektiv end BeautifulSoup, men lidt mere teknisk at lære at bruge.
- Playwright : et moderne alternativ til Selenium, som ofte er hurtigere.
- Scrapy : et kraftfuldt framework til scraping-projekter i stor skala, der kan håndtere flere sider og flere websteder samtidigt.
Hvordan kan jeg lave webscraping med Python?
Her er en trin-for-trin-vejledning til, hvordan du kommer i gang med dit første scraping-projekt. Hvert trin ledsages af en kodestykke klar til kopiering.
Trin 1: Installer biblioteker (requests og beautifulsoup4)
Du skal bruge to biblioteker: requests for at hente siderne og beautifulsoup4 for at udtrække dataene. Installer dem alle på én gang med pip :
pip install requests beautifulsoup4Om pip er ikke genkendt, brug python -m pip install requests beautifulsoup4, som fungerer uanset din PATH. Start derefter dit script med disse to linjer:
import requests
from bs4 import BeautifulSoup
Trin 2: Lav en HTTP-anmodning og hent indholdet
Når biblioteker er klar, kan du sende en HTTP-anmodning til en webside og vise dens indhold. Husk at bruge’Fuld URL fra målsiden:
importanmodninger

url = "https://exemple.com"
side = requests.get(url)

print(page.text) # Viser sidens HTML-kode
Her, page.text indeholder al HTML-koden fra det websted, du skal analysere.
Trin 3: Parsing af HTML med BeautifulSoup
Nu hvor du har hentet indholdet, kan du analysere det med BeautifulSoup. Dette trin omdanner Almindelig HTML i en struktur, der er nem at navigere i:
fra bs4 import BeautifulSoup

soup = BeautifulSoup(page.text, "html.parser")

# Eksempel: vis sidens titel
print(soup.title.string)
Trin 4: Udtræk specifikke data (titler, links osv.)
Tak til BeautifulSoup, du kan at målrette mod bestemte HTML-tags : overskrifter, links, afsnit osv. To af de mest almindelige eksempler:
# Udtræk alle titler <h2>
for title in soup.find_all("h2"):
    print(title.get_text())

# Udtræk alle links <a>
for lien i soup.find_all("a"):
    print(link["href"])
Trin 5: Gem data (CSV, JSON)
Når dine data er hentet, kan du gemme i en fil for at kunne genbruge dem senere. Formatet CSV egnet til malerier, den JSON til strukturerede data.
Eksempel i CSV :
importere csv

titles = [title.get_text() for title in soup.find_all("h2")]

med open("results.csv", "w", newline="", encoding="utf-8") som f:
    writer = csv.writer(f)
    writer.writerow(["Titel"])
    for t i titler:
        writer.writerow([t])
Eksempel i JSON :
import json

liens = [lien["href"] for lien in soup.find_all("a")]

med open("liens.json", "w", encoding="utf-8") som f:
    json.dump(liens, f, indent=4, ensure_ascii=False)
Denne vejledning henvender sig til en lille projekt, såsom scraping af en statisk hjemmeside. I praksis vil du hurtigt støde på mere avancerede udfordringer:
- Håndtering af paginering : Gå gennem flere sider for at få det hele med.
- Håndtering af formularer : Send data via en POST-anmodning for at få et filtreret resultat.
- At komme uden om restriktioner : tilføje en realistisk identifikationsoverskrift og gå gennem fuldmagter for at undgå at sidde fast.
Hvorfor webscraping med Python?
det web scraping med Python giver dig mange konkrete muligheder. Her er de anvendelsesmuligheder, der gør denne praksis virkelig nyttig i hverdagen.
- Prisovervågning og e-handel : Du indhenter produktoplysninger for at følge udviklingen i Priser, sammenligne konkurrenternes tilbud og finde de bedste tilbud i realtid.
- Analyse af kundeanmeldelser : Du indsamler kommentarer fra flere hjemmesider for at identificere tendenser, forstå forbrugernes forventninger og forbedre et produkt eller en tjeneste.

- Samling af indhold : Du samler blogindlæg og nyheder fra flere kilder på ét sted for at skabe en platform, der altid er opdateret.
- Forskning og overvågning : Du indsamler data til undersøgelser, følger med i publikationer eller holder øje med en bestemt branche.
I praksis sparer web scraping dig for timevis af manuelt kopierings- og indsætningsarbejde. Et enkelt, veludviklet script henter og opdaterer dine data automatisk med den hyppighed, du vælger.
Hvad er den bedste praksis for webscraping med Python?
Webscraping handler ikke kun om at udtrække data. Man skal også gøre det på en måde, hvor effektiv, ansvarlig og bæredygtig, ellers risikerer du hurtigt at blive blokeret. Her er de regler, du skal følge:
- Respekter robots.txt-filen : findes i rodmappen på et websted (f.eks. exemple.com/robots.txt), viser den dig, hvilke sider der er tilladt eller forbudt at scrape. Tjek den, før du kører dit script.
- Hold et rimeligt tempo i forespørgslerne : Indsæt en pause mellem hver forespørgsel for at undgå at overbelaste serveren og risikere at blive udelukket.
- Brug en relevant User-Agent : udfylder en overskrift User-Agent der entydigt identificerer din robot, i stedet for standardværdien på requests, som ofte blokeres automatisk.
- Håndtering af fejl og undtagelser : Indsæt dine forespørgsler i en fejlhåndteringsblok. En side, der ikke er tilgængelig, bør ikke få hele dit program til at gå ned.
- Brug af proxyservere og IP-rotation : Ved store datamængder kan man ved at skifte mellem flere IP-adresser undgå, at en enkelt adresse bliver opdaget og derefter blokeret.
- Minimere antallet af forespørgsler : Henter kun de sider, du virkelig har brug for. Færre forespørgsler betyder mindre belastning på serveren og mindre risiko for at blive opdaget.
- At være åben : angiv, når det er muligt, en kontakt-e-mailadresse i din User-Agent. Webstedsadministratoren kan således kontakte dig i stedet for at blokere dig.
- Adskil udtræk og sikkerhedskopiering : Henter først dataene og gemmer dem derefter i en CSV-fil eller en database. Hvis behandlingen mislykkes, går dine indsamlede data ikke tabt.
- Brug robuste selektorer : lægger vægt på stabile egenskaber som id Hvor data-* i stedet for CSS-klasser, der ofte ændres. Dit script vil bedre kunne modstå opdateringer af hjemmesiden.
- Dokumenter din kode : beskriv de vigtigste trin og notér datoen for din scraping. Sidens struktur ændrer sig, og du vil hurtigere kunne finde ud af, hvad der skal rettes, når den går i stykker.
Ofte stillede spørgsmål
Hvad er det bedste framework til webscraping i Python?
Der findes ikke en enkelt 'bedste' ramme, fordi alt afhænger af kompleksiteten i dit projekt.

- Til enkle udtrækninger, Requests og BeautifulSoup er mere end nok.
- Når et websted bruger meget JavaScript, så går du videre til Selenium Hvor Playwright.
- Endelig, når det drejer sig om et projekt af stor omfang, Scrapy er stadig det mest velegnede takket være dets ydeevne og robuste konstruktion.
Hvordan scraper jeg en hjemmeside i Python?
Processen bygger på tre hovedtrin :
- Du sender en HTTP-anmodning til målsiden.
- Du analyserer den HTML-struktur modtaget.
- Du udtrækker data som interesserer dig, og så gemmer du dem.
Hvad er webscraperens rolle?
det en webscrapers rolle er automatisk at gennemsøge websider for at udtrække specifikke data: tekster, priser, billeder eller links. Det fungerer som en mellemmand mellem hjemmesiden og dig ved at omdanne rådata til anvendelige data.

Hvordan bruger man BeautifulSoup i Python?
BeautifulSoup er et bibliotek, der er udviklet til at analysere en sides HTML-kode og nemt finde de tags, der indeholder de oplysninger, der skal udtrækkes. I praksis kombinerer du en HTTP-anmodning med Requests, og derefter analyserer du indholdet med BeautifulSoup for at navigere i strukturen og hente de ønskede data.
Hvordan scraper man en hjemmeside med dynamisk indhold i JavaScript?
Nogle sites er meget afhængige af JavaScript for at vise indholdet. I dette tilfælde kan man bruge klassiske løsninger som Requests er ikke længere nok. Du skal derfor bruge værktøjer, der kan simulere en rigtig browser, såsom Selenium Hvor Playwright, for at indlæse siden og interagere med den.
Hvad er det mest almindelige sprog, der bruges til webscraping?
Python er i dag det mest populære sprog til webscraping takket være dets enkelhed og de mange specialiserede biblioteker. Når det er sagt, kan du også automatisere’dataudtræk med PHP, selv om denne teknik stadig ikke er så udbredt.
Er webscraping lovligt?
Det Lovligheden af webscraping er et komplekst spørgsmål. Det afhænger helt af, hvordan du udøver det, og om du overholder Betingelser for brug afhængigt af de pågældende websteder og arten af de indsamlede data. I Frankrig er web scraping tilladt i visse tilfælde, men det kan blive ulovligt, hvis det krænker adgangsrettighederne, et websteds brugsbetingelser eller lovgivningen om personlig data.
Kort sagt åbner web scraping med Python op for en verden af utrolige muligheder! Hvad med dig – hvilke erfaringer har du, eller hvilke spørgsmål har du? Del dem gerne i kommentarerne – vi glæder os til at høre fra dig!








 DA