O web scraping com Python assenta em duas bibliotecas principais: requests para recuperar as páginas da Web e BeautifulSoup para extrair os dados.
Neste artigo, vais aprender a instalá-los, a escrever o teu primeiro script e a guardar os teus resultados, mesmo sem teres experiência em programação.
Pré-requisitos para o scraping com Python

Antes de começares, há três condições a cumprir. Aqui estão elas, por ordem lógica.
1. Conhecimentos básicos de programação
Tens de conhecer os noções básicas de programação : variáveis, estruturas de controlo, funções, dicionários, manipulação de ficheiros e bibliotecas. Estes conceitos permitem-te compreender a lógica do guião, de processar os dados recuperados e de gerir adequadamente os erros.
2. Dominar a estrutura de uma página Web (HTML, CSS)
O Python não vê as páginas da Web como tu. Ele vê apenas o código HTML que compõe a página. Se quiseres obter uma informação específica, tens de saber onde ela se encontra nesse código; caso contrário, o Python não a consegue extrair.

3. Compreender os pedidos HTTP (GET, POST)
Antes de ler o código de uma página, o Python tem de o solicitar ao site através de um pedido. Um Pedido GET carrega a página, enquanto uma pedido POST envia dados para o site. Sem compreender isto, o teu script não consegue obter nem a página nem as informações que ela contém.
Outro ponto importante: o raspagem da web é diferente do rastreamento. O crawling percorre todas as páginas de um site para as identificar e analisar. O scraping, por sua vez, visa apenas informações específicas. Esta distinção é útil para planear bem o teu trabalho.

Quais são as ferramentas essenciais para a recolha de dados da Web com Python?
Para começar, tens de preparar o teu ambiente de trabalho em três etapas: instalar o Python, isolar o teu projeto e, por fim, adicionar as bibliotecas necessárias.
1. Instalar o Python
Descarrega o Python no site oficial python.org. Durante a instalação no Windows, certifica-te de que marcas a opção Adicionar o Python ao PATH. Esta caixa de seleção adiciona a pasta Python e a subpasta Scripts\ no PATH, o que torna o comando pip disponível diretamente para encomenda online.
Desde Python 3.4, pip está incluído por predefinição. É o gestor de pacotes que te permite instalar todas as bibliotecas de que vais precisar. Caso não seja reconhecido, o comando python -m pip funciona em todos os casos.
2. Preparar um ambiente virtual
UMA ambiente virtual isolam as bibliotecas do teu projeto Python, sem interferir com as outras aplicações do teu computador. Cria-o com python -m venv venv, e depois ativas-o. As tuas instalações permanecem, assim, específicas desse projeto.
3. Instalar as principais bibliotecas para raspagem
A biblioteca é um conjunto de funções já programadas que podes utilizar diretamente no teu código. Evita que tenhas de reescrever tudo sozinho e simplifica as tarefas repetitivas. Aqui estão as principais:
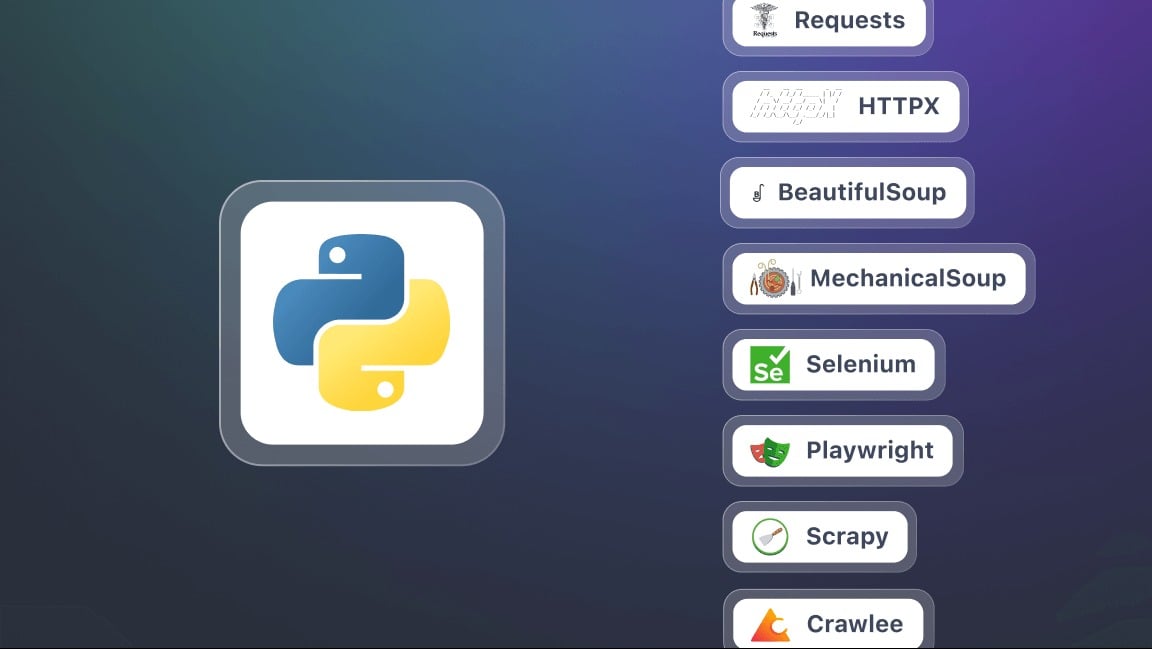
- Requests : envia pedidos HTTP e recupera o conteúdo das páginas da Web. É a base de qualquer operação de scraping.
- BeautifulSoup : analisa o código HTML e extrai as informações através de seletores práticos como find(), find_all() Onde select().
- Selenium : útil quando o conteúdo é gerado dinamicamente em JavaScript. Simula um navegador real e interage com a página.
- lxml : um analisador HTML e XML muito rápido, com melhor desempenho do que BeautifulSoup, mas um pouco mais técnico de se aprender a utilizar.
- Playwright : uma alternativa moderna a Selenium, muitas vezes mais rápido.
- Scrapy : um framework potente para projetos de scraping em grande escala, capaz de gerir várias páginas e vários sites em simultâneo.
Como é que posso fazer web scraping com Python?
Aqui está o procedimento, passo a passo, para lançares o teu primeiro projeto de scraping. Cada passo é acompanhado por um trecho de código pronto para copiar.
Passo 1: Instalar as bibliotecas (requests e beautifulsoup4)
Precisas de duas bibliotecas: requests para recuperar as páginas e beautifulsoup4 para extrair os dados. Instala-os todos de uma vez com pip :
pip install requests beautifulsoup4Se pip não é reconhecido, utiliza python -m pip install requests beautifulsoup4, que funciona independentemente do teu PATH. Em seguida, começa o teu script com estas duas linhas:
import requests
from bs4 import BeautifulSoup
Passo 2: Fazer um pedido HTTP e recuperar o conteúdo
Assim que as bibliotecas estiverem prontas, podes enviar uma Pedido HTTP para uma página web e apresentar o seu conteúdo. Não te esqueças de utilizar o’URL completa da página de destino:
pedidos de importação

url = "https://exemple.com"
página = requests.get(url)

print(page.text) # Apresenta o código HTML da página
Aqui, page.text contém todo o código HTML do site que vais analisar.
Passo 3: Analisar o HTML com o BeautifulSoup
Agora que já recuperaste o conteúdo, podes analisá-lo com BeautifulSoup. Esta etapa transforma o HTML simples numa estrutura fácil de explorar:
from bs4 import BeautifulSoup

soup = BeautifulSoup(página.texto, "html.parser")

# Exemplo: mostrar o título da página
print(soup.title.string)
Etapa 4: Extrair dados específicos (títulos, ligações, etc.)
Graças a BeautifulSoup, podes selecionar tags HTML específicas : títulos, links, parágrafos, etc. Dois dos exemplos mais comuns:
# Extrair todos os títulos <h2>
for title in soup.find_all("h2"):
    print(title.get_text())

# Extrair todas as ligações <a>
for lien in soup.find_all("a"):
    print(link["href"])
Passo 5: Guardar dados (CSV, JSON)
Depois de extraíres os teus dados, podes guardar num ficheiro para as reutilizar mais tarde. O formato CSV é adequado para quadros, o JSON aos dados estruturados.
Exemplo em CSV :
importar csv

títulos = [title.get_text() for title in soup.find_all("h2")]

com open("results.csv", "w", newline="", encoding="utf-8") as f:
    escritor = csv.writer(f)
    writer.writerow(["Título"])
    for t in titres:
        writer.writerow([t])
Exemplo em JSON :
importar json

liens = [lien["href"] for lien in soup.find_all("a")]

with open("liens.json", "w", encoding="utf-8") as f:
    json.dump(liens, f, indent=4, ensure_ascii=False)
Este tutorial destina-se a um pequeno projeto, como o scraping de um site estático. Na prática, vais rapidamente deparar-te com desafios mais avançados:
- Gerir a paginação : percorrer várias páginas para recuperar tudo.
- Gerir formulários : enviar dados através de um pedido POST para obter um resultado filtrado.
- Contornar as restrições : adicionar um cabeçalho de identificação realista e passar por proxies para evitar ficar preso.
Porquê fazer web scraping com Python?
a recolha de dados da Web com Python abre-te inúmeras possibilidades concretas. Eis as aplicações que tornam esta prática verdadeiramente útil no dia a dia.
- Controlo de preços e comércio eletrónico : recolhes fichas de produtos para acompanhar a evolução dos taxas, comparar as ofertas da concorrência e identificar as melhores oportunidades em tempo real.
- Análise das opiniões dos clientes : recolhes comentários em vários sites para identificar tendências, compreender as expectativas dos consumidores e melhorar um produto ou serviço.

- Agregação de conteúdos : centralizas os artigos de blogs ou as notícias provenientes de várias fontes para criar uma plataforma sempre atualizada.
- Investigação e monitorização : recolhes dados para estudos, acompanhas publicações ou manténs-te a par de um setor específico.
Na prática, o web scraping poupa-te horas de copiar e colar manualmente. Um único script bem concebido recolhe e atualiza os teus dados automaticamente, com a frequência que escolheres.
Quais são as melhores práticas para a recolha de dados da Web com Python?
O web scraping não consiste apenas em extrair dados. É também necessário fazê-lo de forma eficaz, responsável e sustentável, caso contrário, corres o risco de ser bloqueado rapidamente. Eis as regras a seguir:
- Respeitar o ficheiro robots.txt : presente na raiz de um site (ex. exemple.com/robots.txt), indica-te as páginas autorizadas ou proibidas para o scraping. Consulta-o antes de executares o teu script.
- Manter um ritmo razoável de pedidos : adiciona uma pausa entre cada pedido para evitar sobrecarregar o servidor e que sejas banido.
- Utilizar um User-Agent adequado : preenche um cabeçalho User-Agent que identifique claramente o teu robô, em vez do valor predefinido de requests, frequentemente bloqueada automaticamente.
- Gerir erros e exceções : envolve as tuas consultas num bloco de gestão de erros. Uma página indisponível não deve fazer com que todo o teu programa deixe de funcionar.
- Utilizar proxies e rotação de IP : em grandes volumes, alternar entre vários endereços IP evita que um único seja identificado e, posteriormente, bloqueado.
- Minimizar o número de consultas : recupera apenas as páginas de que realmente precisas. Menos pedidos significam menos carga no servidor e menos riscos de seres detetado.
- Manter a transparência : sempre que possível, indica uma endereço de e-mail de contacto no teu User-Agent. Desta forma, o administrador do site pode contactar-te em vez de te bloquear.
- Separar a extração e a gravação : primeiro recupera os dados e, em seguida, guarda-os num ficheiro CSV ou numa base de dados. Se o processamento falhar, não perdes os dados recolhidos.
- Utilizar seletores robustos : privilegia atributos estáveis, como eu ia Onde data-* em vez de classes CSS que mudam frequentemente. O teu script irá adaptar-se melhor às atualizações do site.
- Documentar o teu código : comenta as etapas-chave e assinala a data da tua recolha de dados. A estrutura de uma página vai mudando, e vais perceber mais depressa o que corrigir no dia em que algo deixar de funcionar.
Perguntas frequentes
Qual é a melhor estrutura para a recolha de dados da Web em Python?
Não existe um quadro único "melhor", porque tudo depende do complexidade do teu projeto.

- Para extracções simples, Requests e BeautifulSoup são mais do que suficientes.
- Quando um site utiliza muitos JavaScript, passa para Selenium Onde Playwright.
- Por fim, no caso de um projeto de grande envergadura, Scrapy continua a ser a opção mais adequada, graças ao seu desempenho e à sua estrutura robusta.
Como é que eu faço scrape de um sítio web em Python?
O processo baseia-se em três etapas principais :
- Envias uma Pedido HTTP para a página de destino.
- Estás a analisar a estrutura HTML recebida.
- Extrai os dados que te interessam e, em seguida, guardas-as.
Qual é o papel do "web scraper"?
a função de um web scraper consiste em percorrer automaticamente as páginas da Web para extrair dados específicos: textos, preços, imagens ou links. Funciona como um intermediário entre o site e tu, transformando a informação bruta em dados úteis.

Como utilizar o BeautifulSoup em Python?
BeautifulSoup é uma biblioteca concebida para analisar o código HTML de uma página e identificar facilmente as etiquetas que contêm as informações a extrair. Na prática, combina-se uma pedido HTTP com Requests, e depois analisas o conteúdo com BeautifulSoup para navegar pela estrutura e obter os dados pretendidos.
Como extrair dados de um site com conteúdo dinâmico em JavaScript?
Alguns sítios dependem fortemente de JavaScript para visualizar o seu conteúdo. Neste caso, as soluções clássicas, como Requests já não são suficientes. Por isso, tens de utilizar ferramentas capazes de simular um navegador real, como Selenium Onde Playwright, para carregar e interagir com a página.
Qual é a linguagem mais comum utilizada para a recolha de dados da Web?
Python é atualmente a linguagem mais popular para o web scraping, graças à sua simplicidade e à variedade das suas bibliotecas especializadas. Dito isto, também podes automatizar o’extração de dados com PHP, embora esta técnica continue a ser menos comum.
A raspagem da Web é legal?
o legalidade da recolha de dados na Web é uma questão complexa. Tudo depende da forma como o praticas, do respeito pelas condições de utilização dos sites e da natureza dos dados recolhidos. Em França, o web scraping é tolerado em certos casos, mas pode tornar-se ilegal se violar os direitos de acesso, as condições de utilização de um site ou a legislação relativa a dados pessoais.
Resumindo, o web scraping com Python abre um mundo de possibilidades incríveis! E tu, quais são as tuas experiências ou as tuas perguntas? Não hesites em partilhar nos comentários, estamos ansiosos por ler o que tens a dizer!








 PT