a raspagem da web, trata-se da automatização da recolha de dados em sítios Web. Um programa chamado scraper visita as páginas, lê-as código HTML e extrai as informações úteis: preços, contactos, opiniões ou conteúdo de artigos.
Eis como funciona, para que serve e como começar, com ou sem Python.
Web scraping: o que é isso?

Tudo começa com um programa automatizado chamado bot de web scraping.
Funciona como um utilizador da Internet, mas em grande escala e de forma automática. Concretamente, envia um pedido HTTP a uma página web, exatamente como se a abrisses no teu navegador, e depois analisa a estrutura do documento HTML ou XML para extrair os dados úteis.
O processo decorre em três grandes etapas :
- Recuperar a página : O scraper acede ao URL de destino, tal como um visitante normal.
- Análise da página : com a ajuda de um parser, ele analisa o código do site para identificar onde se encontram as informações relevantes.
- Extração de dados : recupera exatamente o que precisa, por exemplo, preços, títulos, opiniões ou moradas.
Os dados recolhidos são, em seguida, armazenados num ficheiro ou num base de dados. Consoante as necessidades, o formato pode ser uma folha de cálculo, um ficheiro CSV ou o JSON, pronto para análise.
Alguns sites apresentam o seu conteúdo diretamente no HTML: um scraper basta um método clássico para as analisar. Outras geram as suas informações através de JavaScript e só os carregam depois de a página ter sido aberta. Neste caso, é necessário um robô capaz de simular um navegador real para recolher os dados.
Porquê a raspagem da Web?
O web scraping não é apenas um artifício técnico. É uma verdadeira ferramenta estratégica para recolher dados em grande escala a partir de qualquer local. Automatizas a recolha de informações que, se fosse feita manualmente, levaria horas. Eis as utilizações mais comuns:
- Análise da concorrência : acompanhar os preços, as novidades e as promoções de um concorrente no seu site, sem intervenção manual. Ideal para a monitorização de tarifas no comércio eletrónico.
- Geração de contactos : recuperar automaticamente contactos específicos a partir de listas de contactos ou redes profissionais, respeitando o RGPD.
- Investigação académica ou estudo de mercado : reunir grandes volumes de dados para estudos sólidos, sem ter de clicar em todo o lado manualmente.
- Agregação de conteúdos : extrair informações de várias fontes e centralizá-las numa base de dados. É este o princípio das comparadores de preços e programas de indexação.
Em todos estes casos, a ideia continua a ser a mesma: ganhar tempo e obter uma base de dados utilizável, atualizada e pronta para análise.
Como é que faço a recolha de dados da Web?
Existem quatro percursos, consoante o teu nível: os software e ferramentas chave na mão, o codificado à medida, os extensões dos navegadores e dos agentes de IA.
1. Com ferramentas dedicadas de raspagem da Web
Muitos ferramentas de raspagem permitem-te recolher dados sem teres de começar do zero. Aqui estão três referências fiáveis.
- Bright Data : uma plataforma potente e completa, concebida para projetos de grande escala. Reúne proxies, APIs e recursos avançados adaptados a utilizações profissionais. Um scraper Quando está bem configurado nesta plataforma, pode recolher milhões de dados a partir de qualquer site.
- Octoparse : um dos programas mais acessíveis para quem está a dar os primeiros passos. A sua interface permite-te clicar nos elementos de uma página para definir o que pretendes extrair. Obténs um scraper a funcionar em poucos minutos, sem escrever uma única linha de código.
- Apify : uma plataforma de scripts prontos a usar, com a possibilidade de criares os teus próprios scrapers personalizados. Esta solução destina-se sobretudo a perfis técnicos e a casos complexos.

Se estás a começar ou se queres experimentar sem investir, a maioria destes programas oferece testes gratuitos ou fórmulas freemium, o suficiente para dar início ao teu scraper sem que seja necessário prever um orçamento desde o início.
2. Com conhecimentos de programação
Se tiveres conhecimentos básicos de programação, o raspagem personalizada da web oferece-te total liberdade. A linguagem mais utilizada é Python, graças à sua simplicidade e ao seu ecossistema rico em bibliotecas dedicadas. Uma biblioteca, neste contexto, é um conjunto de funcionalidades já programadas e reutilizáveis que podes integrar nos teus próprios scripts.
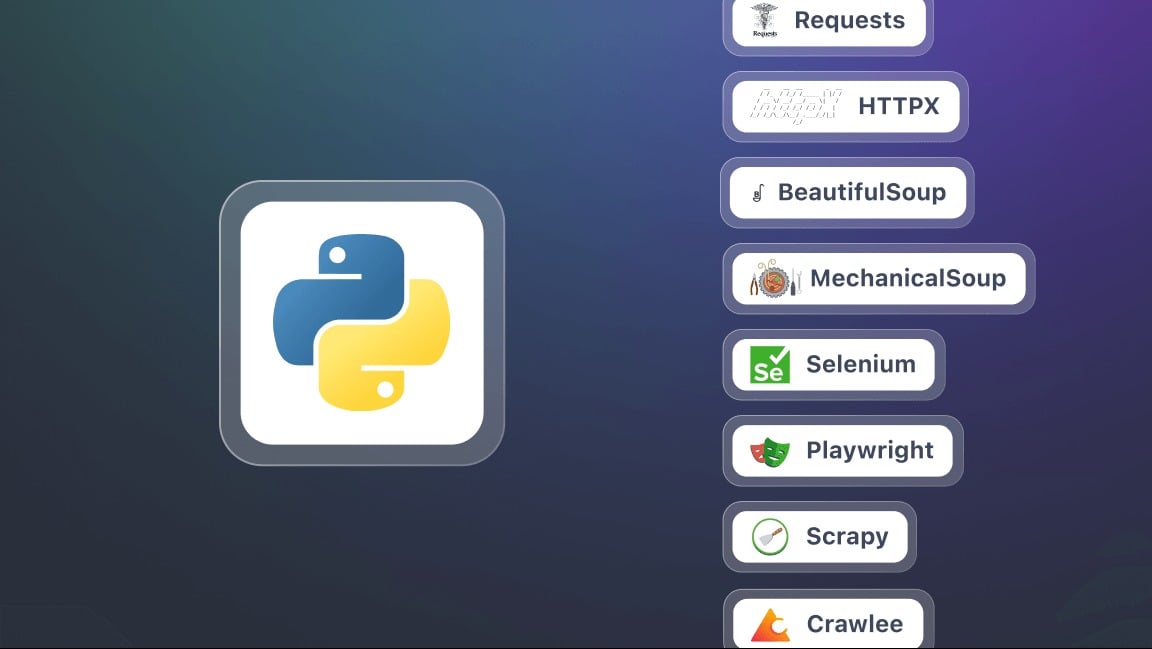
Entre as bibliotecas mais populares para recolha de dados da Web com Python:
- Scrapy : potente e versátil, ideal para projetos de grande envergadura.
- BeautifulSoup : analisa o código HTML e extrai os dados de uma página. Ideal para projetos simples.
- Selenium : um framework de automatização de navegadores disponível em várias linguagens, incluindo Python. Permite interagir com páginas web dinâmicas controladas por JavaScript.
Atenção: muitos sites modernos não carregam todo o seu conteúdo de uma só vez. Utilizam JavaScript Onde AJAX que apresentam os dados de forma progressiva. Neste caso, adota um navegador sem cabeça (« headless browser«), que carrega a página tal como um utilizador real o faria.
Python não é a única opção. Também podes fazer scraping em PHP com Guzzle para enviar os pedidos HTTP e Symfony DomCrawler para analisar o código HTML das páginas.
3. Com extensões do browser
Podes fazer web scraping diretamente a partir do teu navegador graças a extensões compatíveis com o Chrome, o Edge, o Firefox ou o Opera. Depois de as ativares, basta clicar nos elementos de uma página para selecionar e extrair os dados associados: títulos, preços ou imagens.
Não existe não é preciso programar. Tudo é feito através de uma interface gráfica. Com apenas alguns cliques, podes criar uma extração, pré-visualizá-la em tempo real e, em seguida, exportar os resultados para formatos comuns, como CSV, Excel ou JSON.
4. Com métodos avançados de raspagem da Web
O web scraping está a evoluir rapidamente e surgem novas técnicas. Entre elas, o web scraping com um agente LLM (Large Language Model).

Estes agentes inteligentes, baseados em modelos de linguagem avançados, são capazes de analisar a estrutura de um site de forma autónoma, compreender o seu conteúdo e extrair os dados relevantes, sem que seja necessário definir regras rígidas antecipadamente. Na prática, acede-se a elas através de ferramentas que combinam IA e automatização.
Perguntas frequentes
Como é que posso fazer web scraping com Python?
Web scraping com Python baseia-se em três passos simples :
- Recuperar a página : a biblioteca requests descarrega todo o código HTML da página de destino no site.
- Analisar o HTML : um analisador como BeautifulSoup analisa a estrutura do conteúdo e torna-o utilizável.
- Extração de dados : graças aos seletores HTML, consegues obter as informações úteis (títulos, preços, links).
Na prática, um script mínimo fica assim: importas requests e BeautifulSoup, fazes requests.get(url) para obter o código do site e, em seguida, soup.find_all(« h2 ») para selecionar os elementos pretendidos. Em poucas linhas, os teus scripts já recolhem dados de forma organizada e estruturada.
Por exemplo, no caso de um site dinâmico controlado por JavaScript, requests não basta. Nesse caso, tens de passar por Selenium, que automatiza um navegador real para carregar a página tal como um utilizador real e recolher todas as informações visíveis.
Como é que posso fazer scraping da Web sem ser bloqueado?
A maioria dos sites dispõe de mecanismos de proteção para limitar os abusos dos robôs. Para evitar ser bloqueado, segue estas boas práticas:
- Utilizar um API dedicada ao web scraping quando existe.
- Limitar o número de pedidos para não sobrecarregar o servidor do sítio.
- Recorrer a proxys para distribuir os endereços IP dos teus robôs.
- Definir um User-Agent um navegador adequado que imita um navegador real.
- Respeitar o ficheiro robots.txt do site, que indica aos robôs as páginas autorizadas.
Para projetos de grande escala, podes implementar os teus scrapers na nuvem. Serviços como AWS Lambda Onde EC2 permitem-lhe gerir a recolha de dados de forma escalável, com recursos adaptados ao volume.
Qual é a melhor ferramenta para a recolha de dados da Web?
Bright Data é uma das referências em matéria de scraping em grande escala. Esta plataforma disponibiliza uma rede de proxies residenciais, um centro de controlo avançado e uma gestão automatizada de captchas. Para uma utilização sem código, Octoparse é uma boa alternativa.
A melhor ferramenta depende, sobretudo, das tuas necessidades: volume de dados, orçamento e competências técnicas disponíveis.
É difícil aprender a fazer web scraping?
Tudo depende do método que escolheres:
- Com softwares sem código, como Octoparse, a aprendizagem continua a ser simples graças a uma interface do tipo «apontar e clicar». Bright Data também disponibiliza scrapers prontos a utilizar, mas destina-se sobretudo a equipas técnicas.
- Com a programação, por exemplo, em Python ou em PHP, são necessários conhecimentos técnicos. A curva de aprendizagem é mais longa, mas ganhas em flexibilidade para analisar qualquer site.
Qual é a diferença entre Web scraping e APIs?
- a raspagem da web extraia os dados do código HTML de uma página web. Simula a navegação humana para recolher as informações visíveis num site.
- A API (Interface de Programação de Aplicações) permite o acesso direto aos dados estruturados do site. É mais fiável e mais simples, sem ser necessário analisar o código HTML.

O web scraping torna-se especialmente útil quando o site não disponibiliza um’API pública. Neste caso, um scraper permite-te recolher os dados diretamente das páginas.
A raspagem da Web é legal?
A legalidade da raspagem da Web depende do contexto e do tipo de dados visados.
Principais regulamentos
Na Europa, o RGPD (Regulamento Geral sobre a Proteção de Dados) regulamenta rigorosamente a utilização dos dados pessoais. A recolha de dados pessoais num site sem uma base jurídica válida (consentimento ou interesse legítimo, sob condições rigorosas) é ilegal.
o proteção de dados A satisfação dos utilizadores continua a ser uma prioridade em qualquer projeto de scraping.
Dados públicos: não é um aval automático
Os dados não pessoais As informações de acesso livre (preços, horários) podem, em geral, ser recolhidas, sujeitas aos Termos e Condições de Utilização do site e à legislação relativa às bases de dados.
Sempre que um dado permita identificar uma pessoa, mesmo que seja uma figura pública, o RGPD aplica-se.
Condições de legalidade
O scraping é legal quando respeita os Termos e Condições de Utilização do site, os direitos de autor, os direitos relativos às bases de dados e o RGPD. O assédio e a violação da propriedade intelectual continuam a ser proibidos.
Em suma, o web scraping permite-te extrair dados quando não existe nenhuma API disponível. Existem vários métodos, desde o script Python ao software sem código.
Mantenha-se sempre dentro do quadro legal: cumpra os Termos e Condições de Utilização do site, faça uma utilização razoável e respeite o RGPD.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA