the ウェブスクレイピング, 、とは、データの収集を自動化することです。 データ ウェブサイト上で。あるプログラムは scraper ページを見て、その内容を HTMLコード そして、価格、連絡先、口コミ、記事の内容など、役立つ情報を抽出します。.
その仕組み、用途、そして「~の有無にかかわらず」始める方法についてご紹介します。 パイソン.
ウェブスクレイピング:それは何ですか?

すべては、次のような自動化プログラムから始まります。 ウェブスクレイピング用ボット. インターネットユーザーのように振る舞うが、その規模ははるかに大きい はしご しかも自動的に。具体的には、次のような HTTPリクエスト Webページにアクセスし、まるでブラウザで開いたかのように、HTMLやXMLドキュメントの構造を解析して、有用なデータを抽出します。.
このプロセスは次のように行われます 3つの大きな段階 :
- ページの取得 : ザ scraper 通常の訪問者と同様に、対象のURLにアクセスします。.
- ページ分析 : を使って parser, 、彼はサイトのソースコードを読み、興味深い情報がどこにあるかを探し出す。.
- データ抽出 : 必要な情報、例えば価格、タイトル、レビュー、住所などを正確に取得します。.
収集されたデータは、その後、ファイルまたは データベース. 必要に応じて、形式はスプレッドシートやファイルなど シーエスブイ または JSON, 、分析の準備が整いました。.
一部のサイトでは、コンテンツをHTML内に直接記述しています:例えば scraper これらを分析するには、従来の方法だけで十分です。また、他のものは以下の方法を通じて情報を生成します。 ジャバスクリプト そして、ページが開いてからそれらを読み込みます。この場合、データを収集するには、実際のブラウザをシミュレートできるロボットが必要となります。.
なぜウェブスクレイピングなのか?
ウェブスクレイピングは単なる技術的な小手先の手法ではありません。それはまさに 戦略ツール あらゆる場所から大規模なデータを収集するためです。手作業では何時間もかかってしまう情報の収集を自動化できます。主な用途は以下の通りです:
- 競合分析 : 競合他社のウェブサイト上の価格、新商品、セール情報を、手動操作なしで追跡する。以下に最適です。 料金動向 Eコマースにおいて。.
- リードジェネレーション : 電話帳やビジネスネットワークから、ターゲットとなる連絡先を自動的に取得する。.
- 学術研究または市場調査 : 手作業であちこちクリックすることなく、確かな研究のために大量のデータを収集する。.
- コンテンツ・アグリゲーション : 複数の情報源から情報を抽出し、それらをデータベースに集約すること。これが 価格比較サイト およびインデックス作成用ソフトウェア。.
いずれの場合も、その考え方は同じです。つまり、 時間 そして、実用可能で最新の状態にあり、分析にすぐ活用できるデータベースを構築する。.
ウェブスクレイピングはどうすればいいのですか?
レベルに応じて3つのコースがあります: すぐに使えるソフトウェアとツール、 カスタムコード そしてその ブラウザ拡張機能. 選び方と始め方をご紹介します。.
1.ウェブスクレイピング専用ツール
多数 スクレイピングツール これらを活用すれば、一から始めることなくデータを収集できます。ここでは、信頼できる3つの参考資料をご紹介します。.
- Bright Data : 大規模プロジェクト向けに設計された、強力かつ包括的なプラットフォームです。これには、 代理人, 、プロ向けの用途に合わせたAPIや高度なリソース。 scraper このプラットフォームで適切に設定されていれば、あらゆるサイトから数百万件ものデータを収集することができます。.
- Octoparse : 初心者にとって最も使いやすいソフトウェアの一つです。そのインターフェースでは、ページ上の要素をクリックするだけで、抽出したい内容を指定できます。その結果、 scraper コードを1行も書かずに、わずか数分で動作するようになります。.
- Apify :すぐに使えるスクリプトのマーケットプレイスで、独自のスクレイパーを作成することも可能です。このソリューションは、主に技術的な知識を持つユーザーや複雑なケースを対象としています。.

初心者の方や、費用をかけずに試してみたいという方には、こうしたソフトウェアのほとんどが 無料体験 あるいは数式 フリーミアム, 、これで君の scraper 当初から予算を見込む必要がない。.
2.プログラミングスキル
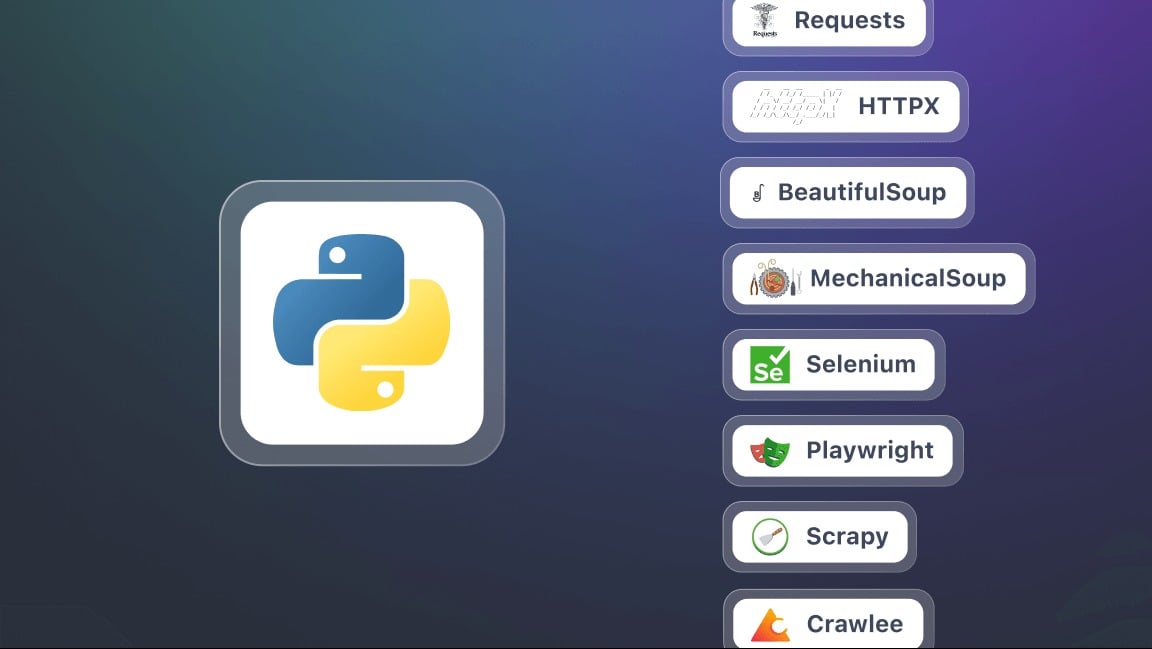
プログラミングの基礎知識があれば、 カスタムウェブスクレイピング 完全な自由をもたらします。最もよく使われる言語は Python, 、そのシンプルさと、専用のライブラリが充実しているエコシステムのおかげで。ここでいうライブラリとは、すでにコーディング済みで再利用可能な機能の集合体であり、これを自分のスクリプトに組み込むことができます。.
のための最も人気のあるライブラリの一つである。 Pythonでウェブスクレイピング:
- Scrapy : パワフルで柔軟性が高く、大規模なプロジェクトに最適です。.
- BeautifulSoup : HTMLコードを解析し、ページからデータを抽出します。シンプルなプロジェクトに最適です。.
- Selenium : Pythonをはじめとする複数の言語で利用可能なブラウザ自動化フレームワーク。JavaScriptによって制御される動的なWebページとやり取りを行うことができます。.
注意:最近の多くのウェブサイトでは、コンテンツを一度にすべて読み込まない場合があります。それらは ジャバスクリプト どこ AJAX データを段階的に表示するもの。この場合、次のような ヘッドレスブラウザ (“headless browser“)、これは実際のユーザーと同じようにページを読み込みます。.
Python それだけではない。他にも、 PHPでのスクレイピング 図書館と Goutte どこ Guzzle, 、これらはHTTPリクエストを送信し、サイトのHTMLページを簡単に解析することができます。.
3.ブラウザ拡張機能
ウェブスクレイピングができるよ ブラウザから直接 Chrome、Edge、Firefox、Operaに対応した拡張機能を利用します。有効にしたら、ページ上の要素をクリックして、関連するデータ(タイトル、価格、画像など)を選択・抽出できます。.
ない コーディングの必要はありません. すべてがグラフィカルインターフェースを通じて行われます。数回のクリックで抽出を作成し、リアルタイムでプレビューした後、結果を次のような一般的な形式でエクスポートできます。 CSV、Excel、またはJSON.
4.高度なウェブスクレイピング手法
ウェブスクレイピングは急速に進化しており、新しい手法が登場しています。その中でも、 LLMエージェントを用いたウェブスクレイピング (Large Language Model).

これらのインテリジェントエージェントは、 高度な言語モデル, は、あらかじめ厳格なルールを定義することなく、自律的にウェブサイトの構造を分析し、その内容を理解し、関連するデータを抽出することができます。実際には、以下の機能を組み合わせたツールを通じてこれを利用します。 AIとオートメーション.
よくある質問
PythonでWebスクレイピングをするには?
ウェブスクレイピングを Python …に基づいている 3つの簡単なステップ :
- ページを復元する : 図書館 requests サイト上の対象ページのHTMLコードをすべてダウンロードします。.
- HTMLを解析する : 次のようなパーサー BeautifulSoup コンテンツの構造を読み取り、活用可能な形に変換します。.
- データの抽出 : HTMLセレクタを使えば、必要な情報(タイトル、価格、リンク)を取得できます。.
具体的には、最小限のスクリプトは次のようなものになります:次のようにインポートします requests と BeautifulSoup, 、君は requests.get(url) サイトのコードを取得するには、まず soup.find_all(“h2”) 目的の要素を特定するために。ほんの数行のコードで、スクリプトはすでに整理された構造的な形でデータを収集できるようになります。.
例えば、次のような動的サイトの場合、 ジャバスクリプト, requests だけでは不十分だ。そこで、次の手順を踏むことになる。 Selenium, 、これは実際のブラウザを自動化して、実際のユーザーと同様にページを読み込み、表示されているすべての情報を収集するものです。.
ブロックされずにウェブスクレイピングをするには?
ほとんどのサイトには 保護メカニズム ボットによる悪用を防ぐためです。アカウントがブロックされないように、以下のベストプラクティスに従ってください:
- を使用する。 ウェブスクレイピング専用のAPI 存在する場合。.
- リクエスト数を制限する サイトサーバーに過負荷をかけないように。
- ~を経由して プロキシ ボットのIPアドレスを割り当てるために。.
- を定義する。 User-Agent 本物のブラウザを模した、適切なブラウザ。.
- ファイルを尊重する robots.txt サイトの、ロボットに対してアクセスが許可されているページを指定する部分。.
大規模なプロジェクトの場合は、スクレイパーをクラウド上に展開することができます。以下のようなサービスが利用できます。 AWS Lambda どこ EC2 これにより、データ収集をスケーラブルに管理でき、データ量に応じたリソースを割り当てることができます。.
ウェブスクレイピングに最適なツールは?
Bright Data 大規模なスクレイピングの定番ツールの一つです。このソフトウェアは、 住宅用プロキシネットワーク, 、高度な制御センター、およびキャプチャの自動管理。コーディング不要で利用するには、, Octoparse は良い選択肢です。どのツールが最適かは、主にあなたのニーズ次第です: データ量, 、予算、および利用可能な技術的スキル。.
ウェブスクレイピングを学ぶのは難しいですか?
それは、どの方法を選ぶかによって異なります:
- と ノーコードソフトウェア なので Bright Data どこ Octoparse, 、操作は簡単です。これらのプラットフォームは、ポイント&クリック式のインターフェースを採用しており、初心者向けに設計されています。.
- ~とともに プログラミング, 、例えばPythonやPHPなどでは、技術的な知識が必要になります。習得には時間がかかりますが、どんなサイトでも分析できる柔軟性が得られます。.
ウェブスクレイピングとAPIの違いは何ですか?
- the ウェブスクレイピング ウェブページのHTMLコードからデータを抽出します。人間の操作をシミュレートして、サイト上に表示されている情報を収集します。.
- あ API (アプリケーション・プログラミング・インターフェース)により、サイトの構造化されたデータに直接アクセスできます。HTMLコードを解析する必要がないため、より信頼性が高く、簡単です。.

ウェブスクレイピングは、特にそのサイトが’公開API. この場合、ある scraper ページから直接データを収集することができます。.
ウェブスクレイピングは合法か?
ウェブスクレイピングの合法性は、文脈と対象となるデータの種類によって異なる。
主要規制
ヨーロッパでは RGPD (一般データ保護規則)は、以下の利用について厳格に規制しており、 個人データ. 同意なしにウェブサイト上で個人情報を収集することは違法です。その データ保護 ユーザーの利便性は、あらゆるスクレイピングプロジェクトにおいて最優先事項である。.
オープンデータの原則
The 公開データ 通常、収集可能な情報には、運行時刻、運賃、公示情報などがあります。個人情報や保護対象となるデータについては、引き続き制限が適用されます。.
合法性の条件
データが以下の条件を満たす場合、スクレイピングは合法です。 公開 かつ、乱用せずに使用すること。ハラスメントや 知的財産権の侵害, 、これらは依然として禁止されている。その RGPD 自然人に関する個人を特定できる情報を収集した時点で適用されます。.
要するに、ウェブスクレイピングを使えば、APIが利用できない場合でもデータを抽出することができます。その方法にはいくつかあり、例えば Pythonスクリプト ノーコードソフトウェアについて。常に法的枠組みの範囲内にとどまること:公共データ、合理的な利用、および RGPD.








 日本語