itu pengikisan web, yaitu otomatisasi pengumpulan data di situs web. Sebuah program bernama scraper kunjungi halaman-halaman tersebut, baca isinya kode HTML dan mengekstrak informasi yang berguna: harga, kontak, ulasan, atau isi artikel.
Berikut ini cara kerjanya, kegunaannya, dan cara memulainya, baik dengan maupun tanpa Python.
Web scraping: apa itu?

Semuanya dimulai dengan sebuah program otomatis yang bernama bot pengikis web.
Sistem ini bekerja layaknya seorang pengguna internet, namun dalam skala besar dan secara otomatis. Secara konkret, sistem ini mengirimkan permintaan HTTP ke sebuah halaman web, persis seperti saat kamu membukanya di perambanmu, lalu menganalisis struktur dokumen HTML atau XML untuk mengekstrak data yang berguna.
Proses tersebut berlangsung dalam tiga tahap utama :
- Mengambil halaman yang scraper mengakses URL tujuan, seperti pengunjung pada umumnya.
- Analisis halaman : dengan menggunakan sebuah parser, ia membaca kode situs tersebut untuk mencari di mana letak informasi yang menarik.
- Ekstraksi data : ia mengambil tepat apa yang dibutuhkannya, misalnya harga, judul, ulasan, atau alamat.
Data yang dikumpulkan kemudian disimpan dalam sebuah berkas atau sebuah basis data. Tergantung kebutuhannya, formatnya bisa berupa lembar kerja, berkas CSV atau JSON, siap untuk dianalisis.
Beberapa situs menampilkan kontennya langsung dalam kode HTML: sebuah scraper metode klasik sudah cukup untuk menganalisisnya. Ada pula yang menghasilkan informasinya melalui JavaScript dan baru memuatnya setelah halaman terbuka. Dalam hal ini, diperlukan robot yang mampu mensimulasikan peramban sungguhan untuk mengumpulkan data.
Mengapa web scraping?
Web scraping bukan sekadar trik teknis. Ini adalah hal yang sesungguhnya alat strategis untuk mengumpulkan data dalam skala besar dari lokasi mana pun. Kamu dapat mengotomatiskan pengumpulan informasi yang jika dilakukan secara manual akan memakan waktu berjam-jam. Berikut ini adalah kegunaan yang paling umum:
- Analisis kompetitif : memantau harga, produk baru, dan penawaran promosi dari pesaing di situs webnya, tanpa perlu campur tangan manual. Cocok untuk pemantauan tarif di bidang e-commerce.
- Generasi pemimpin : secara otomatis mengimpor kontak yang ditargetkan dari direktori atau jaringan profesional, dengan tetap mematuhi RGPD.
- Penelitian akademis atau riset pasar : mengumpulkan data dalam jumlah besar untuk penelitian yang solid, tanpa harus mengklik sana-sini secara manual.
- Agregasi konten : mengekstrak informasi dari berbagai sumber dan mengumpulkannya ke dalam sebuah basis data. Inilah prinsip dari perbandingan harga dan perangkat lunak pengindeksan.
Dalam semua kasus ini, intinya tetap sama: menghemat waktu dan memperoleh basis data yang dapat dimanfaatkan, selalu terkini, dan siap untuk dianalisis.
Bagaimana cara melakukan web scraping?
Tersedia empat jalur sesuai dengan tingkat kemahiranmu: yaitu perangkat lunak dan alat siap pakai, kode yang disesuaikan, yaitu ekstensi peramban dan agen AI.
1. 1. Dengan alat bantu scraping web khusus
Banyak alat pengikis memungkinkan Anda mengumpulkan data tanpa harus memulai dari nol. Berikut ini tiga referensi yang dapat diandalkan.
- Bright Data : sebuah platform yang kuat dan lengkap, dirancang khusus untuk proyek berskala besar. Platform ini menggabungkan proxy, API, dan sumber daya tingkat lanjut yang dirancang khusus untuk penggunaan profesional. Sebuah scraper Jika dikonfigurasi dengan benar di platform ini, sistem ini dapat mengumpulkan jutaan data dari situs mana pun.
- Octoparse : salah satu perangkat lunak yang paling mudah digunakan bagi pemula. Antarmukanya memungkinkanmu mengklik elemen-elemen pada sebuah halaman untuk menentukan apa yang ingin kamu ekstrak. Kamu akan mendapatkan sebuah scraper Siap digunakan dalam hitungan menit, tanpa perlu menulis satu baris kode pun.
- Apify : sebuah pasar skrip siap pakai, dengan kemampuan untuk membuat scraper kustommu sendiri. Solusi ini terutama ditujukan bagi para pengguna dengan latar belakang teknis dan untuk kasus-kasus yang kompleks.

Jika kamu baru memulai atau ingin mencobanya tanpa harus mengeluarkan biaya, sebagian besar perangkat lunak ini menawarkan uji coba gratis atau rumus-rumus freemium, cukup untuk memulai scraper tanpa perlu mengalokasikan anggaran sejak awal.
2. 2. Dengan keterampilan pemrograman
Jika kamu sudah memiliki dasar-dasar pemrograman, maka pengikisan web khusus memberimu kebebasan penuh. Bahasa yang paling sering digunakan adalah Python, berkat kesederhanaannya dan ekosistemnya yang kaya akan pustaka khusus. Yang dimaksud dengan pustaka di sini adalah kumpulan fitur yang telah diprogram dan dapat digunakan kembali, yang dapat kamu integrasikan ke dalam skripmu sendiri.
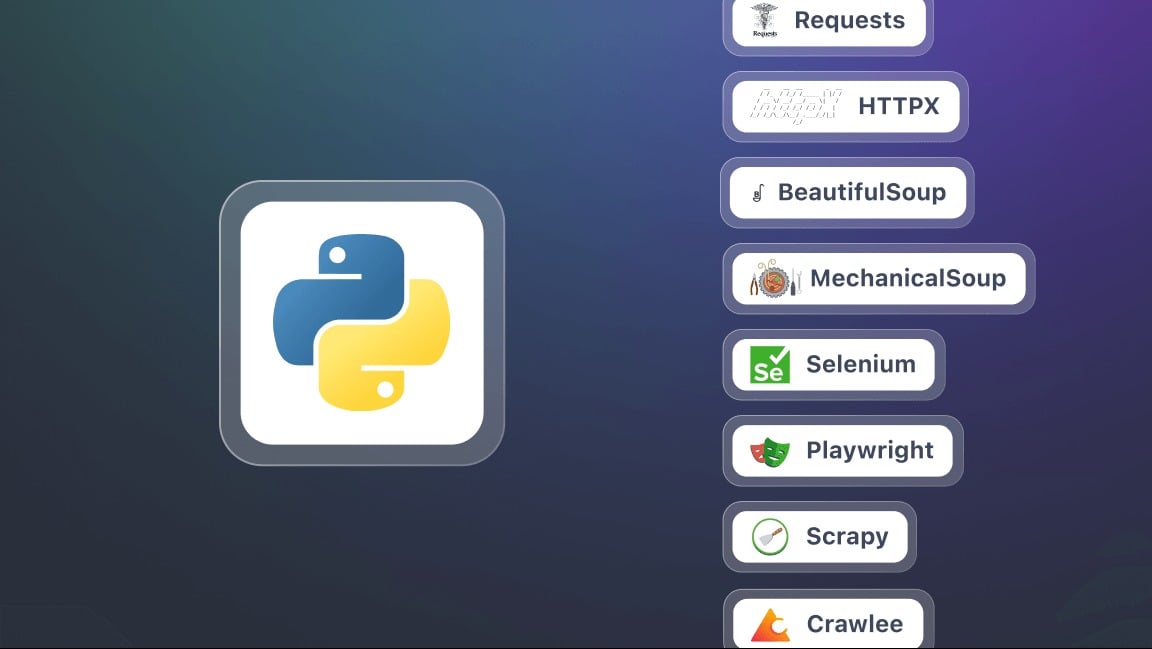
Di antara perpustakaan yang paling populer untuk scraping web dengan Python:
- Scrapy : bertenaga dan fleksibel, sangat cocok untuk proyek berskala besar.
- BeautifulSoup : menganalisis kode HTML dan mengekstrak data dari sebuah halaman. Cocok sekali untuk proyek-proyek sederhana.
- Selenium : sebuah kerangka kerja otomatisasi peramban yang tersedia dalam berbagai bahasa pemrograman, termasuk Python. Kerangka kerja ini memungkinkan pengguna untuk berinteraksi dengan halaman web dinamis yang dijalankan oleh JavaScript.
Perhatian: banyak situs modern tidak memuat seluruh kontennya sekaligus. Mereka menggunakan JavaScript Di mana AJAX yang menampilkan data secara bertahap. Dalam hal ini, gunakan browser tanpa antarmuka pengguna (« headless browser« ), yang memuat halaman seperti yang dilakukan oleh pengguna sungguhan.
Python bukan satu-satunya pilihan. Kamu juga bisa melakukan scraping dengan PHP dengan Guzzle untuk mengirimkan permintaan HTTP dan Symfony DomCrawler untuk menganalisis kode HTML halaman-halaman tersebut.
3. Dengan ekstensi browser
Kamu bisa melakukan web scraping langsung dari browser-mu berkat ekstensi yang kompatibel dengan Chrome, Edge, Firefox, atau Opera. Setelah diaktifkan, kamu cukup mengklik elemen-elemen pada halaman untuk memilih dan mengekstrak data yang terkait: judul, harga, atau gambar.
Tidak ada tidak perlu menulis kode. Semuanya dilakukan melalui antarmuka grafis. Hanya dengan beberapa klik, kamu bisa membuat ekstraksi, melihat pratinjaunya secara real-time, lalu mengekspor hasilnya ke format-format umum seperti CSV, Excel, atau JSON.
4. Dengan metode pengikisan web tingkat lanjut
Web scraping berkembang pesat dan teknik-teknik baru terus bermunculan. Di antaranya, web scraping menggunakan agen LLM (Large Language Model).

Agen-agen cerdas ini, yang didasarkan pada model bahasa tingkat lanjut, mampu menganalisis struktur sebuah situs secara mandiri, memahami isinya, dan mengekstrak data yang relevan, tanpa perlu menetapkan aturan ketat terlebih dahulu. Dalam praktiknya, kamu dapat mengaksesnya melalui alat-alat yang menggabungkan AI dan otomatisasi.
FAQ
Bagaimana cara melakukan web scraping dengan Python?
Web scraping dengan Python berdasarkan tiga langkah sederhana :
- Memuat ulang halaman : perpustakaan requests mengunduh seluruh kode HTML dari halaman yang dituju di situs tersebut.
- Menganalisis HTML : sebuah parser seperti BeautifulSoup membaca struktur konten dan membuatnya dapat dimanfaatkan.
- Mengekstrak data : berkat selektor HTML, kamu bisa mengambil informasi yang berguna (judul, harga, tautan).
Secara konkret, skrip minimalnya terlihat seperti ini: kamu mengimpor requests dan BeautifulSoup, kamu melakukan requests.get(url) untuk mendapatkan kode situs, lalu soup.find_all(« h2 ») untuk memilih elemen yang diinginkan. Hanya dengan beberapa baris kode, skripmu sudah dapat mengumpulkan data dengan rapi dan terstruktur.
Misalnya, untuk sebuah situs dinamis yang digerakkan oleh JavaScript, requests itu saja tidak cukup. Maka, kamu harus melalui Selenium, yang mengotomatiskan browser sungguhan untuk memuat halaman seperti pengguna sungguhan dan mengumpulkan semua informasi yang terlihat.
Bagaimana cara melakukan web scraping tanpa diblokir?
Sebagian besar situs memiliki mekanisme perlindungan untuk membatasi penyalahgunaan bot. Agar akunmu tidak diblokir, ikuti panduan berikut ini:
- Gunakan API khusus untuk web scraping jika memang ada.
- Batasi jumlah permintaan agar tidak membebani server situs.
- Melalui proxy untuk membagi-bagikan alamat IP robot-robotmu.
- Tentukan a User-Agent yang benar dan menyerupai peramban sungguhan.
- Patuhi berkas tersebut robots.txt dari situs tersebut, yang memberi tahu robot halaman-halaman yang diizinkan.
Untuk proyek berskala besar, kamu bisa menjalankan scraper-mu di cloud. Layanan seperti AWS Lambda Di mana EC2 memungkinkan Anda mengelola pengumpulan data secara skalabel, dengan sumber daya yang disesuaikan dengan volumenya.
Apa alat terbaik untuk web scraping?
Bright Data merupakan salah satu rujukan utama untuk scraping skala besar. Platform ini menawarkan jaringan proksi residensial, pusat kendali canggih dan pengelolaan captcha otomatis. Untuk penggunaan tanpa perlu menulis kode, Octoparse merupakan alternatif yang baik.
Alat yang paling tepat sangat bergantung pada kebutuhanmu: volume data, anggaran, dan kompetensi teknis yang tersedia.
Apakah web scraping sulit dipelajari?
Semuanya tergantung pada metode yang kamu pilih:
- Dengan perangkat lunak tanpa kode seperti Octoparse, proses belajar tetap mudah berkat antarmuka yang menggunakan sistem klik dan pilih. Bright Data juga menawarkan scraper yang siap pakai, namun lebih ditujukan untuk tim teknis.
- Dengan pemrograman, misalnya dalam Python atau PHP, diperlukan pengetahuan teknis. Proses belajarnya memang lebih lama, tetapi kamu akan mendapatkan fleksibilitas yang lebih besar untuk menganalisis situs mana pun.
Apa perbedaan antara web scraping dan API?
- itu pengikisan web mengekstrak data dari kode HTML sebuah halaman web. Alat ini mensimulasikan navigasi manusia untuk mengumpulkan informasi yang terlihat di sebuah situs.
- A API (Antarmuka Pemrograman Aplikasi) memberikan akses langsung ke data terstruktur di situs tersebut. Cara ini lebih andal dan lebih mudah, tanpa perlu menganalisis kode HTML.

Web scraping menjadi sangat berguna terutama ketika situs tersebut tidak menyediakan’API Publik. Dalam hal ini, sebuah scraper memungkinkan Anda mengumpulkan data langsung dari halaman-halaman tersebut.
Apakah web scraping legal?
Legalitas web scraping tergantung pada konteks dan jenis data yang ditargetkan.
Peraturan utama
Di Eropa, sistem RGPD (Peraturan Umum tentang Perlindungan Data) mengatur secara ketat penggunaan data pribadi. Mengumpulkan data pribadi di sebuah situs web tanpa dasar hukum yang sah (persetujuan atau kepentingan sah, dengan syarat-syarat yang ketat) adalah ilegal.
Itu perlindungan data Kepuasan pengguna tetap menjadi prioritas utama dalam setiap proyek scraping.
Data publik: bukan berarti otomatis mendapat lampu hijau
Data bukan pribadi Informasi yang dapat diakses secara bebas (harga, jadwal) umumnya dapat dikumpulkan, dengan tetap tunduk pada Ketentuan Penggunaan Situs dan undang-undang tentang basis data.
Begitu suatu data memungkinkan identifikasi seseorang, sekalipun tokoh publik, maka RGPD berlaku.
Ketentuan legalitas
Scraping dianggap sah jika mematuhi Ketentuan Penggunaan Situs, hak cipta, hak atas basis data, dan RGPD. Pelecehan dan pelanggaran hak kekayaan intelektual tetap dilarang.
Singkatnya, web scraping memungkinkanmu mengekstrak data ketika tidak ada API yang tersedia. Ada beberapa metode yang dapat digunakan, mulai dari skrip Python perangkat lunak tanpa kode.
Selalu patuhi ketentuan hukum: patuhi Ketentuan Penggunaan Situs, gunakan secara wajar, dan patuhi RGPD.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA