Untuk membuat bot pengikis web, kamu perlu Python, dari perpustakaan Requests untuk mengambil halaman-halaman tersebut dan BeautifulSoup untuk mengekstrak datanya.
Panduan ini menunjukkan kepadamu cara menyusun skrip yang berfungsi dalam 5 langkah. Bot web scraping adalah program otomatis yang mengumpulkan data di internet dari berbagai situs web: program ini menjelajahi halaman-halaman, mengekstrak informasi yang berguna, dan menyimpannya untuk digunakan di kemudian hari.
Sebelum meluncurkan bot-mu, pastikan untuk memeriksa berkas tersebut robots.txt situs tujuan untuk mengetahui halaman mana saja yang boleh kamu kunjungi.

Persyaratan untuk membuat bot scraping web
Hal pertama yang harus kamu pilih adalah bahasa pemrograman. Hal itulah yang menentukan alat-alat yang tersedia dan kemudahan pelaksanaannya.
- Python : bahasa pemrograman yang paling populer untuk web scraping. Bahasa ini mudah dipelajari dan memiliki ekosistem pustaka yang sangat lengkap untuk mengekstrak data.
- Node.js : sangat cocok untuk tugas-tugas asinkron, dengan alat-alat yang sudah sangat matang (Puppeteer, Playwright) untuk mengekstrak data dari situs dinamis yang menggunakan JavaScript.
- Bahasa lain : untuk beberapa proyek, kamu juga bisa memanfaatkan web scraping dengan PHP.
Setelah memilih bahasa, kamu perlu yang tepat perpustakaan. Justru merekalah yang benar-benar melakukan pekerjaan itu. Berikut ini yang paling berguna sesuai dengan lingkungannya.
Untuk Python :
- Requests : mengirimkan Permintaan HTTP untuk mengambil konten dari sebuah halaman.
- BeautifulSoup : mengurai HTML dan memungkinkan pengambilan informasi yang berguna (teks, harga, tautan, gambar).
- Scrapy : sebuah kerangka kerja lengkap untuk proyek-proyek scraping yang lebih ambisius, dengan pengelolaan permintaan dalam skala besar.
Untuk Node.js :
- Axios Di mana Fetch : untuk mengirimkan permintaan HTTP.
- Cheerio : setara dengan BeautifulSoup, sangat praktis untuk menjelajahi dan memanipulasi DOM.
- Puppeteer Di mana Playwright : sangat penting untuk melakukan scraping pada situs dinamis. Alat ini mengendalikan browser sungguhan dan menjalankan kode JavaScript dari halaman tersebut.
Tutorial untuk membuat bot scraping web
Membuat bot scraping mungkin tampak rumit, tetapi pada praktiknya hal ini sangat mudah dilakukan. Dengan mengikuti langkah-langkah berikut ini 5 langkah, Anda akan mendapatkan skrip yang berfungsi untuk mengumpulkan data dari web. Pastikan Anda telah menginstal Python dan pustaka-pustaka yang diperlukan sebelum memulai.
Langkah 1: Menganalisis situs target
Sebelum mulai menulis kode apa pun, kamu harus tahu di mana letak data pada halaman tersebut. Langkah ini’analisis menentukan segala hal lainnya.
- Buka situs tujuan di perambanmu.
- Klik kanan, lalu pilih Memeriksa pada bagian yang kamu minati.
- Temukan tag HTML, kelas, atau ID yang berisi konten yang akan diekstraksi (misalnya
.product,.title,.harga). - Coba tesmu Pemilih CSS di konsol. Jika judul produk berada di dalam tag
<h2>, kamu akan menggunakan kembali selektor ini dalam kode kamu.
Langkah 2: Mengirim permintaan HTTP
Bot-mu berperilaku seperti peramban: ia mengirimkan sebuah Permintaan HTTP ke server, yang kemudian mengembalikan kode HTML halaman tersebut. Itulah fungsi dari pustaka tersebut Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # kesalahan jika kode 4xx atau 5xx
html = resp.text
print(html[:500])  # cuplikan
Langkah 3: Mengurai konten HTML
Setelah halaman dimuat, kamu harus mengubah HTML mentah tersebut menjadi objek yang dapat dimanipulasi. Ini adalah tugas dari BeautifulSoup, pustaka referensi untuk mengekstrak data dari HTML.
# pip install beautifulsoup4
dari bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

produk = sup.select(".product")
print(f "Produk ditemukan : {len(produk)}")

for p in products[:3]:
    judul = p.select_one("h2.judul").get_text(strip=True)
    harga = p.select_one(".harga").get_text(strip=True)
    link = p.select_one("a")["href"]
    print({"judul": judul, "harga": harga, "tautan": tautan})
Langkah 4: Ekstrak data
Ini adalah langkah yang paling konkret: pergi untuk mengambil informasi yang akurat seperti judul, harga, dan tautan. Kamu juga bisa membersihkannya sekaligus, misalnya dengan mengonversi sebuah harga teks berdasarkan jumlah.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Langkah 5: Mencadangkan data
Agar hasilmu tidak hilang, simpanlah dalam sebuah berkas. Dua format yang paling umum adalah CSV (lembar kerja) dan JSON (sangat cocok untuk menyuplai basis data atau sebuah API).
impor csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
with open("export/products.csv", "w", newline="", encoding="utf-8") as f:
    fields = ["judul", "harga", "url"]
    penulis = csv.DictWriter(f, nama_field = fields, pembatas = ";")
    penulis.writeheader()
    penulis.tulisbagian(data)

JSON #
dengan open("export/products.json", "w", encoding="utf-8") sebagai f:
    json.dump(data, f, ensure_ascii = False, indent = 2)

print("Ekspor selesai!")
Kini kamu memiliki bot scraping yang lengkap: bot ini mengirimkan permintaan, mengurai kode HTML, mengekstrak konten, dan menyimpan data ke dalam berkas CSV atau JSON. Ini merupakan landasan yang kokoh untuk mengotomatiskan pengumpulan data di sebagian besar situs statis.
Bagaimana cara mengelola perlindungan anti-scraping?
Situs web menerapkan beberapa mekanisme untuk melindungi data mereka melawan bot. Memahami langkah-langkah perlindungan ini sangat penting agar kamu bisa melakukan scraping secara bertanggung jawab dan menghindari pemblokiran.
Berkas robots.txt
itu file robots.txt menunjukkan halaman mana saja yang boleh atau tidak boleh dijelajahi oleh bot di sebuah situs. Perhatian: ini mengontrol crawl, bukan pengindeksan, dan kepatuhannya bergantung pada itikad baik para robot.
Selalu periksa berkas ini sebelum menjalankan scraper-mu. Mematuhi aturan ini dapat mengurangi risiko, tetapi tidak cukup untuk membuat pengumpulan datamu sah: kondisi penggunaan situs web dan RGPD juga berlaku.
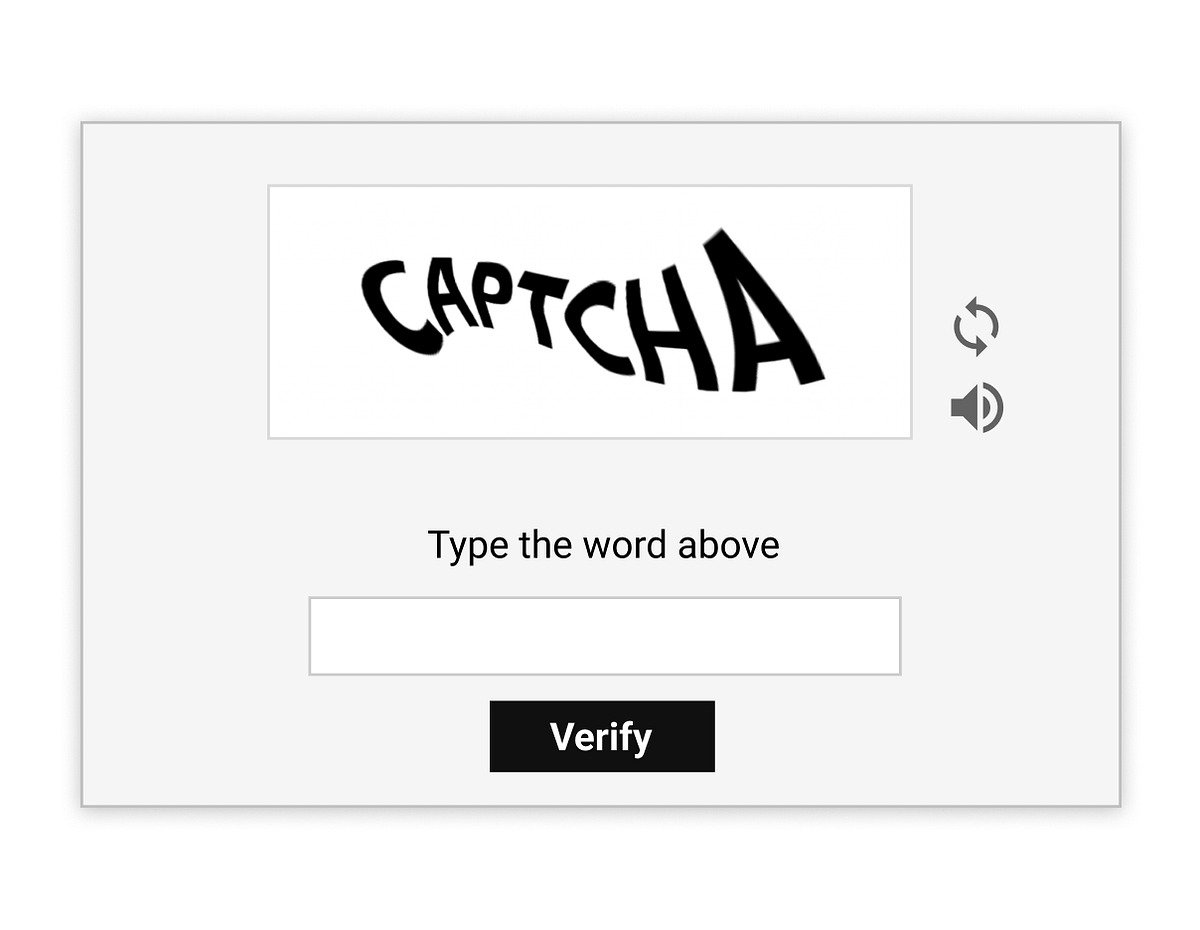
Captcha
itu captcha digunakan untuk memastikan bahwa pengguna memang manusia. Ini merupakan salah satu langkah perlindungan paling efektif terhadap scraping otomatis.
Untuk membatasi kemunculannya, kamu bisa menggunakan pustaka otomatisasi yang mensimulasikan browser sungguhan. Ada juga beberapa layanan pihak ketiga yang berspesialisasi dalam pemecahan captcha, berguna ketika volume permintaan menjadi besar.
Pemblokiran berdasarkan alamat IP
Beberapa situs mendeteksi sejumlah besar permintaan yang berasal dari sumber yang sama Alamat IP dan memblokir akses. Ini adalah tanda khas dari bot yang mengumpulkan data terlalu cepat.
Untuk menghindarinya, gunakan proxy atau vpn untuk mengganti alamat IP secara berkala. Tambahkan juga jeda waktu di antara setiap permintaan untuk meniru pola penelusuran manusia.
Pemblokiran berdasarkan User-Agent
Situs web dapat menolak permintaan yang berasal dari bot yang teridentifikasi oleh sebuah User-Agent yang mencurigakan. Tanpa User-Agent yang valid, banyak server akan mengembalikan sebuah kesalahan 403 atau halaman kosong.
Kuncinya adalah menentukan sebuah User-Agent yang realistis dalam permintaan HTTP-mu agar terlihat seperti browser biasa. Namun, perlu kamu ketahui bahwa ini bukanlah satu-satunya kendala: cookie dan jejak browser juga berperan penting.
Situs web berbasis JavaScript
Beberapa halaman memuat kontennya melalui JavaScript, sehingga permintaan HTTP biasa tidak dapat mengambil data tersebut. HTML yang diterima pun tidak memuat informasi yang kamu cari.
Dalam hal ini, gunakanlah alat-alat yang mampu menjalankan JavaScript: Selenium, Playwright Di mana Puppeteer. Mereka menjalankan browser sungguhan dan memungkinkanmu mengekstrak data setelah halaman ditampilkan sepenuhnya.
FAQ
Apa perbedaan antara bot scraping web dan perayap web?
| Pengikisan web | Perayap web |
|---|---|
| Bot ini berfokus pada data yang akurat : judul, harga, tautan produk. Sistem ini membaca kode HTML, mengidentifikasi elemen-elemen yang relevan, dan mengekstraknya untuk digunakan selanjutnya (analisis, penyimpanan dalam basis data, ekspor ke CSV atau JSON). | Crawler adalah program yang secara otomatis menjelajahi halaman-halaman dengan mengikuti tautan untuk temukan konten. Tujuannya adalah untuk memetakan dan mengindeks web, bukan semata-mata untuk mengekstrak data yang spesifik darinya. |
Apakah web scraping legal?
Itu legalitas web scraping tergantung pada situs web, jenis data yang dikumpulkan, dan tujuan penggunaannya. Mengambil data publik sering kali dimungkinkan, tetapi «publik» tidak berarti «bebas digunakan». Banyak perusahaan menggunakan web scraping untuk analisis pasar atau untuk mengumpulkan informasi yang tersedia secara publik di internet.
Sebaliknya, begitu kamu menyentuh data pribadiyang RGPD mengatur pengumpulan data secara ketat (dasar hukum yang sah, minimalisasi data), dengan ancaman sanksi berat. Selalu periksa kondisi penggunaan situs target sebelum menjalankan bot-mu.
Jenis data apa saja yang bisa diekstrak dengan bot scraping web?
Dengan bot scraping, kamu bisa mengumpulkan:
- Dari judul dan deskripsi produk.
- Dari harga dan promosi (berguna untuk Pengumpulan data harga dan pemantauan tarif pesaing).
- Dari tautan internal atau eksternal.
- Dari ulasan dan penilaian pengguna.
- Informasi kontak (ini adalah data pribadi yang tunduk pada GDPR).
- Dari konten tekstual atau gambar halaman web.
Data ini sering digunakan untuk kecerdasan kompetitif atau analisis pasar.
Bagaimana situs web dapat mendeteksi bot scraping saya?
Situs web sering kali mendeteksi bot berdasarkan perilaku yang tidak wajar, seperti:
- A kecepatan permintaan terlalu tinggi atau terlalu teratur.
- A Agen-Pengguna tidak standar, yang mengindikasikan adanya scraper.
- L'Sumber daya JavaScript tidak dimuat yang diperlukan untuk halaman ini.
- A penjelajahan bebas cookie, yang tidak wajar bagi manusia.
Apa saja tantangan umum saat membuat bot scraping web?
Membuat bot yang efektif tidak selalu mudah. Berikut ini adalah tantangan yang paling sering ditemui:
- Itu struktur HTML yang tidak konsisten : sebuah situs web bisa saja mengubah kelas CSS-nya dari satu hari ke hari berikutnya, sehingga selektor yang kamu gunakan tidak lagi menghasilkan apa pun.
- Itu data tidak terstruktur : Kamu harus membersihkan dan memformat ulang konten tersebut sebelum menyimpannya.
- Itu kecepatan pemuatan yang lambat halaman, terutama di situs dinamis yang menampilkan kontennya melalui JavaScript.
Apakah ada layanan atau API untuk web scraping?
Ya. Ada beberapa layanan yang mempermudah proses scraping dan menangani aspek-aspek yang paling merepotkan: proxy, captcha, serta situs dinamis. Kamu juga bisa menggunakan sebuah API pengikisan web untuk mengambil data terstruktur secara langsung. Bright Data merupakan salah satu solusi terlengkap yang ada di pasaran.
Untuk informasi lebih lanjut, silakan baca panduan kami tentang scraping web dengan Python dan temukan contoh penerapan yang lebih canggih.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA