Um einen Web-Scraping-Bot, du brauchst Python, aus der Bibliothek Requests um die Seiten abzurufen und BeautifulSoup um die Daten daraus zu extrahieren.
Dieser Leitfaden zeigt dir, wie du ein funktionsfähiges Skript in 5 Schritte. Ein Web-Scraping-Bot ist ein automatisiertes Programm, das Daten aus dem Internet von Websites sammelt: Es durchsucht die Seiten, extrahiert nützliche Informationen und speichert diese für die spätere Verwendung.
Bevor du deinen Bot startest, denke daran, die Datei zu überprüfen robots.txt der Zielwebsite, um herauszufinden, welche Seiten du aufrufen darfst.

Voraussetzungen für die Erstellung eines Web Scraping Bots
Als Erstes musst du dich für dein Programmiersprache. Er bestimmt, welche Werkzeuge zur Verfügung stehen und wie einfach die Umsetzung ist.
- Python : Die beliebteste Sprache für das Web-Scraping. Sie ist leicht zu erlernen und verfügt über ein umfangreiches Ökosystem an Bibliotheken zum Extrahieren von Daten.
- Node.js : ideal für asynchrone Aufgaben, mit sehr ausgereiften Tools (Puppeteer, Playwright), um dynamische Websites, die auf JavaScript basieren, zu scrapen.
- Andere Sprachen : Bei bestimmten Projekten kannst du dich auch an den Web-Scraping mit PHP.
Sobald du dich für eine Sprache entschieden hast, brauchst du die richtigen Bibliotheken. Sie sind es, die wirklich die Arbeit erledigen. Hier sind die nützlichsten davon, je nach Umgebung.
Zum Python :
- Requests : sendet HTTP-Anfragen um den Inhalt einer Seite abzurufen.
- BeautifulSoup : analysiert die HTML und ermöglicht es, die relevanten Informationen daraus zu extrahieren (Text, Preise, Links, Bilder).
- Scrapy : Ein umfassendes Framework für anspruchsvollere Scraping-Projekte mit Verwaltung von Anfragen in großem Umfang.
Zum Node.js :
- Axios Wo Fetch : zum Senden von HTTP-Anfragen.
- Cheerio : das Äquivalent von BeautifulSoup, sehr praktisch zum Durchsuchen und Bearbeiten des DOM.
- Puppeteer Wo Playwright : unverzichtbar für das Scraping dynamischer Websites. Sie steuern einen echten Browser und führen den Code aus JavaScript der Seite.
Tutorial zum Erstellen eines Web Scraping Bots
Einen Scraping-Bot zu erstellen, klingt zwar kompliziert, ist in der Praxis aber ganz einfach. Wenn man diese 5 Schritte, erhältst du ein funktionsfähiges Skript zum Sammeln von Daten im Internet. Stelle sicher, dass du Python und die erforderlichen Bibliotheken, bevor Sie beginnen.
Schritt 1: Analyse der Zielseite
Bevor du irgendetwas programmierst, musst du wissen, wo sich die Daten auf der Seite befinden. Dieser Schritt der’Analyse bestimmt alles andere.
- Öffne das Zielseite in deinem Browser.
- Klicke mit der rechten Maustaste und wähle dann Prüfen auf das Element, das dich interessiert.
- Erkenne die HTML-Tags, Klassen oder IDs, die den zu extrahierenden Inhalt enthalten (zum Beispiel
.product,.title,.Preis). - Teste deine CSS-Selektoren in der Konsole. Wenn die Produkttitel in Tags stehen
<h2>, wirst du diesen Selektor in deinem Code wiederverwenden.
Schritt 2: Senden einer HTTP-Anfrage
Dein Bot verhält sich wie ein Browser: Er sendet eine HTTP-Anfrage an den Server, der den HTML-Code der Seite zurücksendet. Das ist die Aufgabe der Bibliothek Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # Fehler bei Code 4xx oder 5xx
html = resp.text
print(html[:500])  # Vorschau
Schritt 3: Parsen des HTML-Inhalts
Sobald die Seite geladen ist, musst du diesen rohen HTML-Code in ein bearbeitbares Objekt umwandeln. Das ist die Aufgabe von BeautifulSoup, die Standardbibliothek zum Extrahieren von Daten aus HTML.
# pip install beautifulsoup4
from bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

produkte = soup.select(".product")
print(f "Produkte gefunden: {len(products)}")

for p in produkte[:3]:
    titel = p.select_one("h2.title").get_text(strip=True)
    Preis = p.select_one(".price").get_text(strip=True)
    link = p.select_one("a")["href"]
    print({"titel": titel, "preis": preis, "link": link})
Schritt 4: Daten extrahieren
Das ist der konkreteste Schritt: die genaue Informationen wie Überschriften, Preise und Links. Du kannst sie dabei auch gleich bereinigen, indem du beispielsweise ein Preis für Text nach Umfang.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Schritt 5: Daten sichern
Um deine Ergebnisse nicht zu verlieren, speichere sie in einer Datei. Die beiden gängigsten Formate sind das CSV (Tabellenkalkulation) und das JSON (ideal zur Versorgung einer Datenbank oder eine API).
import csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
mit open("export/produkte.csv", "w", newline="", encoding="utf-8") als f:
    field = ["title", "price", "url"]
    writer = csv.DictWriter(f, fieldnames=Felder, delimiter=";")
    writer.writeheader()
    writer.writerows(data)

# JSON
mit open("export/produkte.json", "w", encoding="utf-8") als f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("Export abgeschlossen!")
Du verfügst nun über einen voll funktionsfähigen Scraping-Bot: Er sendet eine Anfrage, analysiert den HTML-Code, extrahiert den Inhalt und speichert die Daten in einer CSV- oder JSON-Datei. Das ist eine solide Grundlage für die Automatisierung der Datenerfassung auf den meisten statischen Websites.
Wie geht man mit Anti-Scraping-Maßnahmen um?
Websites setzen verschiedene Mechanismen ein, um ihre Daten schützen gegen Bots. Es ist unerlässlich, diese Schutzmaßnahmen zu verstehen, um verantwortungsbewusst zu scrapen und zu vermeiden, dass du gesperrt wirst.
Die Datei „robots.txt“
das robots.txt-Datei Gibt an, welche Seiten ein Bot auf einer Website crawlen darf und welche nicht. Achtung: Es steuert die Crawl, nicht die Indizierung, und deren Einhaltung hängt vom guten Willen der Roboter ab.
Überprüfe diese Datei immer, bevor du deinen Scraper startest. Die Einhaltung dieser Vorgaben verringert zwar die Risiken, reicht aber nicht aus, um deine Datenerhebung rechtmäßig zu machen: Die Nutzungsbedingungen der Website und die DSGVO gelten ebenfalls.
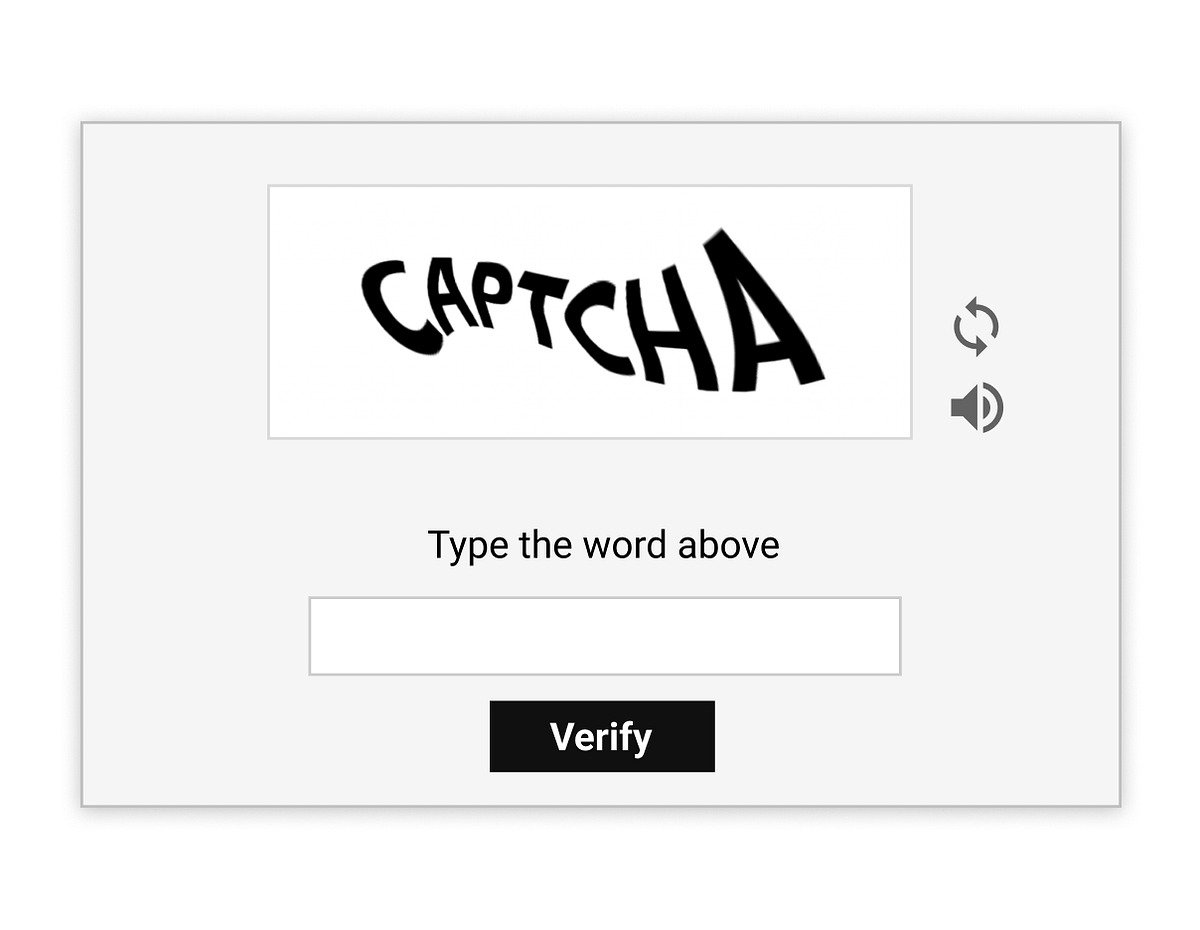
Captchas
das Captcha dient dazu, zu überprüfen, ob der Nutzer tatsächlich ein Mensch ist. Dies ist eine der wirksamsten Schutzmaßnahmen gegen automatisches Scraping.
Um deren Auftreten zu begrenzen, kannst du Automatisierungsbibliotheken verwenden, die einen echten Browser simulieren. Es gibt auch Drittanbieterdienste die auf die Lösung von Captchas spezialisiert sind und sich besonders dann als nützlich erweisen, wenn das Anfragevolumen groß wird.
Sperrungen nach IP-Adresse
Manche Websites verzeichnen eine große Anzahl von Anfragen, die von derselben IP-Adresse und blockieren den Zugriff. Das ist das typische Anzeichen dafür, dass ein Bot die Daten zu schnell abruft.
Um das zu vermeiden, verwende Proxies oder eins VPN um die IP-Adresse regelmäßig zu wechseln. Fügt außerdem eine Verzögerung zwischen den einzelnen Anfragen ein, um das Surfverhalten eines Menschen nachzuahmen.
Blockierungen nach User-Agent
Websites können Anfragen von Bots ablehnen, die durch ein Verdächtiger User-Agent. Ohne gültigen User-Agent geben viele Server eine Fehler 403 oder eine leere Seite.
Der Trick besteht darin, einen Realistischer User-Agent in deinen HTTP-Anfragen, um wie ein herkömmlicher Browser zu wirken. Beachte jedoch, dass dies nicht die einzige Hürde ist: Auch Cookies und der Browser-Fingerabdruck spielen eine Rolle.
Webseiten in JavaScript
Manche Seiten laden ihre Inhalte über JavaScript, wodurch einfache HTTP-Anfragen die Daten nicht abrufen können. Der empfangene HTML-Code enthält dann keine der gesuchten Informationen.
In diesem Fall solltest du auf Tools zurückgreifen, die JavaScript ausführen können: Selenium, Playwright Wo Puppeteer. Sie steuern einen echten Browser und ermöglichen es dir, die Daten zu extrahieren, sobald die Seite vollständig geladen ist.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einem Web Scraping Bot und einem Web Crawler?
| Web Scraping | Webcrawler |
|---|---|
| Der Bot konzentriert sich auf genaue Daten : Titel, Preise, Produktlinks. Es liest den HTML-Code, identifiziert die relevanten Elemente und extrahiert sie, um sie anschließend weiterzuverwenden (Auswertung, Speicherung in einer Datenbank, Export als CSV oder JSON). | Der Crawler ist ein Programm, das automatisch Webseiten durchsucht, indem es den Links folgt, um Inhalte entdecken. Sein Ziel ist es, das Web zu kartografieren und zu indexieren, nicht unbedingt, bestimmte Daten daraus zu extrahieren. |
Ist Web Scraping legal?
Das Legalität von Web Scraping hängt von der Website, der Art der erfassten Daten und der Art und Weise ab, wie du sie nutzt. Das Scrapen öffentlicher Daten ist oft möglich, aber «öffentlich» bedeutet nicht gleich «frei nutzbar». Viele Unternehmen nutzen Web-Scraping für Marktanalysen oder um im Internet öffentlich zugängliche Informationen zu sammeln.
Sobald du jedoch an persönliche Daten, das DSGVO regelt die Datenerhebung streng (gültige Rechtsgrundlage, Datenminimierung), wobei bei Verstößen schwere Sanktionen drohen. Überprüfe stets die Nutzungsbedingungen der Zielseite, bevor du deinen Bot startest.
Welche Arten von Daten können mit einem Web Scraping Bot extrahiert werden?
Mit einem Scraping-Bot kannst du Folgendes erfassen:
- Des Titel und Beschreibungen von Produkten.
- Des Preise und Sonderangebote (nützlich für die Preis-Scraping und die Beobachtung der Preise der Wettbewerber).
- Des interne oder externe Links.
- Des Bewertungen und Anmerkungen der Nutzer.
- Kontaktdaten (es handelt sich um personenbezogene Daten, die der DSGVO unterliegen).
- Des Textinhalte oder Bilder von Webseiten.
Diese Daten werden häufig für die Wettbewerbsbeobachtung oder zur Marktanalyse.
Wie kann eine Website meinen Scraping-Bot erkennen?
Websites erkennen Bots häufig anhand ungewöhnlicher Verhaltensweisen, wie zum Beispiel:
- A Abfragegeschwindigkeit zu hoch oder zu gleichmäßig.
- EIN User-Agent nicht standardmäßig, was auf einen Scraper hindeutet.
- L'JavaScript-Ressourcen werden nicht geladen die für die Seite erforderlich sind.
- A Cookie-freies Surfen, was für einen Menschen unnatürlich ist.
Was sind häufige Herausforderungen bei der Erstellung eines Web Scraping Bots?
Einen effektiven Bot zu entwickeln, ist nicht immer einfach. Hier sind die häufigsten Herausforderungen:
- Das inkonsistente HTML-Strukturen : Eine Website kann ihre CSS-Klassen von einem Tag auf den anderen ändern, sodass dein Selektor keine Ergebnisse mehr liefert.
- Das unstrukturierte Daten : Du musst den Inhalt bereinigen und neu formatieren, bevor du ihn speicherst.
- Das langsames Laden Seiten, insbesondere auf dynamischen Websites, deren Inhalte über JavaScript angezeigt werden.
Gibt es Dienste oder APIs für das Web-Scraping?
Ja. Es gibt Dienste, die das Scraping vereinfachen und die mühsamsten Aspekte übernehmen: Proxys, Captchas, dynamische Websites. Du kannst auch eine Web Scraping API um strukturierte Daten direkt abzurufen. Bright Data gehört zu den umfassendsten Lösungen auf dem Markt.
Wenn du mehr darüber erfahren möchtest, schau dir unseren Leitfaden zum Thema web scraping mit Python und entdecke fortgeschrittenere Anwendungsfälle.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA