Web-Scraping mit Python basiert auf zwei Hauptbibliotheken: requests um die Webseiten abzurufen und BeautifulSoup um die Daten daraus zu extrahieren.
In diesem Artikel erfährst du, wie du sie installierst, dein erstes Skript schreibst und deine Ergebnisse speicherst – auch ohne Programmiererfahrung.
Voraussetzungen für das Scraping mit Python

Bevor du loslegst, müssen drei Voraussetzungen erfüllt sein. Hier sind sie in logischer Reihenfolge.
1. Kenntnisse in der Programmierung haben
Du musst die Grundlagen der Programmierung : Variablen, Kontrollstrukturen, Funktionen, Wörterbücher, Dateiverarbeitung und Bibliotheken. Diese Konzepte ermöglichen es dir, die Skriptlogik, die abgerufenen Daten zu bearbeiten und Fehler ordnungsgemäß zu behandeln.
2. Beherrschen der Struktur einer Webseite (HTML, CSS)
Python sieht Webseiten nicht so wie du. Es sieht lediglich den HTML-Code aus dem die Seite besteht. Wenn du eine bestimmte Information abrufen möchtest, musst du wissen, wo sie sich in diesem Code befindet, sonst kann Python sie nicht extrahieren.

3. HTTP-Anfragen verstehen (GET, POST)
Bevor Python den Code einer Seite auslesen kann, muss es diesen über eine Anfrage bei der Website anfordern. Eine GET-Anfrage ruft die Seite ab, während eine POST-Anfrage sendet Daten an die Website. Ohne dieses Verständnis kann dein Skript weder die Seite noch die darin enthaltenen Informationen abrufen.
Ein weiterer wichtiger Punkt: der Web Scraping unterscheidet sich von dem Crawling. Beim Crawling werden alle Seiten einer Website durchlaufen, um sie zu erfassen und zu analysieren. Beim Scraping hingegen werden ausschließlich bestimmte Informationen gezielt extrahiert. Diese Unterscheidung ist hilfreich, um deine Arbeit gut zu planen.

Welche Tools sind für das Web Scraping mit Python unerlässlich?
Um loszulegen, musst du deine Arbeitsumgebung in drei Schritten einrichten: Python installieren, dein Projekt isolieren und anschließend die benötigten Bibliotheken hinzufügen.
1. Python installieren
Lade Python von der offiziellen Website python.org herunter. Achte darauf, bei der Installation unter Windows die Option anzukreuzen Python zum PATH hinzufügen. Dieses Kontrollkästchen fügt den Python-Ordner und den Unterordner Scripts\ im PATH, wodurch der Befehl pip direkt über die Befehlszeile verfügbar.
Seit Python 3.4, pip ist standardmäßig enthalten. Mit diesem Paketmanager kannst du alle benötigten Bibliotheken installieren. Sollte er nicht erkannt werden, gib den Befehl python -m pip funktioniert in jedem Fall.
2. Vorbereiten einer virtuellen Umgebung
EIN virtuelle Umgebung Isoliere die Bibliotheken deines Python-Projekts, ohne dass es zu Konflikten mit anderen Anwendungen auf deinem Rechner kommt. Du erstellst es mit python -m venv venv, und dann aktivierst du sie. Deine Installationen bleiben dann auf dieses Projekt beschränkt.
3. Installieren Sie die Schlüsselbibliotheken für das Scraping
A Bibliothek ist eine Sammlung vorgefertigter Funktionen, die du direkt in deinem Code verwenden kannst. So musst du nicht alles selbst neu schreiben und wiederkehrende Aufgaben werden vereinfacht. Hier sind die wichtigsten:
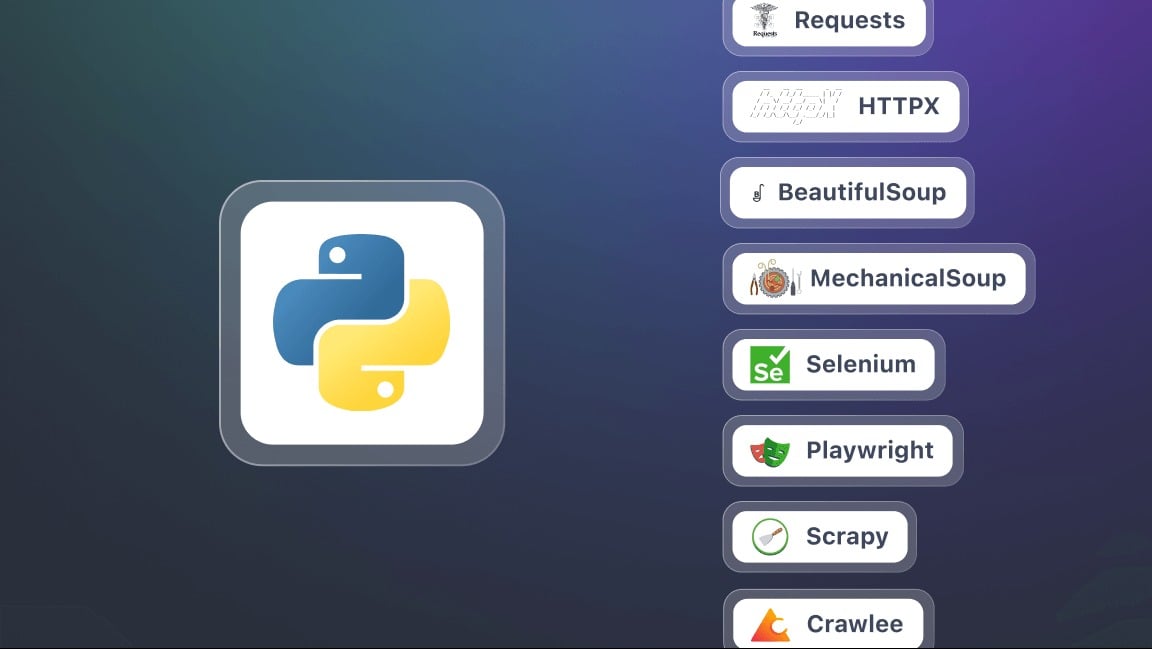
- Requests : sendet HTTP-Anfragen und ruft den Inhalt von Webseiten ab. Dies ist die Grundlage für jeden Scraping-Vorgang.
- BeautifulSoup : analysiert den HTML-Code und extrahiert die Informationen mithilfe praktischer Selektoren wie find(), find_all() Wo select().
- Selenium : nützlich, wenn der Inhalt dynamisch mit JavaScript generiert wird. Er simuliert einen echten Browser und interagiert mit der Seite.
- lxml : ein sehr schneller HTML- und XML-Parser, der leistungsfähiger ist als BeautifulSoup, aber etwas schwieriger zu erlernen.
- Playwright : eine moderne Alternative zu Selenium, was oft schneller ist.
- Scrapy : ein leistungsstarkes Framework für groß angelegte Scraping-Projekte, das mehrere Seiten und Websites gleichzeitig verarbeiten kann.
Wie kann man mit Python Web Scraping betreiben?
Hier findest du eine Schritt-für-Schritt-Anleitung, wie du dein erstes Scraping-Projekt startest. Zu jedem Schritt gibt es eine Codeausschnitt bereit zum Kopieren.
Schritt 1: Bibliotheken installieren (requests und beautifulsoup4)
Du benötigst zwei Bibliotheken: requests um die Seiten abzurufen und beautifulsoup4 um die Daten daraus zu extrahieren. Installiere sie alle auf einmal mit pip :
pip install requests beautifulsoup4Ob pip wird nicht erkannt, verwendet python -m pip install requests beautifulsoup4, das unabhängig von deinem PATH funktioniert. Beginne dein Skript anschließend mit diesen beiden Zeilen:
import requests
from bs4 import BeautifulSoup
Schritt 2: Eine HTTP-Anfrage stellen und den Inhalt abrufen
Sobald die Bibliotheken bereit sind, kannst du eine HTTP-Anfrage zu einer Webseite navigieren und deren Inhalt anzeigen. Denke daran, das’Vollständige URL der Zielseite:
import requests

url = "https://exemple.com"
page = requests.get(url)

print(page.text) # Zeigt den HTML-Code der Seite an
Hier, page.text enthält den gesamten HTML-Code der Website, die du analysieren wirst.
Schritt 3: Das HTML mit BeautifulSoup analysieren
Nachdem du den Inhalt nun abgerufen hast, kannst du ihn mit BeautifulSoup. In diesem Schritt wird das Roh-HTML in eine übersichtliche Struktur:
from bs4 import BeautifulSoup

soup = BeautifulSoup(page.text, "html.parser")

# Beispiel: Den Titel der Seite anzeigen.
print(soup.title.string)
Schritt 4: Extrahieren spezifischer Daten (Titel, Links usw.)
Dank an BeautifulSoup, du kannst bestimmte HTML-Tags ansprechen : Überschriften, Links, Absätze usw. Zwei der häufigsten Beispiele:
# Alle Titel extrahieren <h2>
for title in soup.find_all("h2"):
    print(titel.get_text())

# Alle Links extrahieren <a>
for lien in soup.find_all("a"):
    print(link["href"])
Schritt 5: Daten sichern (CSV, JSON)
Sobald du deine Daten extrahiert hast, kannst du sie in einer Datei speichern um sie später wiederzuverwenden. Das Format CSV eignet sich für Gemälde, das JSON auf strukturierte Daten.
Beispiel in CSV :
csv-Import

titel = [titel.get_text() for titel in soup.find_all("h2")]

mit open("ergebnisse.csv", "w", newline="", encoding="utf-8") als f:
    writer = csv.writer(f)
    writer.writerow(["Titel"])
    for t in titles:
        writer.writerow([t])
Beispiel in JSON :
import json

links = [lien["href"] for lien in soup.find_all("a")]

mit open("links.json", "w", encoding="utf-8") als f:
    json.dump(links, f, indent=4, ensure_ascii=False)
Dieses Tutorial richtet sich an kleines Projekt, wie zum Beispiel das Scraping einer statischen Website. In der Praxis wirst du schnell auf anspruchsvollere Herausforderungen stoßen:
- Seitenumbruch verwalten : Über mehrere Seiten hinweg durchgehen, um alles zu erfassen.
- Formulare verwalten : Daten über eine POST-Anfrage senden, um ein gefiltertes Ergebnis zu erhalten.
- Einschränkungen umgehen : Eine realistische Identifikationszeile hinzufügen und über Proxies um nicht stecken zu bleiben.
Warum Web Scraping mit Python?
das web scraping mit Python eröffnet dir zahlreiche konkrete Möglichkeiten. Hier sind die Anwendungsbereiche, die diese Methode im Alltag wirklich nützlich machen.
- Preisverfolgung und E-Commerce : Du rufst Produktdatenblätter ab, um die Entwicklung der Tarife, die Angebote der Mitbewerber zu vergleichen und die besten Gelegenheiten in Echtzeit zu erkennen.
- Auswertung der Kundenbewertungen : Du sammelst Kommentare auf verschiedenen Websites, um Trends zu erkennen, die Erwartungen der Verbraucher zu verstehen und ein Produkt oder eine Dienstleistung zu verbessern.

- Aggregation von Inhalten : Du bündelst Blogartikel oder Nachrichten aus verschiedenen Quellen, um eine stets aktuelle Plattform zu schaffen.
- Recherche und Beobachtung : Du sammelst Daten für Studien, verfolgst Veröffentlichungen oder behältst eine bestimmte Branche im Blick.
In der Praxis erspart dir Web Scraping stundenlanges manuelles Kopieren und Einfügen. Ein einziges, gut durchdachtes Skript ruft deine Daten automatisch ab und aktualisiert sie in dem von dir gewählten Rhythmus.
Was sind die besten Praktiken für Web Scraping mit Python?
Beim Web-Scraping geht es nicht nur darum, Daten zu extrahieren. Man muss dies auch auf eine Weise tun, die effizient, verantwortungsbewusst und nachhaltig, sonst wirst du möglicherweise schnell gesperrt. Hier sind die Regeln, die du beachten musst:
- Beachten Sie die Datei robots.txt : befindet sich im Stammverzeichnis einer Website (z. B. exemple.com/robots.txt), zeigt er dir an, welche Seiten für das Scraping zugelassen oder gesperrt sind. Schau dort nach, bevor du dein Skript startest.
- Ein angemessenes Abfrage-Tempo einhalten : Fügt zwischen jeder Anfrage eine Pause ein, um eine Überlastung des Servers zu vermeiden und zu verhindern, dass du gesperrt wirst.
- Einen passenden User-Agent verwenden : füllt eine Kopfzeile aus User-Agent der deinen Roboter eindeutig identifiziert, anstatt den Standardwert von requests, die oft von Amts wegen gesperrt wird.
- Fehler und Ausnahmen behandeln : Füge deinen Abfragen einen Fehlerbehandlungsblock hinzu. Eine nicht verfügbare Seite sollte nicht dazu führen, dass dein gesamtes Programm abstürzt.
- Proxys und IP-Rotation verwenden : Bei großen Datenmengen verhindert der Wechsel zwischen mehreren IP-Adressen, dass eine einzelne Adresse identifiziert und anschließend gesperrt wird.
- Die Anzahl der Abfragen minimieren : Lade nur die Seiten herunter, die du wirklich brauchst. Weniger Anfragen bedeuten weniger Belastung für den Server und ein geringeres Risiko, entdeckt zu werden.
- Transparent bleiben : Geben Sie, sofern möglich, eine Kontakt-E-Mail-Adresse in deinem User-Agent. Der Administrator der Website kann dich so kontaktieren, anstatt dich zu sperren.
- Extrahieren und Speichern voneinander trennen : Ruft zunächst die Daten ab und speichert sie anschließend in einer CSV-Datei oder einer Datenbank. Sollte die Verarbeitung fehlschlagen, gehen deine gesammelten Daten nicht verloren.
- Robuste Selektoren verwenden : Bevorzugt stabile Attribute wie Ausweis Wo data-* anstatt CSS-Klassen, die sich häufig ändern. Dein Skript wird dann besser mit Aktualisierungen der Website zurechtkommen.
- Deinen Code dokumentieren : Erläutere die wichtigsten Schritte und notiere die Datum deines Scrapings. Der Aufbau einer Seite verändert sich, und du wirst schneller verstehen, was du korrigieren musst, wenn mal etwas nicht mehr funktioniert.
Häufig gestellte Fragen
Welches ist das beste Framework für Web Scraping in Python?
Es gibt kein einziges "bestes" Framework, denn alles hängt von der Komplexität deines Projekts.

- Für einfache Extraktionen, Requests und BeautifulSoup reichen völlig aus.
- Wenn eine Website viel JavaScript, dann gehst du weiter zu Selenium Wo Playwright.
- Schließlich gilt für ein groß angelegtes Projekt, Scrapy ist dank seiner Leistungsfähigkeit und seiner robusten Bauweise nach wie vor die beste Wahl.
Wie scrape ich eine Website in Python?
Der Prozess basiert auf drei Hauptschritte :
- Du sendest eine HTTP-Anfrage zur Zielseite.
- Du analysierst die HTML-Struktur erhalten.
- Du extrahierst die Daten die dich interessieren, und dann speicherst du sie.
Welche Rolle spielt der Web Scraper?
das Die Funktion eines Web-Scrapers besteht darin, Webseiten automatisch zu durchsuchen, um bestimmte Daten zu extrahieren: Texte, Preise, Bilder oder Links. Er fungiert als Vermittler zwischen der Website und dir und wandelt die Rohdaten in auswertbare Daten.

Wie verwendet man BeautifulSoup in Python?
BeautifulSoup ist eine Bibliothek, die dazu dient, den HTML-Code einer Seite zu analysieren und auf einfache Weise die Tags zu finden, die die zu extrahierenden Informationen enthalten. Konkret kombinierst du eine HTTP-Anfrage mit Requests, und dann analysierst du den Inhalt mit BeautifulSoup um durch die Struktur zu navigieren und die gewünschten Daten abzurufen.
Wie kann man eine Website mit dynamischen Inhalten in JavaScript scrapen?
Einige Seiten stützen sich stark auf JavaScript um deren Inhalt anzuzeigen. In diesem Fall kommen klassische Lösungen wie Requests reichen nicht mehr aus. Du musst daher Tools verwenden, die einen echten Browser simulieren können, wie zum Beispiel Selenium Wo Playwright, um die Seite zu laden und mit ihr zu interagieren.
Welche Sprache wird am häufigsten für Web Scraping verwendet?
Python ist heute dank ihrer Einfachheit und der Vielzahl an spezialisierten Bibliotheken die beliebteste Sprache für das Web-Scraping. Allerdings kannst du auch das’Datenextraktion mit PHP, auch wenn diese Technik nach wie vor weniger verbreitet ist.
Ist Web Scraping legal?
Das Legalität von Web Scraping ist eine komplexe Frage. Es hängt ganz davon ab, wie du es praktizierst und ob du die Nutzungsbedingungen von den Websites und der Art der erfassten Daten. In Frankreich ist Web-Scraping in bestimmten Fällen geduldet, kann jedoch rechtswidrig werden, wenn dadurch Zugriffsrechte, die Nutzungsbedingungen einer Website oder die Rechtsvorschriften zu den persönliche Daten.
Kurz gesagt: Web-Scraping mit Python eröffnet eine Welt voller unglaublicher Möglichkeiten! Und du – welche Erfahrungen hast du gemacht oder welche Fragen hast du? Teile sie gerne in den Kommentaren mit uns – wir freuen uns darauf, von dir zu lesen!








 DE