Il web scraping con Python si basa su due librerie principali: requests per recuperare le pagine web e BeautifulSoup per estrarne i dati.
In questo articolo scoprirai come installarli, scrivere il tuo primo script e salvare i risultati, anche senza alcuna esperienza di programmazione.
Prerequisiti per lo scraping con Python

Prima di iniziare, devi soddisfare tre condizioni. Eccole, in ordine logico.
1. Conoscenza di base della programmazione
Devi conoscere i basi di programmazione : variabili, strutture di controllo, funzioni, dizionari, gestione dei file e librerie. Questi concetti ti permettono di comprendere la logica di script, elaborare i dati recuperati e gestire correttamente gli errori.
2. Padroneggiare la struttura di una pagina web (HTML, CSS)
Python non vede le pagine web come te. Vede solo il codice HTML che compone la pagina. Se vuoi recuperare un’informazione specifica, devi sapere dove si trova all’interno di quel codice, altrimenti Python non può estrarla.

3. Comprendere le richieste HTTP (GET, POST)
Prima di leggere il codice di una pagina, Python deve richiederlo al sito tramite una richiesta. Una Richiesta GET recupera la pagina, mentre una richiesta POST invia dati al sito. Senza questa comprensione, il tuo script non può né recuperare la pagina né le informazioni in essa contenute.
Un altro punto importante: il scraping del web è diverso dal crawling. Il crawling esamina tutte le pagine di un sito per individuarle e analizzarle. Lo scraping, invece, si concentra esclusivamente su informazioni specifiche. Questa distinzione è utile per pianificare al meglio il tuo lavoro.

Quali sono gli strumenti essenziali per il web scraping con Python?
Per iniziare, devi preparare il tuo ambiente di lavoro in tre fasi: installare Python, isolare il tuo progetto e infine aggiungere le librerie necessarie.
1. Installazione di Python
Scarica Python dal sito ufficiale python.org. Durante l'installazione su Windows, assicurati di selezionare l'opzione Aggiungi Python al PATH. Questa casella di selezione aggiunge la cartella Python e la sottocartella Scripts\ nel PATH, il che rende il comando pip disponibile direttamente tramite ordine online.
Da Python 3.4, pip è incluso di default. È il gestore di pacchetti che ti permette di installare tutte le librerie di cui avrai bisogno. Se non dovesse essere riconosciuto, il comando python -m pip funziona in ogni caso.
2. Preparazione di un ambiente virtuale
UN ambiente virtuale isola le librerie del tuo progetto Python, senza interferire con le altre applicazioni presenti sul tuo computer. Lo crei con python -m venv venv, poi lo attivi. Le tue installazioni rimarranno così specifiche per quel progetto.
3. Installare le librerie chiave per lo scraping
Una biblioteca è un insieme di funzioni già programmate che puoi utilizzare direttamente nel tuo codice. Ti evita di dover riscrivere tutto da zero e semplifica le attività ripetitive. Ecco le principali:
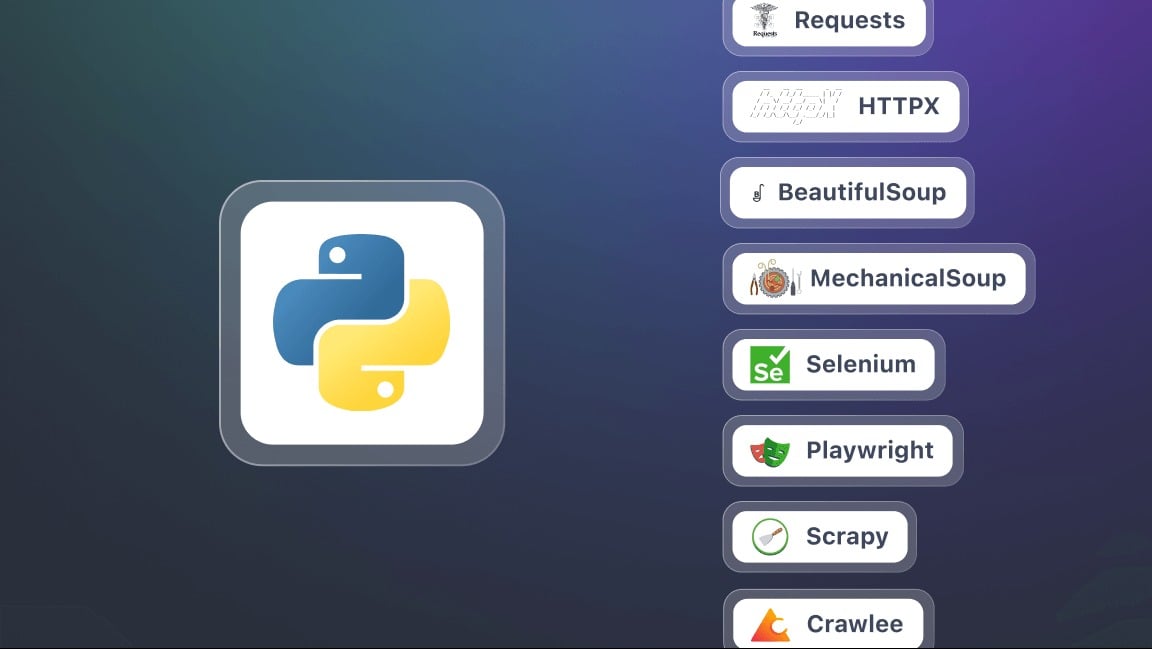
- Requests : invia richieste HTTP e recupera il contenuto delle pagine web. È la base di qualsiasi operazione di scraping.
- BeautifulSoup : analizza il codice HTML ed estrae le informazioni grazie a pratici selettori come find(), find_all() Dove select().
- Selenium : utile quando il contenuto viene generato dinamicamente in JavaScript. Simula un vero browser e interagisce con la pagina.
- lxml : un analizzatore HTML e XML molto veloce, più efficiente di BeautifulSoup, ma un po' più complesso da imparare a usare.
- Playwright : un'alternativa moderna a Selenium, spesso più veloce.
- Scrapy : un potente framework per progetti di scraping su larga scala, in grado di gestire contemporaneamente più pagine e più siti.
Come si può fare web scraping con Python?
Ecco la procedura da seguire, passo dopo passo, per avviare il tuo primo progetto di scraping. Ogni fase è accompagnata da un frammento di codice pronto per essere copiato.
Fase 1: Installare le librerie (requests e beautifulsoup4)
Ti servono due librerie: requests per recuperare le pagine e beautifulsoup4 per estrarne i dati. Installali tutti in una volta con pip :
pip installa le richieste di beautifulsoup4Se pip non è riconosciuto, utilizza python -m pip install requests beautifulsoup4, che funziona indipendentemente dal tuo PATH. Inizia quindi il tuo script con queste due righe:
import requests
from bs4 import BeautifulSoup
Passo 2: effettuare una richiesta HTTP e recuperare i contenuti
Una volta che le librerie sono pronte, puoi inviare una Richiesta HTTP verso una pagina web e visualizzarne il contenuto. Ricordati di utilizzare l’URL completo della pagina di destinazione:
richieste di importazione

url = "https://exemple.com"
pagina = requests.get(url)

print(page.text) # Visualizza il codice HTML della pagina
Qui, page.text contiene tutto il codice HTML del sito che stai per analizzare.
Fase 3: Analizzare il codice HTML con BeautifulSoup
Ora che hai recuperato il contenuto, puoi analizzarlo con BeautifulSoup. Questa fase trasforma il HTML semplice in una struttura di facile consultazione:
da bs4 importa BeautifulSoup

soup = BeautifulSoup(page.text, "html.parser")

# Esempio: visualizzazione del titolo della pagina
print(soup.title.string)
Fase 4: Estrazione di dati specifici (titoli, link, ecc.)
Grazie a BeautifulSoup, puoi individuare specifici tag HTML : titoli, link, paragrafi, ecc. Due esempi tra i più comuni:
# Estrarre tutti i titoli <h2>
per titolo in soup.find_all("h2"):
    print(titolo.get_text())

# Estrarre tutti i collegamenti <a>
per lien in soup.find_all("a"):
    print(link["href"])
Passo 5: salvare i dati (CSV, JSON)
Una volta estratti i tuoi dati, puoi salvare in un file per riutilizzarli in seguito. Il formato CSV adatto ai quadri, il JSON ai dati strutturati.
Esempio in CSV :
importare csv

titles = [title.get_text() for title in soup.find_all("h2")]

con open("results.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["Titolo"])
    per t in titoli:
        writer.writerow([t])
Esempio in JSON :
importare json

lien = [lien["href"] for lien in soup.find_all("a")]

con open("liens.json", "w", encoding="utf-8") as f:
    json.dump(liens, f, indent=4, ensure_ascii=False)
Questo tutorial è rivolto a un piccolo progetto, come lo scraping di un sito statico. In pratica, ti troverai presto ad affrontare sfide più complesse:
- Gestione della paginazione : scorrere più pagine per visualizzare tutto il contenuto.
- Gestione dei moduli : inviare dati tramite una richiesta POST per ottenere un risultato filtrato.
- Come aggirare le restrizioni : aggiungere un’intestazione di identificazione realistica e passare attraverso dei deleghe per evitare di rimanere bloccati.
Perché fare web scraping con Python?
il scraping del web con Python ti offre numerose possibilità concrete. Ecco gli ambiti in cui questa pratica si rivela davvero utile nella vita di tutti i giorni.
- Tracciamento dei prezzi e commercio elettronico : raccogli le schede prodotto per monitorare l’andamento dei tariffe, confrontare le offerte dei concorrenti e individuare le migliori opportunità in tempo reale.
- Analisi delle recensioni dei clienti : raccogli i commenti da diversi siti per individuare le tendenze, comprendere le aspettative dei consumatori e migliorare un prodotto o un servizio.

- Aggregazione di contenuti : raccogli gli articoli dei blog o le notizie provenienti da diverse fonti per creare una piattaforma sempre aggiornata.
- Ricerca e monitoraggio : raccogli dati per studi, segui le pubblicazioni o tieni d’occhio un settore specifico.
In pratica, il web scraping ti evita ore di copia-incolla manuale. Un unico script ben progettato recupera e aggiorna i tuoi dati automaticamente, con la frequenza che preferisci.
Quali sono le migliori pratiche per il web scraping con Python?
Il web scraping non consiste solo nell’estrarre dati. Bisogna anche farlo in modo efficace, responsabile e sostenibile, altrimenti rischi di rimanere bloccato in fretta. Ecco le regole da seguire:
- Rispettare il file robots.txt : presente nella radice di un sito (es. exemple.com/robots.txt), ti indica quali pagine sono autorizzate o vietate per lo scraping. Consultalo prima di avviare il tuo script.
- Mantenere un ritmo ragionevole nelle richieste : aggiunge una pausa tra una richiesta e l'altra per evitare di sovraccaricare il server e di farti bannare.
- Utilizzare un User-Agent appropriato : compila un'intestazione User-Agent che identifica chiaramente il tuo robot, anziché il valore predefinito di requests, spesso bloccata d'ufficio.
- Gestire gli errori e le eccezioni : racchiudi le tue richieste in un blocco di gestione degli errori. Una pagina non disponibile non deve causare il crash dell’intero programma.
- Utilizzare proxy e la rotazione degli indirizzi IP : in caso di grandi volumi, l'utilizzo di più indirizzi IP evita che uno solo venga individuato e quindi bloccato.
- Ridurre al minimo il numero di richieste : scarica solo le pagine di cui hai davvero bisogno. Meno richieste significano meno carico sul server e meno rischi di essere individuato.
- Mantenere la trasparenza : quando possibile, indica un indirizzo e-mail di contatto nel tuo User-Agent. In questo modo, l'amministratore del sito potrà contattarti invece di bloccarti.
- Separare l'estrazione dal salvataggio : prima recupera i dati, poi li salva in un file CSV o in un database. Se l'elaborazione fallisce, non perdi i dati raccolti.
- Utilizzare selettori resistenti : privilegia attributi stabili come id Dove data-* piuttosto che classi CSS che cambiano spesso. Il tuo script resisterà meglio agli aggiornamenti del sito.
- Documentare il codice : illustra le fasi principali e indica la data del tuo scraping. La struttura di una pagina cambia nel tempo, e capirai più in fretta cosa correggere quando qualcosa non funziona più.
Domande frequenti
Qual è il miglior framework per il web scraping in Python?
Non esiste un unico quadro di riferimento "migliore", perché tutto dipende dal tipo di complessità del tuo progetto.

- Per estrazioni semplici, Requests e BeautifulSoup sono più che sufficienti.
- Quando un sito utilizza molti JavaScript, si passa a Selenium Dove Playwright.
- Infine, per un progetto di ampia portata, Scrapy rimane la soluzione più adatta grazie alle sue prestazioni e alla sua struttura robusta.
Come si effettua lo scrape di un sito web in Python?
Il processo si basa su tre fasi principali :
- Mandi un Richiesta HTTP alla pagina di destinazione.
- Analizzi la struttura HTML ricevuta.
- Estrai i dati che ti interessano, poi li salvi.
Qual è il ruolo del web scraper?
il funzione di uno scraper web è quello di scansionare automaticamente le pagine web per estrarne dati specifici: testi, prezzi, immagini o link. Funge da intermediario tra il sito e te, trasformando le informazioni grezze in dati utilizzabili.

Come si usa BeautifulSoup in Python?
BeautifulSoup è una libreria progettata per analizzare il codice HTML di una pagina e individuare facilmente i tag che contengono le informazioni da estrarre. In pratica, si combina una richiesta HTTP con Requests, poi analizzi il contenuto con BeautifulSoup per navigare nella struttura e recuperare i dati desiderati.
Come si fa a estrarre i dati da un sito web con contenuti dinamici in JavaScript?
Alcuni siti si basano molto su JavaScript per visualizzarne il contenuto. In questo caso, le soluzioni classiche come Requests non bastano più. Devi quindi utilizzare strumenti in grado di simulare un vero browser, come Selenium Dove Playwright, per caricare la pagina e interagire con essa.
Qual è il linguaggio più comune utilizzato per il web scraping?
Python è oggi il linguaggio più diffuso per il web scraping, grazie alla sua semplicità e alla ricchezza delle sue librerie specializzate. Detto questo, puoi anche automatizzare il’estrazione dei dati con PHP, anche se questa tecnica è ancora poco diffusa.
Il web scraping è legale?
Il legalità del web scraping È una questione complessa. Tutto dipende dal modo in cui la pratichi e dal rispetto delle condizioni di utilizzo dai siti e dalla natura dei dati raccolti. In Francia, il web scraping è tollerato in alcuni casi, ma può diventare illegale se viola i diritti di accesso, le condizioni d’uso di un sito o la normativa in materia di dati personali.
Insomma, il web scraping con Python apre un mondo di incredibili possibilità! E tu, quali sono le tue esperienze o le tue domande? Non esitare a condividerle nei commenti, non vediamo l’ora di leggerti!








 IT