Pythonによるウェブスクレイピングは、主に2つのライブラリに基づいています: requests ウェブページを取得して、 BeautifulSoup データを抽出するために。.
この記事では、プログラミングの経験がなくても、それらをインストールする方法、初めてのスクリプトを作成する方法、そして結果を保存する方法について学びます。.
Pythonでスクレイピングするための前提条件

始める前に、3つの条件を満たす必要があります。それらを論理的な順序で説明します。.
1.プログラミングの基礎知識
あなたは以下のことを知っておくべきだ プログラミングの基礎 : 変数、制御構造、関数、辞書、ファイル操作、ライブラリ。これらの概念を理解することで、 スクリプトロジック, 、取得したデータを処理し、エラーを適切に処理すること。.
2.ウェブページの構造をマスターする(HTML、CSS)
Pythonは、あなたのようにウェブページを認識しません。Pythonが認識するのは、あくまで HTMLコード そのページを構成しているコードです。特定の情報を取得したい場合は、その情報がコード内のどこにあるかを知っておく必要があります。そうしないと、Pythonはその情報を抽出できません。.

3.HTTPリクエスト(GET、POST)の理解
ページのコードを読み込む前に、Pythonはリクエストを通じてそのサイトにコードを要求する必要があります。ある リクエスト そのページを取得し、一方、ある POSTリクエスト サイトにデータを送信します。この仕組みを理解していなければ、スクリプトはページも、そこに含まれる情報も取得できません。.
もう1つの重要な点は、 ウェブスクレイピング は、 クロール. クローリングは、サイト内のすべてのページを巡回して、それらを把握・分析するものです。一方、スクレイピングは、特定の情報のみに焦点を当てます。この違いを理解しておくことは、作業を適切に計画する上で役立ちます。.

Pythonを使ったウェブスクレイピングに欠かせないツールとは?
まず、3つのステップで作業環境を整える必要があります。Pythonのインストール、プロジェクトの分離、そして必要なライブラリの追加です。.
1.Pythonのインストール
python.orgの公式サイトからPythonをダウンロードしてください。Windowsでのインストール時には、必ず次のオプションにチェックを入れてください。 PATHにPythonを追加する. このチェックボックスをオンにすると、Pythonフォルダとそのサブフォルダが追加されます Scripts\ PATH にあるため、このコマンドは pip オンライン注文で直接ご購入いただけます。.
以来 Python 3.4, pip はデフォルトで含まれています。これは、必要なライブラリをすべてインストールできるパッケージマネージャーです。万が一認識されない場合は、次のコマンドを実行してください。 python -m pip どのような場合でも機能します。.
2.仮想環境の準備
A 仮想環境 Pythonプロジェクトのライブラリを隔離し、マシン上の他のアプリケーションに干渉しないようにします。次のようにして作成します。 python -m venv venv, 、そしてそれを有効にします。そうすれば、インストールされたものはそのプロジェクト専用になります。.
3.スクレイピングに必要なライブラリをインストールする。
あ 図書館 これは、あらかじめプログラムされた関数の集まりで、コード内で直接使用することができます。これにより、すべてを自分で書き直す手間が省け、反復的な作業が簡素化されます。主なものは以下の通りです:
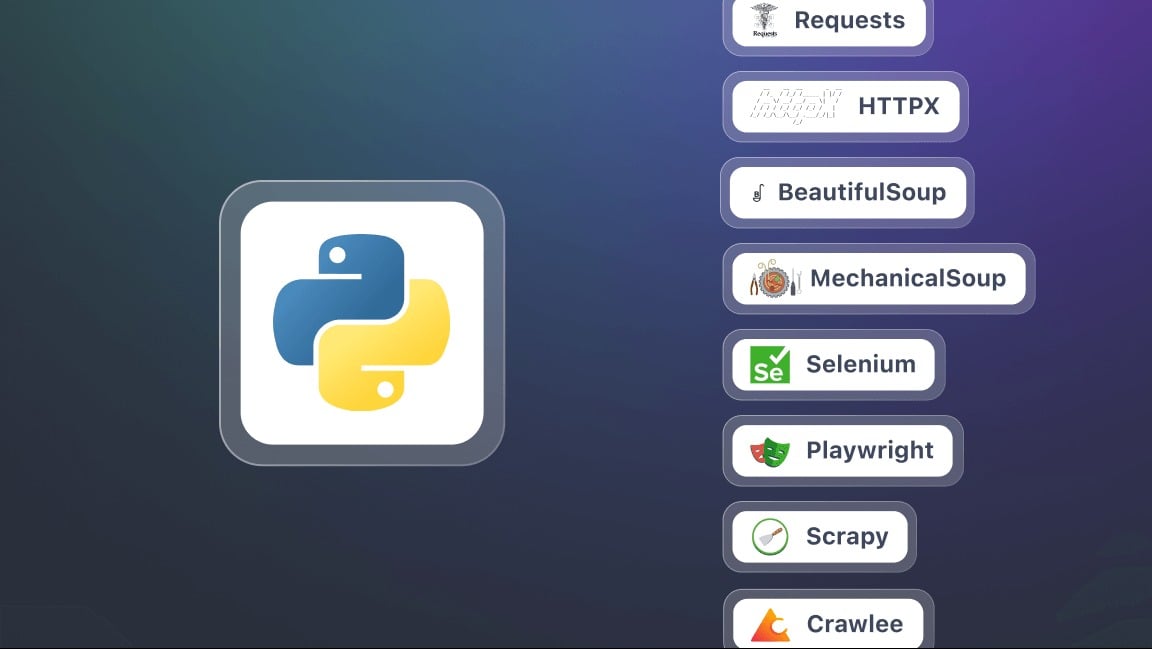
- Requests : HTTPリクエストを送信し、ウェブページのコンテンツを取得します。これは、あらゆるスクレイピング作業の基礎となります。.
- BeautifulSoup : HTMLコードを解析し、次のような便利なセレクタを使って情報を抽出します。 find(), find_all() どこ select().
- Selenium : JavaScriptで動的に生成されるコンテンツがある場合に便利です。実際のブラウザをエミュレートし、ページとやり取りを行います。.
- lxml : 非常に高速なHTMLおよびXML解析ツールで、以下よりも高性能な BeautifulSoup, 、ただ、使いこなすには少し技術的な知識が必要です。.
- Playwright : の現代的な代替案として Selenium, 、多くの場合、より速い。.
- Scrapy : 大規模なスクレイピングプロジェクト向けの強力なフレームワークであり、複数のページやサイトを同時に処理することができる。.
PythonでWebスクレイピングをするには?
ここでは、初めてのスクレイピングプロジェクトを始めるための手順を、段階ごとに説明します。各ステップには、 コードの断片 コピーする準備ができました。.
ステップ 1:ライブラリ(requests および beautifulsoup4)をインストールする
次の2つのライブラリが必要です: requests ページを取得して、 beautifulsoup4 データを抽出するために。次のコマンドで一括インストールしてください。 pip :
pip install requests beautifulsoup4どうにか pip 認識されない場合は、以下を使用してください python -m pip install requests beautifulsoup4, 、これはPATHの設定に関係なく動作します。次に、スクリプトの先頭に次の2行を記述してください:
import requests
from bs4 import BeautifulSoup
ステップ2:HTTPリクエストをしてコンテンツを取得する
ライブラリの準備ができたら、 HTTPリクエスト Webページへ移動し、その内容を表示する。次の’完全なURL リンク先のページ:
輸入リクエスト

url = "https://exemple.com"
page = requests.get(url)

print(page.text) # ページのHTMLコードを表示します。
ここだよ、 page.text 分析対象のサイトのHTMLがすべて含まれています。.
ステップ3:BeautifulSoupを使ってHTMLを解析する
コンテンツを取得できたので、これを使って分析することができます BeautifulSoup. このステップにより、 プレーンHTML 探索しやすい構造に:
from bs4 import BeautifulSoup

soup = BeautifulSoup(page.text, "html.parser")

# 例:ページのタイトルを表示する
print(soup.title.string)
ステップ4:特定のデータ(タイトル、リンクなど)を抽出する。
おかげで BeautifulSoup, 、できるよ 特定のHTMLタグをターゲットにする : 見出し、リンク、段落など。最も一般的な例を2つ挙げると:
# すべてのタイトルを抽出 <h2>
for title in soup.find_all("h2"):
    print(title.get_text())

# すべてのリンクを抽出する <a>
for lien in soup.find_all("a"):
    print(link["href"])
ステップ5:データの保存(CSV、JSON)
データを抽出した後は、それを ファイルに保存する 後で再利用するために。この形式は シーエスブイ 絵画に適しており、 JSON 構造化データ。.
CSVの例:
インポート csv

title = [title.get_text() for title in soup.find_all("h2")].

with open("results.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["Title"])
    for t in titres:
        writer.writerow([t])
JSONの例:
インポート json

liens = [lien["href"] for lien in soup.find_all("a")].

with open("liens.json", "w", encoding="utf-8") as f:
    json.dump(liens, f, indent=4, ensure_ascii=False)
このチュートリアルは、 小さなプロジェクト, 、例えば静的サイトのスクレイピングなど。実際には、すぐにさらに高度な課題に直面することになるでしょう:
- ページネーションの管理 : すべてのデータを取得するには、複数のページにわたってループ処理を行う必要があります。.
- フォームの管理 : POSTリクエストでデータを送信し、フィルタリングされた結果を取得する。.
- 制限の回避 : 現実味のある識別ヘッダーを追加し、以下の手順を経る 代理人 スタックを避けるために。
なぜPythonでウェブスクレイピングなのか?
the Pythonでウェブスクレイピング 具体的な可能性を数多く広げてくれます。ここでは、この習慣が日常生活で本当に役立つ活用法をご紹介します。.
- 価格追跡とeコマース : 商品情報を収集し、その推移を把握する 料金, 、競合他社のオファーを比較し、リアルタイムで最良の機会を見極める。.
- 顧客レビューの分析 : 複数のサイトからコメントを収集し、トレンドを把握し、消費者のニーズを理解して、製品やサービスを改善する。.

- コンテンツ・アグリゲーション : 複数の情報源からのブログ記事やニュースを一元管理し、常に最新の情報を提供するプラットフォームを構築します。.
- 調査・情報収集 :研究のためのデータを収集したり、出版物をチェックしたり、特定の分野を注視したりしている。.
実際には、ウェブスクレイピングを使えば、何時間も手作業でコピー&ペーストする手間を省くことができます。適切に設計されたスクリプト1つあれば、設定した頻度でデータを自動的に取得・更新してくれます。.
Pythonを使ったウェブスクレイピングのベストプラクティスとは?
ウェブスクレイピングとは、単にデータを抽出することだけではありません。それを適切な方法で実施する必要があります。 効果的、責任ある、そして持続可能な, 、そうしないとすぐにブロックされてしまう恐れがあります。適用すべきルールは以下の通りです:
- robots.txtファイルを尊重する : サイトのルートディレクトリにあるもの(例:. exemple.com/robots.txt)、スクレイピングが許可されているページや禁止されているページが一覧表示されます。スクリプトを実行する前に、必ずこれを確認してください。.
- 適切なクエリ実行ペースを維持する : サーバーへの負荷が高まりすぎたり、アカウントが停止されたりしないよう、各リクエストの間に一時停止を挿入します。.
- 適切なUser-Agentを使用する : ヘッダーを入力します User-Agent デフォルト値ではなく、自分のロボットを明確に識別できるもの requests, 、多くの場合、自動的にブロックされてしまう。.
- エラーと例外の処理 : クエリをエラー処理ブロックで囲んでください。ページが利用できないからといって、プログラム全体がクラッシュしてはいけません。.
- プロキシとIPローテーションの利用 : トラフィック量が多い場合、複数のIPアドレスをローテーションさせることで、特定のIPアドレスが特定されてブロックされるのを防ぐことができます。.
- クエリの数を最小限に抑える : 本当に必要なページだけを取得します。リクエスト数が少なければ、サーバーへの負荷も軽減され、検知されるリスクも低くなります。.
- 透明性を保つ : 可能な場合は、[ ] を指定してください 連絡先メールアドレス 君の User-Agent. これにより、サイトの管理者はあなたをブロックする代わりに、連絡を取ることができるようになります。.
- 抽出とバックアップを分離する : まずデータを取得し、それをCSVファイルまたはデータベースに保存します。処理が失敗しても、収集したデータは失われません。.
- 堅牢なセレクタを使用する : 以下のような安定した属性を優先する ID どこ data-* 頻繁に変更されるCSSクラスよりも。そうすれば、あなたのスクリプトはサイトの更新にもより強く対応できるようになります。.
- コードにコメントを付ける : 重要な段階について解説し、以下の点を指摘する スクレイピングの日付. ページの構造は変化していくものだから、万が一不具合が発生した際、何を修正すべきかすぐに理解できるようになるだろう。.
よくある質問
PythonでWebスクレイピングをするのに最適なフレームワークは?
というのも、すべてはそのフレームワーク次第だからだ。 プロジェクトの複雑さ.

- 単純な抽出の場合、 Requests と BeautifulSoup これで十分すぎるほどだ。.
- あるサイトが大量の ジャバスクリプト, 次に Selenium どこ Playwright.
- 最後に、大規模なプロジェクトについては、, Scrapy その性能と頑丈な構造により、依然として最も適した選択肢である。.
Pythonでウェブサイトをスクレイピングするには?
このプロセスは以下に基づいています 3つの主な段階 :
- あなたはそれを送る HTTPリクエスト 対象ページへ。.
- 君はそれを分析している HTML構造 受領しました。.
- あなたは データ 気になるものを選んで、保存します。.
ウェブスクレーパーの役割とは?
the ウェブスクレイパーの役割 ウェブページを自動的に巡回して、テキスト、価格、画像、リンクといった特定のデータを抽出することです。これは、サイトとあなたの間の仲介役として機能し、生の情報を 活用可能なデータ.

PythonでBeautifulSoupを使うには?
BeautifulSoup は、ページのHTMLコードを解析し、抽出したい情報が含まれるタグを簡単に見つけられるように設計されたライブラリです。具体的には、 HTTPリクエストで Requests, その後、その内容を次のように解析する BeautifulSoup 構造をナビゲートして、必要なデータを取得するため。.
JavaScriptで動的なコンテンツを含むウェブサイトをスクレイピングするにはどうすればよいですか?
に大きく依存しているサイトもある。 ジャバスクリプト その内容を表示するには。この場合、従来の解決策としては Requests だけでは不十分だ。そこで、次のような、実際のブラウザをシミュレートできるツールを使用する必要がある。 Selenium どこ Playwright, 、ページを読み込み、操作を行うため。.
ウェブスクレイピングに最もよく使われる言語は何ですか?
Python そのシンプルさと豊富な専用ライブラリのおかげで、現在ではウェブスクレイピングにおいて最も人気のある言語となっています。とはいえ、次の作業も自動化することが可能です。’データ抽出(使用ツール:) PHP, 、とはいえ、この手法はまだあまり普及していない。.
ウェブスクレイピングは合法か?
The ウェブ・スクレイピングの合法性 これは複雑な問題です。すべては、あなたがそれをどのように実践するか、そして以下の事項を遵守するかにかかっています。 使用条件 サイトや収集されるデータの性質によって異なります。フランスでは、ウェブスクレイピングは 場合によっては容認される, 、しかし、アクセス権やサイトの利用規約、あるいは関連する法律に違反する場合は、違法となる可能性があります。 個人データ.
とにかく、Pythonを使ったウェブスクレイピングは、信じられないほど多くの可能性を広げてくれます!皆さんは、どのような経験や疑問をお持ちですか?ぜひコメント欄で共有してください。皆さんの投稿を楽しみにしています!








 JA