PHP dient nicht nur dazu, dynamische Websites zu erstellen. Mit Bibliotheken wie Guzzle und Goutte, kannst du ein funktionaler Scraper und automatisch Daten von jeder beliebigen Webseite zu extrahieren.
Unternehmen nutzen es, um Preise zu überwachen, soziale Medien zu analysieren oder Informationen über ihre Konkurrenten zu sammeln.
Voraussetzungen für das Scraping mit PHP
das Web Scraping besteht darin, Daten automatisch aus Webseiten zu extrahieren. Ein Programm durchläuft die HTML einer Website, filtert relevante Informationen heraus und speichert diese anschließend in einer Datei oder einer Datenbank. In PHP, Es reichen schon wenige Bibliotheken aus, um einen funktionsfähigen Scraper zu erstellen, aber bevor du loslegst, solltest du sicherstellen, dass du die folgenden Voraussetzungen erfüllst:
- Haben Grundlagen der PHP-Programmierung, denn du wirst Code schreiben, um die Extraktion zu steuern.
- Ein paar davon beherrschen Grundkenntnisse in HTML und CSS, um die Elemente auf der Seite, die extrahiert werden sollen, genau auszuwählen.
- Den Umgang damit beherrschen Wählen, das Tool, das PHP-Abhängigkeiten verwaltet und Bibliotheken installiert, wie zum Beispiel Guzzle, Symfony DomCrawler oder Goutte.
- Verfügen Sie über einen lokaler Webserver So führst du dein Programm aus: XAMPP, WAMP Wo MAMP sind dafür bestens geeignet.
- Einen installieren Code-Editor um deine PHP-Skripte zu schreiben und zu organisieren.
Sobald du diese Tools beisammen hast, bist du bereit, die Daten zu erheben und zu analysieren, die dich interessieren. Wenn du nach kostenlose Tools Um ohne Kosten loszulegen, gibt es mehrere Angebote, die für Anfänger geeignet sind.
Welche Tools sind für Web Scraping mit PHP unerlässlich?
PHP allein reicht nicht aus, um Web-Scraping effizient durchzuführen. Es sind die über Composer installierte Bibliotheken die für eine schnelle und zuverlässige Extraktion sorgen. Hier sind die Werkzeuge, die Sie kennen sollten.
1. Guzzle: der HTTP-Client
Guzzle ist hier die meistgenutzte Bibliothek um HTTP-Anfragen zu senden. Damit wird der Quellcode einer Webseite abgerufen. Um das Programm zu installieren, öffne dein Terminal, wechsle in den Ordner deines Projekts und gib Folgendes ein:
composer require guzzlehttp/guzzleComposer Lade die Bibliothek herunter und mache sie direkt in deinem Code nutzbar. Weitere Informationen findest du in der offiziellen Dokumentation zu Guzzle.
Hier ist ein einfaches Beispiel für den Inhalt einer URL abrufen :
request('GET', $url);

    // Wir rufen den HTTP-Code ab.
    $statusCode = $response->getStatusCode();

    // Wir rufen den Inhalt der Seite ab.
    $content = $response->getBody()->getContents();

    echo "HTTP-Code: " . $statusCode . PHP_EOL;
    echo "Inhalt der Seite:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Fehler: " . $e->getMessage();
}
2. Symfony DomCrawler und Goutte: die Datenextraktion
Sobald der HTML-Code abgerufen wurde, muss er analysiert werden, um die relevanten Daten zu extrahieren. Zwei Bibliotheken sind hierfür sehr nützlich:
- Symfony DomCrawler : Damit lässt sich im HTML-Code mit CSS-Selektoren und bestimmte Elemente (Titel, Preis, Link…) gezielt anzusprechen.
- Goutte : Es handelt sich um einen Wrapper für Guzzle und DomCrawler, der den Scraping-Prozess erheblich vereinfacht.
Notieren : das Paket Goutte ist heute seit 2022 veraltet und archiviert. Bei einem neuen Projekt ziehe ich es vor, Symfony BrowserKit mit DomCrawler, Wo Symfony Panther wenn du mit Inhalten arbeiten musst, die per JavaScript geladen werden. Du kannst dir auch den Ansatz mit Laravel, das einen strukturierten Rahmen für diese Art von Projekten bietet.
Beispiel mit Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody()->getContents();
$crawler = new Crawler($html);

// Auswahl nach Klasse
$crawler->filter('.meine-klasse')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Auswahl nach ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Auswahl nach Tag
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Beispiel mit Goutte:
request('GET', 'https://exemple.com');

// Auswahl nach Klasse
$crawler->filter('.meine-klasse')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Auswahl nach ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Auswahl nach Tag
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Andere Bibliotheken und Werkzeuge
Wenn du noch einen Schritt weiter gehen möchtest, gibt es weitere Tools, die sich je nach Umfang der zu erfassenden Daten an deine Bedürfnisse anpassen lassen.
- PHP-Scraper : Eine Bibliothek, die das Extrahieren von Informationen erleichtert, indem sie die Komplexitäten von HTML und Selektoren verwaltet. Ihr eigentliches Paket ist nicht das von Goutte.
# Installation mit Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Titel der Seite: " . $web->title;
- Bright Data : eine professionelle Plattform für die groß angelegte Datenerhebung, mit integrierten Proxys, um IP-Sperren zu vermeiden.

- ScraperAPI : ein cloudbasierter Web-Scraping-Dienst, der über eine API. Du sendest eine einfache Anfrage unter Angabe der zu scrapenden URL, und der Dienst kümmert sich selbst um die Proxys.
Wie erstellt man einen einfachen Web Scraper in PHP?
So baut man einen Funktionaler Scraper in PHP mit Goutte, Schritt für Schritt: Einbindung einer Bibliothek, Abruf des HTML-Codes, Extraktion der Daten und anschließender Export.
Schritt 1: Installation der Abhängigkeiten
Verwende Wählen zu installieren Goutte mit diesem Befehl:
composer require fabpot/drop
Schritt 2: Den Inhalt einer Seite abrufen
Mach eine HTTP GET-Anfrage um den HTML-Inhalt der Seite abzurufen. Hier ist der Grundcode:
request('GET', $url);

// Bei Bedarf rohes HTML abrufen.
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // Vorschau
Schritt 3: Daten extrahieren
Sobald du den HTML-Code abgerufen hast, greifst du mithilfe eines CSS-Selektor (Wo XPath). Hier ein Beispiel für die Überschriften auslesen einer Blogseite. Der Selektor 'artikel h2 zielt auf die Tags ab <h2> innerhalb der Tags . :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Was dieser Code bewirkt:
- Der Wahlschalter
'artikel h2bezieht sich auf die Titel in den Tags<h2>. - Die Methode
text()extrahiert den Text jedes Titels. - Jeder Titel wird der Tabelle hinzugefügt
$itel, und anschließend angezeigt mitprint_r().
CSS-Selektoren dienen auch dazu, Attribute extrahieren HTML-Elemente. Wenn jede Überschrift ein Link innerhalb eines Tags ist <a>, dann rufst du das Attribut ab href Um die URL des Artikels zu erhalten:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
Das Bild $itel enthält dann für jeden Artikel sowohl den Titel und sein Verknüpfung :
Array
(
    [0] => Array
        (
            [title] => Titel des Artikels 1
            [url] => /article1
        )

    [1] => Array
        (
            [title] => Titel von Artikel 2
            [url] => /article2
        )
)
Jeder Eintrag ist ein assoziatives Array mit zwei Schlüsseln: Titel für den Titel und url für die Adresse der Seite. Du erhältst eine übersichtliche Struktur, die zur Analyse oder Speicherung bereit ist.
Schritt 4: Daten strukturieren und speichern
Sobald die Daten in die Tabelle extrahiert wurden $data, du kannst sie exportieren in einem strukturierten Format. Die beiden nützlichsten Formate sind das JSON und die CSV.
das JSON eignet sich gut zur Versorgung einer API oder einer Webanwendung:
``````Die Datei export.json wird in etwa so aussehen:
[
    {
        "title": "Titel von Artikel 1",
        "url": "/article1".
    },
    {
        "title": "Überschrift von Artikel 2",
        "url": "/article2".
    }
]
Wenn du eine Tabelle bevorzugst CSV, verwendet fputcsv Um jede Zeile in eine Datei zu schreiben:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
Die Datei export.csv wird in etwa so aussehen:
title,url
Titel des Artikels 1,/article1
Titel des Artikels 2,/article2
Bei großen Datenmengen solltest du daran denken, in die Datei zu schreiben nach und nach anstatt alles in den Arbeitsspeicher zu laden. Du kannst das Ergebnis auch direkt in einer Datenbank, was anschließend die Analyse und Aktualisierung der gesammelten Informationen erleichtert.
Wie gehe ich mit häufigen Problemen beim Web Scraping in PHP um?
Web-Scraping in PHP läuft nicht immer wie geplant. Ein Server, der nicht antwortet, eine fehlerhaft strukturierte Seite, eine Sperrung aufgrund der IP-Adresse: Solche Probleme treten schnell auf. Hier erfährst du, wie du die häufigsten Probleme bewältigen kannst, um dein Scraping-Programm zuverlässiger zu machen.
1. Mit Fehlern umgehen
- Verbindungsfehler
Manchmal erreicht die Anfrage den Server gar nicht erst. Es kann vorkommen, dass du auf Folgendes stößt: "Kein Netzwerk", "Ungültige URL" Wo "Server nicht erreichbar". In diesem Fall solltest du einen Block einplanen try/catch damit dein Skript nicht abrupt beendet wird.
Hier ist ein konkretes Beispiel mit Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- HTTP-Statuscodes
Selbst wenn die Verbindung funktioniert, kann der Server eine Fehlermeldung zurückgeben: 404 = Seite nicht gefunden, 500 = Interner Serverfehler. Du kannst den zurückgegebenen Code mit getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Parsing-Fehler
Parsing ist das’HTML-Analyse durch deinen Scraper. Wenn die Seite fehlerhaft aufgebaut ist, DomCrawler Wo Goutte können abstürzen oder gar nichts zurückgeben. Überprüfe immer, ob der Inhalt vorhanden ist, bevor du versuchst, ihn abzurufen, beispielsweise mit Bedingungen wie count() Wo filter(), und umschließe dann das Parsing mit einem try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Umgehung von Beschränkungen und Maßnahmen zum Schutz vor Scraping
Viele Websites richten Schutzmaßnahmen ein, um das Web-Scraping zu erschweren. Hier sind die wichtigsten Hindernisse und wie man sie korrekt umgeht:
- Sperrung nach IP-Adresse : Wenn du zu viele Anfragen sendest, kann die Website deine IP-Adresse sperren. Die Lösung besteht darin, über rotierende Proxyserver, wie beispielsweise die von Bright Data, um deine Anfragen auf mehrere Adressen zu verteilen.
- Zeitabstand zwischen den Anfragen : Verteile deine Aufrufe zeitlich, um nicht aufzufallen und den Zielserver nicht zu überlasten.
- Inhalt in JavaScript : Standardmäßig kann PHP nicht JavaScript ausführen. Um eine Seite zu scrapen, deren Inhalt dynamisch geladen wird, benötigst du einen kopfloser Segler (Headless-Browser). Tools wie Puppeteer Wo Selenium stellen die Seite vor der Extraktion wie ein echter Browser dar.
- Datei „robots.txt“ : Bevor du deinen Scraper startest, überprüfe diese Datei im Stammverzeichnis der Website. Sie gibt an, was die Website für Robots zulässt und was nicht – ein wichtiger Schritt, um verantwortungsbewusst zu handeln.
Häufig gestellte Fragen
Ist Web Scraping legal?
Das Legalität von Web Scraping hängt von den gesammelten Daten und davon ab, wie du sie nutzt. In Frankreich ist das Scraping von öffentliche und nicht personenbezogene Daten wird in der Regel toleriert, ist aber kein automatisches grünes Licht.
Drei rechtliche Einschränkungen können dazu führen, dass das Extrahieren selbst auf öffentlichen Seiten rechtswidrig ist:
- das DSGVO : Sobald es um personenbezogene Daten geht, bedeutet «öffentlich» nicht, dass diese frei verwendet werden dürfen.
- Das Nutzungsbedingungen der Website : Wenn du dich mit einem Konto anmeldest, um auf die Inhalte zuzugreifen, hast du damit Nutzungsbedingungen akzeptiert, die das Scraping häufig untersagen.
- das Sui-generis-Recht Zu den Datenbanken: In Europa genießen Datenbanken einen besonderen Schutz.
Konkret wird jeder Fall individuell geprüft. Schau immer in der Datei nach robots.txt und die Nutzungsbedingungen der Website, bevor du dein Programm startest.
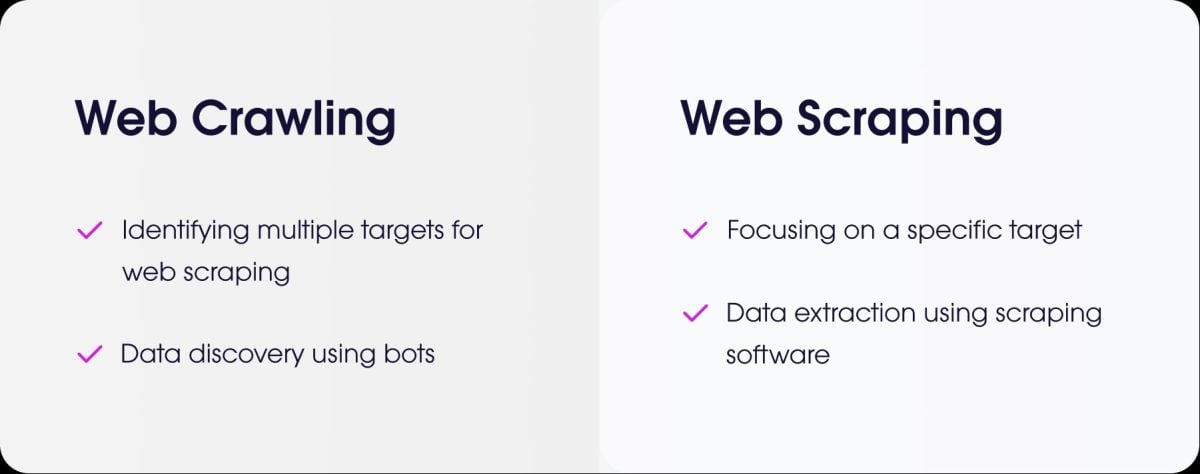
Was ist der Unterschied zwischen Web Scraping und Web Crawling?
- das Web Scraping besteht aus genaue Daten extrahieren auf einer Website.
- das Webcrawling besteht aus Seiten durchsuchen, um sie zu indexieren, so wie es ein Suchmaschinen-Bot tut.
Wie scrape ich eine Seite, die eine Authentifizierung (Login) erfordert?
Um eine Website zu scrapen, für die eine Anmeldung erforderlich ist, muss man die Authentifizierung simulieren. Bei PHP ist die gängigste Lösung nach wie vor Guzzle. Du übermittelst deine Anmeldedaten über eine Anfrage POST, und dann lässt du die Sitzung offen, um die geschützten Seiten abzurufen.
Wie geht man mit dem Scraping von Websites mit dynamischen, in AJAX geladenen Seiten um?
PHP kann den clientseitigen JavaScript-Code nicht ausführen. Der geladene Inhalt in AJAX entzieht sich somit einem klassischen Scraper.
Eine erste Lösung besteht darin, Folgendes zu verwenden BrowserShot, eine Bibliothek, die im Hintergrund auf einem echten Browser basiert (Headless Chrome), um die Seite zu laden und das JavaScript auszuführen.
Du kannst auch PHP mit Tools kombinieren, die auf Node.js, wie Puppeteer Wo Selenium, um den gerenderten HTML-Code zu generieren und anschließend die Daten aus deinem Skript abzurufen.
Gibt es Alternativen zu PHP für Web Scraping?
Ja, es gibt mehrere Programmiersprachen, die beim Web-Scraping sehr beliebt sind:
- Python, mit seinen leistungsstarken Bibliotheken wie BeautifulSoup und Scrapy.
- Node.js, sehr effizient für dynamische Websites, mithilfe von Bibliotheken wie Puppeteer Wo Cheerio.

Wie programmiert man einen Web-Scraper auf ethische und verantwortungsbewusste Weise?
Um verantwortungsbewusst zu scrapen, sollten einige einfache Regeln beachtet werden:
- Überprüfe die Datei „robots.txt“ auf der Website, um sich über die Zugangsbedingungen zu informieren.
- Begrenze die Häufigkeit deiner Anfragen um den Server nicht zu überlasten.
- Beachte die Nutzungsbedingungen der Website.
- Es werden keine personenbezogenen Daten erfasst sensible Daten ohne Genehmigung.
Web-Scraping ist eine leistungsstarke Methode – vorausgesetzt, man wendet sie methodisch und mit gesundem Menschenverstand an. Und du, hast du schon einmal ein scraper in PHP oder mit einer anderen Sprache? Teile uns deine Erfahrungen in den Kommentaren mit!








 DE