PHP tidak hanya berguna untuk membuat situs web dinamis. Dengan pustaka seperti Guzzle dan Goutte, kamu bisa membuat sebuah scraper yang berfungsi dan secara otomatis mengekstrak data dari halaman web mana pun.
Perusahaan-perusahaan menggunakannya untuk memantau harga, menganalisis media sosial, atau mengumpulkan informasi tentang pesaing mereka.
Prasyarat untuk melakukan scraping dengan PHP
itu pengikisan web adalah proses mengekstrak data secara otomatis dari halaman web. Sebuah program menjelajahi HTML dari sebuah situs web, memilih informasi yang berguna, lalu menyimpannya ke dalam berkas atau basis data. Dalam PHP, hanya perlu beberapa pustaka untuk membuat scraper yang berfungsi, tetapi sebelum memulainya, pastikan kamu memenuhi persyaratan berikut:
- Memiliki dasar-dasar pemrograman PHP, karena kamu akan menulis kode untuk mengendalikan proses ekstraksi.
- Menguasai beberapa pengetahuan dasar tentang HTML dan CSS, untuk menentukan dengan tepat elemen-elemen yang akan diekstraksi dari halaman tersebut.
- Mengetahui cara menggunakannya Panggil, alat yang mengelola dependensi PHP dan menginstal pustaka seperti Guzzle, Symfony DomCrawler atau Goutte.
- Memiliki server web lokal untuk menjalankan programmu: XAMPP, WAMP Di mana MAMP sangat cocok untuk keperluan ini.
- Menginstal sebuah editor kode untuk menulis dan mengatur skrip PHP-mu.
Setelah semua alat ini terkumpul, kamu siap untuk mengumpulkan dan menganalisis data yang kamu minati. Jika kamu mencari alat gratis Untuk memulai tanpa mengeluarkan uang, ada beberapa pilihan yang cocok untuk pemula.
Alat bantu apa saja yang penting untuk web scraping dengan PHP?
PHP saja tidak cukup untuk melakukan web scraping secara efektif. Yang diperlukan adalah perpustakaan yang dipasang melalui Composer yang membuat proses ekstraksi menjadi cepat dan andal. Berikut ini adalah alat-alat yang perlu Anda ketahui.
1. Guzzle: klien HTTP
Guzzle adalah perpustakaan yang paling sering digunakan untuk mengirim permintaan HTTP. Komponen inilah yang mengambil kode sumber suatu halaman web. Untuk menginstalnya, buka terminalmu, masuk ke folder proyekmu, lalu ketik:
komposer membutuhkan guzzlehttp / guzzleComposer Unduh pustaka tersebut dan gunakan langsung dalam kode Anda. Anda dapat membaca dokumentasi resmi Guzzle untuk mempelajari lebih lanjut.
Berikut ini adalah contoh sederhana untuk mengambil konten dari sebuah URL :
request('GET', $url);

    // Ambil kode HTTP
    $statusCode = $response->getStatusCode();

    // Mengambil konten halaman
    $content = $response->getBody() -> getContents();

    echo "Kode HTTP : " . $statusCode . PHP_EOL;
    echo "Konten halaman:" . PHP_EOL;
    echo $content;

} catch (\Exception $e) {
    echo "Kesalahan: " . $e-> getMessage();
}
2. Symfony DomCrawler dan Goutte: ekstraksi data
Setelah kode HTML diperoleh, kode tersebut perlu dianalisis untuk mengekstrak data yang berguna. Ada dua pustaka yang sangat berguna untuk tujuan ini:
- Symfony DomCrawler : fitur ini memungkinkan pengguna menavigasi dalam HTML menggunakan Pemilih CSS dan menargetkan elemen-elemen tertentu (judul, harga, tautan…).
- Goutte : ini adalah wrapper untuk Guzzle dan DomCrawler yang sangat mempermudah proses scraping.
Harap dicatat: paket tersebut Goutte sekarang ini tidak lagi digunakan dan disimpan sejak tahun 2022. Untuk proyek baru, lebih baik Symfony BrowserKit dengan DomCrawler, Di mana Symfony Panther jika kamu harus mengelola konten yang dimuat melalui JavaScript. Kamu juga bisa melihat pendekatan dengan Laravel, yang menyediakan kerangka kerja terstruktur untuk jenis proyek ini.
Contoh dengan Symfony DomCrawler :
request('GET', 'https://exemple.com');

$html = $response->getBody() -> getContents();
$crawler = new Crawler($html);

// Seleksi berdasarkan kelas
$crawler->filter('.my-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleksi berdasarkan ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleksi berdasarkan tag
$crawler->filter('h1')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
Contoh dengan Goutte:
request('GET', 'https://exemple.com');

// Pemilihan berdasarkan kelas
$crawler->filter('.ma-class')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleksi berdasarkan ID
$crawler->filter('#mon-id')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});

// Seleksi berdasarkan tag
$crawler->filter('p')->each(function ($node) {
    echo $node->text() . PHP_EOL;
});
3. Perpustakaan dan alat bantu lainnya
Untuk melangkah lebih jauh, ada berbagai alat lain yang dapat disesuaikan dengan kebutuhanmu, tergantung pada volume data yang akan dikumpulkan.
- PHP-Scraper : sebuah pustaka yang memudahkan pengambilan informasi dengan menangani kerumitan HTML dan selektor. Paket aslinya bukanlah Goutte.
# Instalasi dengan Composer
composer require spekulatius/phpscraper
go('https://example.com');
echo "Judul halaman: " . $web->title;
- Data Cerah : sebuah platform profesional untuk pengumpulan data berskala besar, dengan proxy terintegrasi untuk menghindari pemblokiran alamat IP.

- ScraperAPI : layanan pengambilan data web berbasis cloud, yang dapat diakses melalui sebuah API. Kamu cukup mengirimkan permintaan sederhana dengan mencantumkan URL yang akan di-scrape, dan layanan tersebut akan mengelola proxy-nya sendiri.
Bagaimana cara membuat scraper web sederhana di PHP?
Berikut ini cara membuat sebuah scraper fungsional dalam PHP dengan Goutte, langkah demi langkah: menginstal perpustakaan, mengambil kode HTML, mengekstrak data, lalu mengekspor.
Langkah 1: Menginstal dependensi
Gunakan Panggil untuk menginstal Goutte dengan perintah ini:
menulis membutuhkan fabpot/goutte
Langkah 2: Mengambil konten halaman
Lakukan sebuah Permintaan HTTP GET untuk mengambil konten HTML dari halaman tersebut. Berikut ini adalah kode dasarnya:
request('GET', $url);

// Mengambil HTML mentah jika diperlukan
$html = $crawler->html();
echo substr($html, 0, 500) . '...'; // pratinjau
Langkah 3: Ekstrak data
Setelah kode HTML diperoleh, kamu dapat menargetkan elemen-elemen tertentu dengan menggunakan sebuah Pemilih CSS (Di mana XPath). Berikut ini contohnya untuk mengumpulkan judul-judul dari sebuah halaman blog. Selektor item h2 menargetkan tag <h2> di dalam suar <article> :
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les éléments <h2> dans <article> avec le sélecteur CSS
$titres = [];

$crawler->filter('article h2')->each(function ($node) use (&$titres) {
    // Récupérer le texte du titre
    $titres[] = trim($node->text());
});

// Afficher les titres extraits
print_r($titres);
?>
Fungsi kode ini:
- Pemilih
item h2menargetkan teks dalam tag<h2>. - Metode
text()mengambil teks dari setiap judul. - Setiap judul ditambahkan ke tabel
1TP65Judul, kemudian ditampilkan denganprint_r().
Selektor CSS juga berfungsi untuk mengekstrak atribut elemen HTML. Jika setiap judul merupakan tautan dalam tag <a>, kamu mengambil atribut href untuk mendapatkan URL artikel:
<?php
require 'vendor/autoload.php';

use Goutte\Client;

$client = new Client();
$url = 'https://exemple.com/blog'; // Remplace par l'URL de ta page cible

// Faire une requête GET pour récupérer la page
$crawler = $client->request('GET', $url);

// Sélectionner les liens dans les titres
$titres = [];

$crawler->filter('article h2 a')->each(function ($node) use (&$titres) {
    $titre = trim($node->text());
    $lien = $node->attr('href'); // Extraire l'attribut href

    // Ajouter le titre et l'URL au tableau
    $titres[] = [
        'title' => $titre,
        'url'   => $lien,
    ];
});

// Afficher les résultats
print_r($titres);
?>
Tabel 1TP65Judul maka, untuk setiap artikel, berisi baik judul dan tautan :
Array
(
    [0] => Array
        (
            [title] => Judul artikel 1
            [url] => /artikel1
        )

    [1] => Array
        (
            [title] => Judul Artikel 2
            [url] => /artikel2
        )
)
Setiap entri adalah array asosiatif dengan dua kunci: judul untuk judul dan url untuk alamat halaman. Kamu akan mendapatkan struktur yang rapi, siap untuk dianalisis atau disimpan.
Tahap 4: Menata dan menyimpan data
Setelah data diekstraksi ke dalam tabel $data, kamu bisa mengekspor dalam format yang terstruktur. Dua format yang paling berguna adalah JSON dan CSV.
itu JSON berguna untuk memberikan data ke API atau aplikasi web:
<?php
// Exporter les données en JSON
file_put_contents('export.json', json_encode($data, JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE));

echo "Les données ont été exportées en JSON dans 'export.json'.";
?>
File export.json akan terlihat seperti ini:
[
    {
        "title": "Judul Pasal 1",
        "url": "/artikel1"
    },
    {
        "title": "Judul Pasal 2",
        "url": "/artikel2"
    }
]
Jika kamu lebih suka menggunakan tabel CSV, gunakan fputcsv untuk menulis setiap baris ke dalam sebuah berkas:
<?php
// Exporter les données en CSV
$fp = fopen('export.csv', 'w');

// Ajouter l'en-tête (titres des colonnes)
fputcsv($fp, ['title', 'url']);

// Ajouter chaque ligne de données
foreach ($data as $row) {
    fputcsv($fp, [$row['title'], $row['url']]);
}

// Fermer le fichier
fclose($fp);

echo "Les données ont été exportées en CSV dans 'export.csv'.";
?>
File export.csv akan terlihat seperti ini:
judul, url
Judul artikel 1, /artikel1
Judul artikel 2, /artikel2
Untuk volume data yang besar, ingatlah untuk menulis ke dalam berkas secara progresif daripada memuat semuanya ke dalam memori. Kamu juga bisa menyimpan hasilnya langsung ke dalam sebuah basis data, sehingga memudahkan analisis dan pembaruan informasi yang telah dikumpulkan.
Bagaimana cara mengatasi masalah web scraping yang umum terjadi pada PHP?
Web scraping dengan PHP tidak selalu berjalan sesuai rencana. Server yang tidak merespons, halaman yang tidak terstruktur dengan benar, pemblokiran berdasarkan alamat IP: masalah-masalah ini bisa muncul dengan cepat. Berikut ini cara mengatasi masalah yang paling umum agar program ekstraksi kamu lebih andal.
1. Mengelola kesalahan
- Kesalahan koneksi
Terkadang, permintaan tersebut bahkan tidak sampai ke server. Kamu mungkin akan menemui "Tidak ada jaringan, "URL tidak valid Di mana "Server tidak dapat diakses. Dalam hal ini, siapkan sebuah blok try/catch agar skripmu tidak berhenti secara tiba-tiba.
Berikut ini adalah contoh konkret dengan Guzzle :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');

        if ($response->getStatusCode() === 200) {
            $body = $response->getBody();
            echo "Données reçues : " . $body;
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur de la requête : " . $e->getResponse()->getStatusCode();
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Kode status HTTP
Bahkan ketika koneksi berfungsi, server mungkin merespons dengan pesan kesalahan: 404 = halaman tidak ditemukan, 500 = kesalahan internal server. Kamu bisa menguji kode yang dikirimkan dengan getStatusCode() :
<?php
require 'vendor/autoload.php';

use GuzzleHttp\Client;
use GuzzleHttp\Exception\RequestException;

function make_request_with_guzzle() {
    $client = new Client();

    try {
        $response = $client->request('GET', 'https://example.com/api/data');
        $status_code = $response->getStatusCode();

        if ($status_code === 200) {
            $body = $response->getBody();
            echo "Réponse réussie avec le code : " . $status_code . "
";
            echo "Données reçues : " . $body;
        } elseif ($status_code === 404) {
            echo "Erreur 404 : Page non trouvée
";
        } elseif ($status_code === 500) {
            echo "Erreur 500 : Erreur interne du serveur
";
        } else {
            echo "Code de statut : " . $status_code . "
";
        }

    } catch (RequestException $e) {
        if ($e->hasResponse()) {
            echo "Erreur HTTP : " . $e->getResponse()->getStatusCode() . "
";
        } else {
            echo "Erreur de connexion : " . $e->getMessage();
        }
    }
}

make_request_with_guzzle();
?>
- Kesalahan penguraian
Parsing adalah’analisis HTML oleh scraper-mu. Jika halaman tersebut tidak terstruktur dengan baik, DomCrawler Di mana Goutte dapat mengalami kegagalan atau tidak mengembalikan apa pun. Selalu pastikan bahwa konten tersebut ada sebelum mencoba mengekstraknya, dengan kondisi seperti count() Di mana filter(), lalu kelilingi proses parsing dengan sebuah try/catch :
<?php
require 'vendor/autoload.php';

use Goutte\Client;
use Symfony\Component\DomCrawler\Crawler;

function scrape_website() {
    $client = new Client();

    try {
        $crawler = $client->request('GET', 'https://example.com');
        $elements = $crawler->filter('div.target-element');

        if ($elements->count() > 0) {
            $content = $elements->first()->text();
            echo "Contenu extrait : " . $content;
        } else {
            echo "L'élément cible n'a pas été trouvé sur la page.";
        }

    } catch (Exception $e) {
        echo "Erreur lors du parsing de la page : " . $e->getMessage();
    }
}

scrape_website();
?>
2. Mengatasi batasan dan perlindungan anti-scraping
Banyak situs web menerapkan langkah-langkah pengamanan untuk mempersulit web scraping. Berikut adalah hambatan-hambatan utama dan cara mengatasinya dengan benar:
- Pemblokiran berdasarkan IP : jika kamu mengirim terlalu banyak permintaan, situs tersebut bisa memblokir alamat IP-mu. Solusinya adalah dengan menggunakan proksi bergilir, seperti yang ada di Bright Data, untuk mendistribusikan permintaanmu ke beberapa alamat.
- Jarak antar permintaan : atur jadwal panggilanmu agar tidak terdeteksi dan tidak membebani server tujuan.
- Konten dalam JavaScript secara default, PHP tidak dapat menjalankan JavaScript. Untuk melakukan scraping pada halaman yang isinya dimuat secara dinamis, kamu memerlukan sebuah browser tanpa antarmuka pengguna (browser tanpa antarmuka). Alat-alat seperti Puppeteer Di mana Selenium menampilkan halaman seperti browser sungguhan sebelum proses ekstraksi.
- Berkas robots.txt : sebelum menjalankan scraper-mu, periksa berkas ini yang ada di direktori akar situs. Berkas ini menjelaskan apa saja yang diizinkan dan tidak diizinkan oleh situs tersebut bagi robot, sebuah langkah penting untuk bertindak secara bertanggung jawab.
FAQ
Apakah web scraping legal?
Itu legalitas web scraping tergantung pada data yang dikumpulkan dan cara kamu memanfaatkannya. Di Prancis, melakukan scraping terhadap data publik dan non-pribadi umumnya ditoleransi, tetapi hal itu bukan berarti otomatis mendapat lampu hijau.
Tiga batasan hukum dapat membuat pengambilan data menjadi ilegal, bahkan pada halaman publik:
- itu RGPD : begitu menyangkut data pribadi, istilah «publik» tidak berarti bebas digunakan.
- Itu Ketentuan Penggunaan Situs : jika kamu menggunakan akun untuk mengakses konten, berarti kamu telah menyetujui ketentuan yang sering kali melarang praktik scraping.
- itu hak sui generis mengenai basis data: di Eropa, sebuah basis data mendapat perlindungan khusus.
Secara praktis, setiap kasus dievaluasi secara individual. Selalu periksa berkas tersebut robots.txt dan ketentuan penggunaan situs ini sebelum memulai programmu.
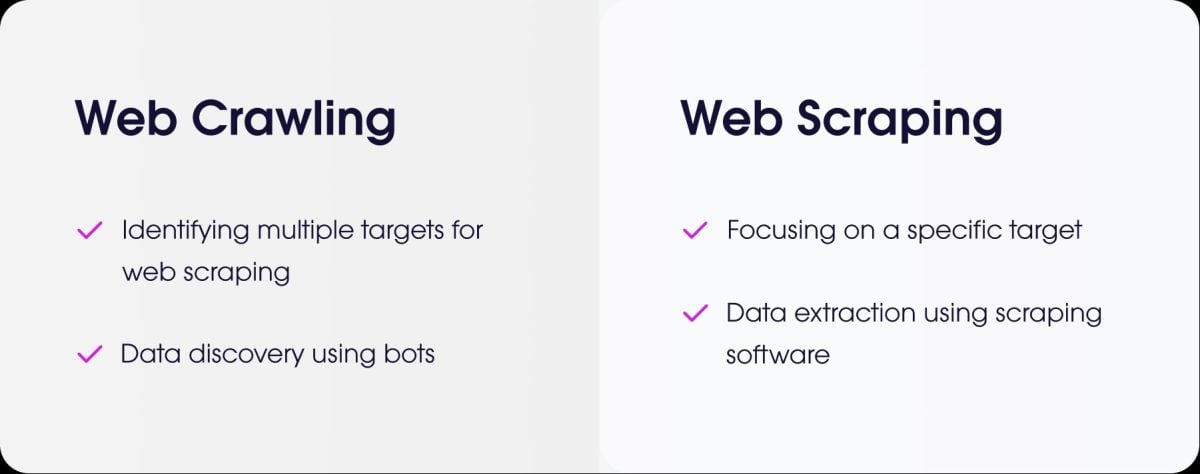
Apa perbedaan antara web scraping dan web crawling?
- itu pengikisan web adalah untuk mengambil data yang akurat di sebuah situs web.
- itu perayapan web adalah untuk menelusuri halaman-halaman untuk mengindeksnya, seperti yang dilakukan oleh robot mesin pencari.
Bagaimana cara mengikis situs yang memerlukan autentikasi (login)?
Untuk melakukan scraping pada situs yang memerlukan login, Anda perlu mensimulasikan otentikasi. Dengan PHP, solusi yang paling umum tetaplah Guzzle. Kamu mengirimkan detail loginmu melalui sebuah permintaan POST, lalu biarkan sesi tetap terbuka untuk mengakses halaman-halaman yang dilindungi.
Bagaimana Anda mengelola scraping situs dengan halaman dinamis yang dimuat dalam AJAX?
PHP tidak dapat menjalankan kode JavaScript di sisi klien. Konten yang dimuat di AJAX sehingga tidak dapat dideteksi oleh scraper konvensional.
Salah satu solusi yang bisa dicoba adalah dengan menggunakan BrowserShot, sebuah pustaka yang didukung oleh browser sungguhan di latar belakang (Headless Chrome) untuk memuat halaman dan menjalankan JavaScript.
Kamu juga bisa mengintegrasikan PHP dengan alat-alat berbasis Node.jssebagai Puppeteer Di mana Selenium, untuk menghasilkan kode HTML yang ditampilkan dan kemudian mengambil data dari skripmu.
Apakah ada alternatif lain selain PHP untuk web scraping?
Ya, ada beberapa bahasa pemrograman yang sangat populer untuk scraping:
- Python, dengan pustaka-pustaka yang mumpuni seperti BeautifulSoup dan Scrapy.
- Node.js, sangat efektif untuk situs dinamis, melalui pustaka seperti Puppeteer Di mana Cheerio.

Bagaimana cara membuat program scraper secara etis dan bertanggung jawab?
Untuk melakukan scraping secara bertanggung jawab, ada beberapa aturan sederhana yang harus dipatuhi:
- Periksa berkas robots.txt di situs ini untuk mengetahui aturan aksesnya.
- Batasi frekuensi permintaanmu agar server tidak kelebihan beban.
- Patuhi ketentuan penggunaan dari situs tersebut.
- Tidak mengumpulkan data pribadi tanpa izin.
Web scraping adalah praktik yang sangat efektif, asalkan digunakan dengan sistematis dan penuh pertimbangan. Bagaimana denganmu, apakah kamu sudah pernah membuat sebuah pengikis dalam PHP atau dengan bahasa pemrograman lain? Bagikan pengalamanmu di kolom komentar!








 ID