Per creare un bot per il web scraping, ti serve Python, della biblioteca Requests per recuperare le pagine e di BeautifulSoup per estrarne i dati.
Questa guida ti spiega come creare uno script funzionante in 5 passaggi. Un bot di web scraping è un programma automatizzato che raccoglie dati su Internet dai siti web: scansiona le pagine, estrae le informazioni utili e le salva per un utilizzo successivo.
Prima di avviare il tuo bot, ricordati di controllare il file robots.txt del sito di destinazione per sapere quali pagine puoi visitare.

Requisiti per la creazione di un bot di scraping web
La prima cosa da scegliere è il tuo linguaggio di programmazione. È proprio questo aspetto a determinare gli strumenti disponibili e la facilità di attuazione.
- Python : il linguaggio più diffuso per il web scraping. È facile da imparare e dispone di un ecosistema molto ricco di librerie per l'estrazione dei dati.
- Node.js : ideale per le attività asincrone, con strumenti molto collaudati (Puppeteer, Playwright) per estrarre i dati dai siti dinamici basati su JavaScript.
- Altre lingue : per alcuni progetti, puoi anche rivolgerti al web scraping con PHP.
Una volta scelto il linguaggio, ti servono quelli giusti biblioteche. Sono proprio queste che fanno davvero il lavoro. Ecco le più utili a seconda dell’ambiente.
Per Python :
- Requests : invia dei Richieste HTTP per recuperare il contenuto di una pagina.
- BeautifulSoup : analizza il HTML e consente di estrarne le informazioni utili (testo, prezzi, link, immagini).
- Scrapy : un framework completo per i progetti di scraping più ambiziosi, con gestione delle richieste su larga scala.
Per Node.js :
- Axios Dove Fetch : per inviare le richieste HTTP.
- Cheerio : l'equivalente di BeautifulSoup, molto utile per navigare e manipolare il DOM.
- Puppeteer Dove Playwright : indispensabili per lo scraping dei siti dinamici. Gestiscono un vero browser ed eseguono il codice JavaScript della pagina.
Tutorial per la creazione di un bot per lo scraping del web
Creare un bot per lo scraping può sembrare complesso, ma in realtà è molto semplice. Seguendo questi 5 passaggi, otterrai uno script funzionante per raccogliere dati dal web. Assicurati di aver installato Python e le librerie necessarie prima di iniziare.
Fase 1: analisi del sito di destinazione
Prima di scrivere qualsiasi codice, devi sapere dove si trovano i dati nella pagina. Questa fase di’analisi determina tutto il resto.
- Apri il sito di destinazione nel tuo browser.
- Fai clic con il tasto destro del mouse, quindi seleziona Ispezionare sull'elemento che ti interessa.
- Indica i tag HTML, le classi o gli ID che contengono il contenuto da estrarre (ad esempio
.prodotto,.titolo,.prezzo). - Metti alla prova le tue Selettori CSS nella console. Se i titoli dei prodotti sono racchiusi tra tag
<h2>, riutilizzerai questo selettore nel tuo codice.
Passo 2: invio di una richiesta HTTP
Il tuo bot si comporta come un browser: invia una Richiesta HTTP al server, che restituisce il codice HTML della pagina. Questo è il compito della libreria Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # errore se codice 4xx o 5xx
html = resp.text
print(html[:500])  # anteprima
Passo 3: Parsing del contenuto HTML
Una volta recuperata la pagina, devi trasformare questo codice HTML grezzo in un oggetto gestibile. Questo è il compito di BeautifulSoup, la libreria di riferimento per l'estrazione di dati dall'HTML.
# pip installare beautifulsoup4
da bs4 importa BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

prodotti = soup.select(".product")
print(f "Prodotti trovati: {len(products)}")

per p in prodotti[:3]:
    title = p.select_one("h2.title").get_text(strip=True)
    price = p.select_one(".price").get_text(strip=True)
    link = p.select_one("a")["href"]
    print({"titolo": titolo, "prezzo": prezzo, "link": link})
Fase 4: Estrazione dei dati
Questa è la fase più concreta: andare a prendere i informazioni precise come titoli, prezzi e link. Puoi anche ripulirli al contempo, ad esempio convertendo un prezzo del testo in base alla quantità.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Passo 5: Backup dei dati
Per non perdere i tuoi risultati, salvali in un file. I due formati più comuni sono il CSV (foglio di calcolo) e il JSON (ideale per alimentare una database o un'API).
Importazione di csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
con open("export/products.csv", "w", newline="", encoding="utf-8") as f:
    fields = ["title", "price", "url"]
    writer = csv.DictWriter(f, fieldnames=fields, delimiter=";")
    writer.writeheader()
    writer.writerows(data)

# JSON
con open("export/products.json", "w", encoding="utf-8") come f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("Esportazione completata!")
Ora disponi di un bot di scraping completo: invia una richiesta, analizza l'HTML, estrae il contenuto e salva i dati in un file CSV o JSON. Si tratta di una solida base per automatizzare la raccolta dei dati sulla maggior parte dei siti statici.
Come gestire le protezioni anti-scraping?
I siti web adottano diversi meccanismi per proteggere i propri dati contro i bot. Comprendere queste misure di protezione è fondamentale per eseguire lo scraping in modo responsabile ed evitare di essere bloccato.
Il file robots.txt
il file robots.txt indica quali pagine un bot può o non può scansionare su un sito. Attenzione: controlla il crawl, non l’indicizzazione, e il suo rispetto dipende dalla buona volontà dei robot.
Controlla sempre questo file prima di avviare il tuo scraper. Rispettarlo riduce i rischi, ma non è sufficiente a rendere legale la tua raccolta: i condizioni di utilizzo del sito e il RGPD si applicano anche queste.
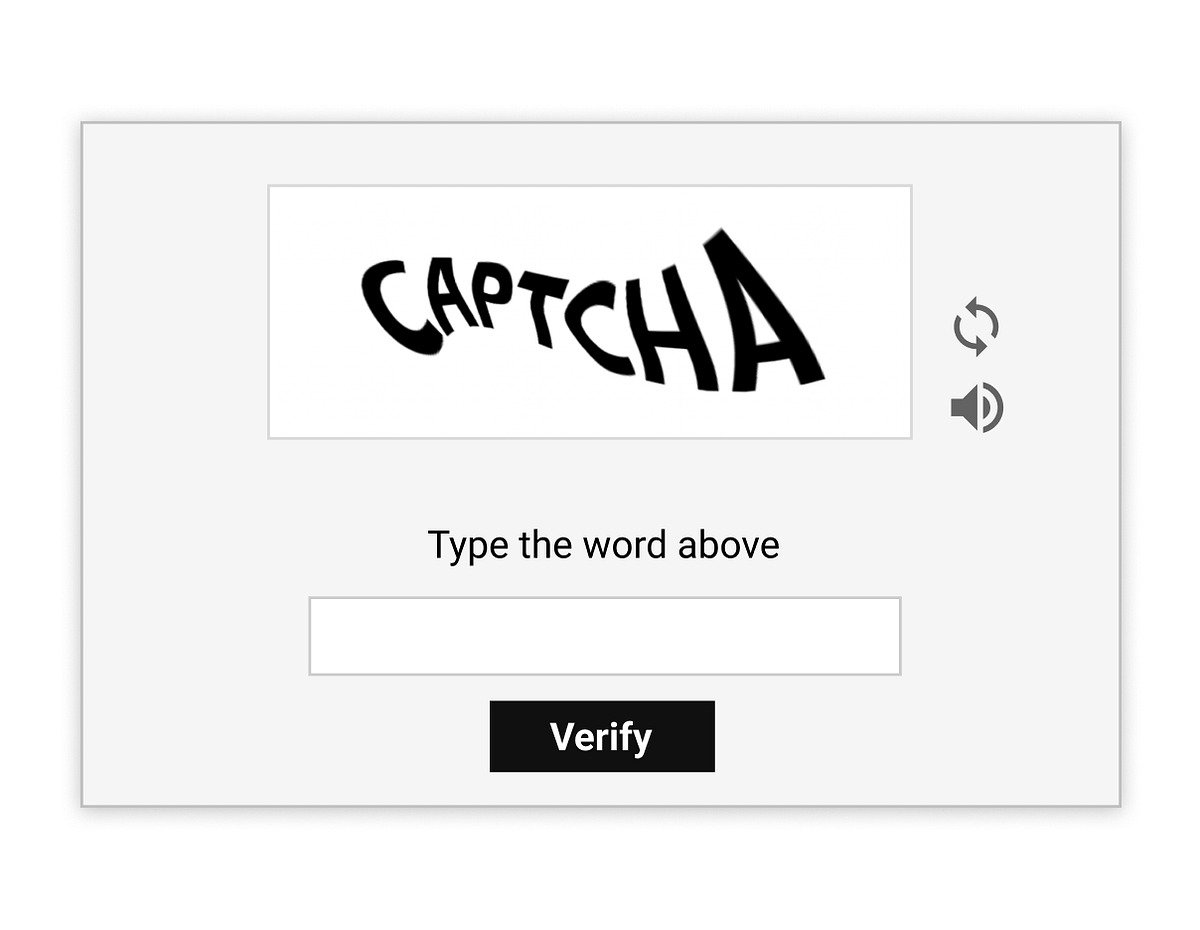
I captcha
il captcha serve a verificare che l'utente sia effettivamente una persona. È una delle misure di protezione più efficaci contro lo scraping automatico.
Per limitarne la comparsa, puoi utilizzare librerie di automazione che simulano un vero browser. Esistono anche servizi di terzi specializzati nella risoluzione dei captcha, utili quando il volume delle richieste diventa elevato.
Blocchi in base all'indirizzo IP
Alcuni siti rilevano un gran numero di richieste provenienti dallo stesso Indirizzo IP e bloccano l'accesso. È il tipico segnale di un bot che raccoglie dati troppo velocemente.
Per evitarlo, usa dei deleghe o uno vpn per cambiare regolarmente l'indirizzo IP. Aggiunge inoltre un intervallo di tempo tra una richiesta e l'altra per simulare una navigazione umana.
Blocchi in base all'User-Agent
I siti possono rifiutare le richieste provenienti da bot identificati da un User-Agent sospetto. In assenza di un User-Agent valido, molti server restituiscono un errore 403 oppure una pagina vuota.
Il trucco sta nel definire un User-Agent realistico nelle tue richieste HTTP per sembrare un browser tradizionale. Tieni però presente che non è l'unico ostacolo: anche i cookie e l'impronta del browser hanno la loro importanza.
Siti in JavaScript
Alcune pagine caricano i propri contenuti tramite JavaScript, il che impedisce alle semplici richieste HTTP di recuperare i dati. L'HTML ricevuto risulta quindi privo delle informazioni che stai cercando.
In questo caso, ricorri a strumenti in grado di eseguire il JavaScript: Selenium, Playwright Dove Puppeteer. Gestiscono un vero e proprio browser e ti consentono di estrarre i dati una volta che la pagina è stata completamente caricata.
Domande frequenti
Qual è la differenza tra un bot di web scraping e un web crawler?
| Scraping del web | Web crawler |
|---|---|
| Il bot si concentra su dati precisi : titoli, prezzi, link ai prodotti. Legge il codice HTML, individua gli elementi rilevanti e li estrae per utilizzarli in seguito (analisi, archiviazione in un database, esportazione in formato CSV o JSON). | Il crawler è un programma che esplora automaticamente le pagine seguendo i link per scoprire i contenuti. Il suo obiettivo è quello di mappare e indicizzare il web, non necessariamente di estrarne dati precisi. |
Il web scraping è legale?
Il legalità del web scraping dipende dal sito, dal tipo di dati raccolti e dall'uso che ne fai. Spesso è possibile estrarre dati pubblici, ma «pubblico» non significa «di libero utilizzo». Molte aziende utilizzano il web scraping per analisi di mercato oppure per raccogliere informazioni disponibili pubblicamente su Internet.
D'altra parte, non appena si tratta di dati personali, il RGPD regola rigorosamente la raccolta dei dati (base giuridica valida, minimizzazione dei dati), pena sanzioni severe. Verifica sempre i condizioni di utilizzo del sito di destinazione prima di avviare il tuo bot.
Quali tipi di dati possono essere estratti con un bot di web scraping?
Con un bot di scraping puoi raccogliere:
- Delle titoli e descrizioni di prodotti.
- Delle prezzi e offerte (utile per il scraping dei prezzi e il monitoraggio delle tariffe della concorrenza).
- Delle collegamenti interni o esterni.
- Delle recensioni e valutazioni degli utenti.
- Informazioni di contatto (si tratta di dati personali, soggetti al GDPR).
- Delle contenuti testuali o immagini pagine web.
Questi dati vengono spesso utilizzati per la intelligenza competitiva o all'analisi di mercato.
Come può un sito web rilevare il mio bot di scraping?
I siti spesso individuano i bot grazie a comportamenti anomali, come:
- Una velocità delle richieste troppo elevata o troppo regolare.
- UN Agente utente non standard, che fa pensare a uno scraper.
- L'mancato caricamento delle risorse JavaScript necessari per la pagina.
- Una navigazione senza cookie, poco naturale per un essere umano.
Quali sono le sfide più comuni quando si crea un bot per lo scraping del web?
Creare un bot efficace non è sempre facile. Ecco le difficoltà più comuni:
- Il strutture HTML incoerenti : un sito può modificare le proprie classi CSS da un giorno all’altro e il tuo selettore potrebbe non restituire più alcun risultato.
- Il dati non strutturati : devi pulire e riformattare il contenuto prima di salvarlo.
- Il lentezza di caricamento delle pagine, soprattutto sui siti dinamici che visualizzano i propri contenuti tramite JavaScript.
Esistono servizi o API per il web scraping?
Sì. Esistono servizi che semplificano lo scraping e gestiscono gli aspetti più complessi: proxy, captcha, siti dinamici. Puoi anche utilizzare un API di scraping del web per recuperare direttamente dati strutturati. Bright Data è una delle soluzioni più complete disponibili sul mercato.
Per approfondire l'argomento, consulta la nostra guida su scraping del web con Python e scopri casi d'uso più avanzati.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA