Para crear un bot de web scraping, necesitas Python, de la biblioteca Requests para recuperar las páginas y de BeautifulSoup para extraer los datos.
Esta guía te muestra cómo crear un script funcional en 5 pasos. Un bot de web scraping es un programa automatizado que recopila datos de Internet a partir de páginas web: recorre las páginas, extrae la información útil y la almacena para su uso posterior.
Antes de poner en marcha tu bot, no olvides comprobar el archivo robots.txt del sitio web de destino para saber qué páginas puedes visitar.

Requisitos para crear un bot de raspado web
Lo primero que tienes que elegir es tu lenguaje de programación. Es este factor el que determina las herramientas disponibles y la facilidad de implementación.
- Python : el lenguaje más popular para el web scraping. Es fácil de aprender y cuenta con un amplio ecosistema de bibliotecas para extraer datos.
- Node.js : ideal para tareas asíncronas, con herramientas muy consolidadas (Puppeteer, Playwright) para extraer datos de sitios web dinámicos que utilizan JavaScript.
- Otros idiomas : para algunos proyectos, también puedes recurrir al web scraping con PHP.
Una vez elegido el idioma, necesitas las adecuadas bibliotecas. Son ellas las que realmente hacen el trabajo. Estas son las más útiles según el entorno.
Para Python :
- Requests : envía Peticiones HTTP para recuperar el contenido de una página.
- BeautifulSoup : analiza el HTML y permite extraer la información útil (texto, precios, enlaces, imágenes).
- Scrapy : un marco completo para los proyectos de scraping más ambiciosos, con gestión de solicitudes a gran escala.
Para Node.js :
- Axios Donde Fetch : para enviar las solicitudes HTTP.
- Cheerio : el equivalente a BeautifulSoup, muy práctico para navegar y manipular el DOM.
- Puppeteer Donde Playwright : imprescindibles para extraer datos de sitios web dinámicos. Controlan un navegador real y ejecutan el código JavaScript de la página.
Tutorial para crear un bot de raspado web
Crear un bot de scraping puede parecer complicado, pero en la práctica es muy sencillo. Siguiendo estos 5 pasos, obtendrás un script operativo para recopilar datos de la web. Asegúrate de haber instalado Python y las bibliotecas necesarias antes de empezar.
Paso 1: Analizar el lugar de destino
Antes de programar nada, tienes que saber dónde se encuentran los datos en la página. Este paso de’análisis condiciona todo lo demás.
- Abre el sitio web de destino en tu navegador.
- Haz clic con el botón derecho del ratón y, a continuación, selecciona Inspeccionar sobre el tema que te interese.
- Identifica las etiquetas HTML, las clases o los ID que contienen el contenido que se va a extraer (por ejemplo,
.producto,.título,.precio). - Prueba tus Selectores CSS en la consola. Si los títulos de los productos están entre etiquetas
<h2>, volverás a utilizar este selector en tu código.
Paso 2: Envío de una solicitud HTTP
Tu bot se comporta como un navegador: envía una Solicitud HTTP al servidor, que devuelve el código HTML de la página. Esa es la función de la biblioteca Requests.
# pip install requests
import requests

url = "https://exemple.com/produits"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=15)
resp.raise_for_status() # error si el código es 4xx o 5xx
html = resp.text
print(html[:500])  # vista previa
Paso 3: Análisis del contenido HTML
Una vez recuperada la página, debes convertir ese código HTML sin formato en un objeto con el que se pueda trabajar. De eso se encarga BeautifulSoup, la biblioteca de referencia para extraer datos de archivos HTML.
# pip install beautifulsoup4
from bs4 import BeautifulSoup

soup = BeautifulSoup(html, "html.parser")

productos = soup.select(".producto")
print(f "Productos encontrados : {len(productos)}")

for p in productos[:3]:
    title = p.select_one("h2.title").get_text(strip=True)
    precio = p.select_one(".precio").get_text(strip=True)
    enlace = p.select_one("a")["href"]
    print({"título": título, "precio": precio, "enlace": enlace})
Paso 4: Extraer los datos
Esta es la etapa más concreta: ir a buscar los información precisa como los títulos, los precios y los enlaces. También puedes limpiarlos de paso, por ejemplo, convirtiendo un precio del texto por cantidad.
from urllib.parse import urljoin

base_url = "https://exemple.com"
data = []

for p in soup.select(".product"):
    titre = p.select_one("h2.title").get_text(strip=True)
    prix_txt = p.select_one(".price").get_text(strip=True)
    lien_rel = p.select_one("a")["href"]
    lien_abs = urljoin(base_url, lien_rel)

    # normalisation prix
    prix = float(
        prix_txt.replace("€", "")
        .replace("\u202f", "").replace("\xa0", "").replace(" ", "")  # espaces des milliers
        .replace(",", ".")
        .strip()
    )

    data.append({"titre": titre, "prix": prix, "url": lien_abs})

print(data[:5])
Paso 5: Copia de seguridad de los datos
Para no perder tus resultados, guárdalos en un archivo. Los dos formatos más habituales son el CSV (hoja de cálculo) y el JSON (ideal para alimentar una base de datos o una API).
importar csv, json, pathlib

pathlib.Path("export").mkdir(exist_ok=True)

# CSV
with open("export/products.csv", "w", newline="", encoding="utf-8") as f:
    fields = ["título", "precio", "url"]
    writer = csv.DictWriter(f, fieldnames=campos, delimiter=";")
    writer.writeheader()
    writer.writerows(datos)

# JSON
with open("export/products.json", "w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=2)

print("¡Exportación completada!")
Ahora ya tienes un bot de scraping completo: envía una solicitud, analiza el HTML, extrae el contenido y guarda los datos en un archivo CSV o JSON. Es una base sólida para automatizar la recopilación de datos en la mayoría de las páginas web estáticas.
¿Cómo gestionar las medidas de protección contra el scraping?
Los sitios web implementan varios mecanismos para proteger sus datos contra los robots. Entender estas medidas de protección es fundamental para realizar el scraping de forma responsable y evitar que te bloqueen.
El archivo robots.txt
la archivo robots.txt indica qué páginas puede o no puede rastrear un bot en un sitio web. Atención: controla el crawl, no la indexación, y su cumplimiento depende de la buena voluntad de los robots.
Comprueba siempre este archivo antes de poner en marcha tu scraper. Cumplirlo reduce los riesgos, pero no basta para que tu recopilación de datos sea legal: los condiciones de uso del sitio web y el RGPD también se aplican.
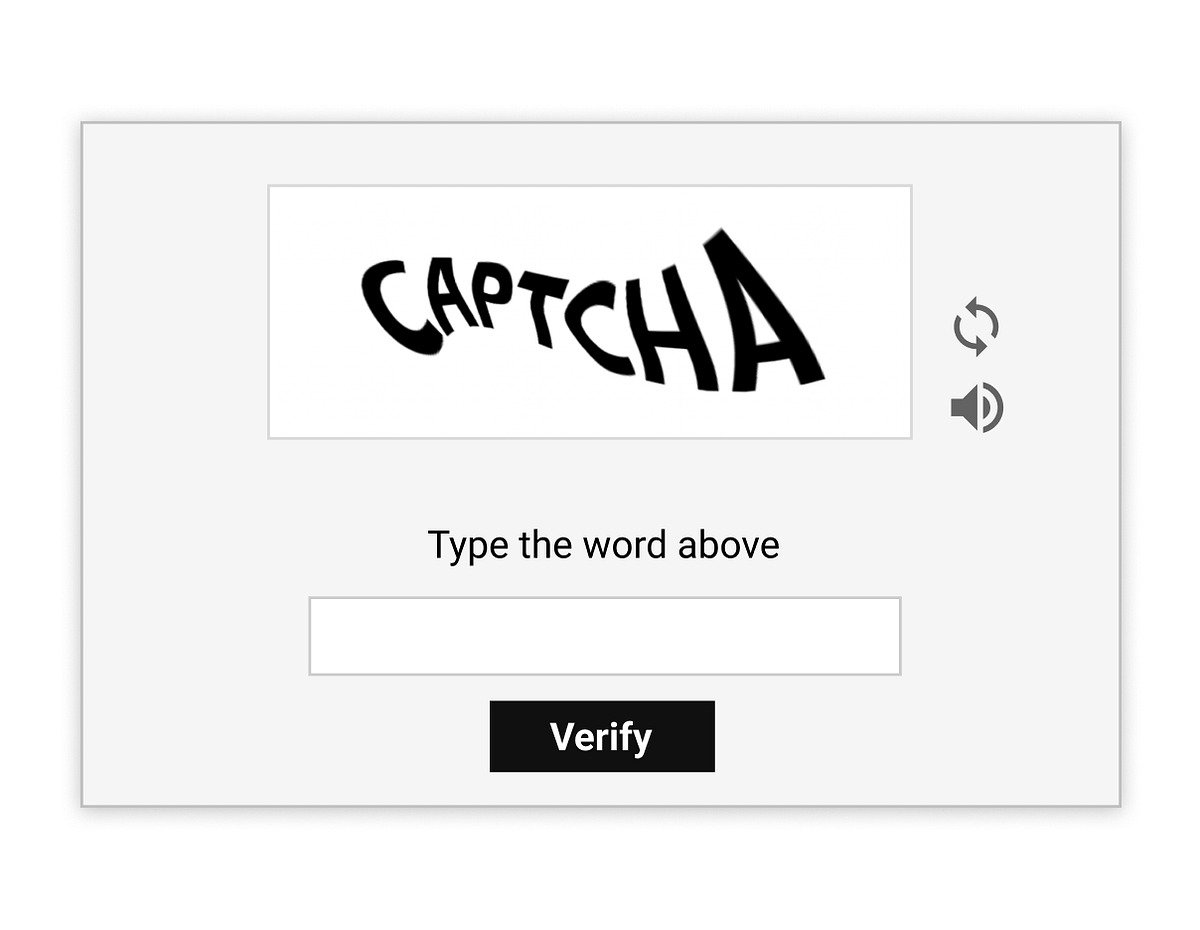
Los captchas
la captcha Sirve para comprobar que el usuario es realmente humano. Es una de las medidas de protección más eficaces contra el scraping automático.
Para limitar su aparición, puedes utilizar bibliotecas de automatización que simulen un navegador real. También existen servicios de terceros especializados en la resolución de captchas, muy útiles cuando el volumen de solicitudes es elevado.
Bloqueos por dirección IP
Algunos sitios web detectan un gran número de solicitudes procedentes de la misma Dirección IP y bloquean el acceso. Es la señal típica de un bot que recopila datos demasiado rápido.
Para evitarlo, utiliza apoderados o un VPN para cambiar de IP con regularidad. Además, añade un intervalo entre cada solicitud para imitar la navegación de un usuario real.
Bloqueos por User-Agent
Los sitios web pueden rechazar las solicitudes procedentes de bots identificados mediante un User-Agent sospechoso. Sin un User-Agent válido, muchos servidores devuelven un error 403 o una página en blanco.
El truco consiste en definir un User-Agent realista en tus solicitudes HTTP para que parezcan las de un navegador convencional. Sin embargo, ten en cuenta que esa no es la única barrera: las cookies y la huella del navegador también influyen.
Las páginas web en JavaScript
Algunas páginas cargan su contenido a través de JavaScript, lo que impide que las simples solicitudes HTTP recuperen los datos. El código HTML recibido no contiene, por tanto, la información que buscas.
En ese caso, opta por herramientas capaces de ejecutar JavaScript: Selenium, Playwright Donde Puppeteer. Funcionan como un navegador real y te permiten extraer los datos una vez que la página se ha cargado por completo.
preguntas frecuentes
¿Cuál es la diferencia entre un bot de raspado web y un rastreador web?
| Web scraping | Rastreador web |
|---|---|
| El bot se centra en datos precisos : títulos, precios, enlaces a productos. Lee el código HTML, identifica los elementos relevantes y los extrae para utilizarlos posteriormente (análisis, almacenamiento en una base de datos, exportación a CSV o JSON). | El rastreador es un programa que recorre automáticamente las páginas siguiendo los enlaces para descubrir contenidos. Su objetivo es mapear e indexar la web, no necesariamente extraer datos concretos de ella. |
¿Es legal el web scraping?
Él legalidad del web scraping Depende del sitio web, del tipo de datos recopilados y del uso que les des. A menudo es posible extraer datos públicos, pero «público» no significa «de libre uso». Muchas empresas utilizan el web scraping para análisis de mercado o para recopilar información de acceso público en Internet.
En cambio, en cuanto tocas algo como datos personales, la RGPD regula estrictamente la recogida de datos (base jurídica válida, minimización de datos), bajo pena de sanciones severas. Comprueba siempre los condiciones de uso del sitio web de destino antes de poner en marcha tu bot.
¿Qué tipos de datos se pueden extraer con un bot de web scraping?
Con un bot de scraping, puedes recopilar:
- Desde títulos y descripciones de productos.
- Desde precios y ofertas (útil para el raspado de precios y el seguimiento de las tarifas de la competencia).
- Desde enlaces internos o externos.
- Desde opiniones y valoraciones de los usuarios.
- Datos de contacto (se trata de datos personales, sujetos al RGPD).
- Desde contenido textual o imágenes páginas web.
Estos datos suelen utilizarse para la inteligencia competitiva o al análisis de mercado.
¿Cómo puede un sitio web detectar mi bot de raspado?
Los sitios web suelen detectar los bots a través de comportamientos anómalos, como:
- A velocidad de las consultas demasiado alta o demasiado constante.
- UN Agente de usuario no estándar, lo que delata a un rastreador.
- L'No se cargan los recursos JavaScript necesarios para la página.
- A navegación sin cookies, poco natural para un ser humano.
¿Cuáles son los retos más comunes a la hora de crear un bot de web scraping?
Crear un bot eficaz no siempre es fácil. Estos son los retos más habituales:
- Él estructuras HTML incoherentes : una página web puede cambiar sus clases CSS de un día para otro y tu selector ya no devuelva ningún resultado.
- Él datos no estructurados : debes limpiar y reformatear el contenido antes de guardarlo.
- Él lentitud de carga páginas, sobre todo en sitios web dinámicos que muestran su contenido mediante JavaScript.
¿Existen servicios o API de web scraping?
Sí. Existen servicios que simplifican el scraping y se encargan de los aspectos más tediosos: proxies, captchas, páginas dinámicas. También puedes utilizar una API de raspado web para recuperar directamente datos estructurados. Bright Data es una de las soluciones más completas del mercado.
Si quieres saber más, consulta nuestra guía sobre el web scraping con Python y descubre casos de uso más avanzados.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA