Tik Tok es una fuente inagotable de datos: perfiles, etiquetas, estadísticas de vídeos, comentarios. El web scraping te permite extraer todo eso automáticamente. Tienes dos opciones: utilizar un herramienta lista para usar (sin código) o programar el tuyo propio raspador en Python.
A continuación te explicamos cómo hacerlo, paso a paso, con los datos que puedes recabar y lo que establece la ley.

Los diferentes métodos de scraping en TikTok
Para Rascador TikTok, existen dos enfoques principales. La elección depende de tus conocimientos técnicos y de la complejidad de tu proyecto.
- Utilizar herramientas específicas (sin código).
- Programar tu propio rastreador en Python.
1. Utilización de herramientas de web scraping
Es el enfoque más rápido y sencillo, ideal si no tienes ningún conocimiento de programación. Estas herramientas ofrecen soluciones llave en mano y se encargan por ti de los retos técnicos: eludir las protecciones contra los bots, rotar los apoderados, gestión de sesiones.
He aquí tres scrapers de TikTok eficaces:
- Bright Data
- Apify
- Octoparse
Datos brillantes
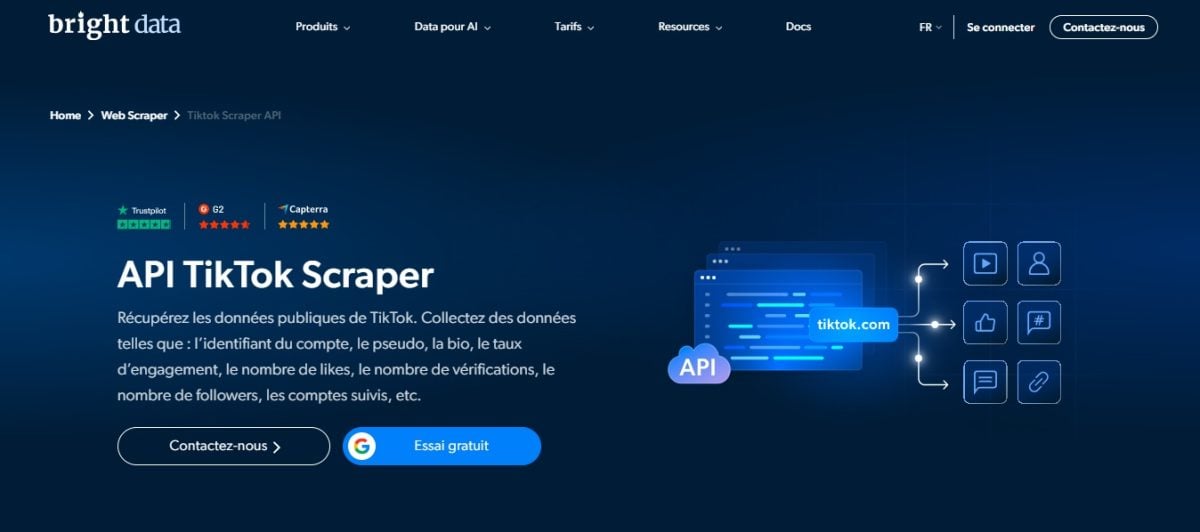
Datos brillantes es una solución completa, reconocida por sus servicios de proxies (residenciales y móviles) y sus herramientas avanzadas de scraping: API específicas, navegador de scraping integrado. Su Rascador TikTok recopila datos sobre perfiles, publicaciones (incluidos los hashtags) y comentarios. Los resultados se pueden exportar a JSON o en CSV para tus análisis.
Es la mejor opción cuando tu proyecto requiere mucho volumen y una infraestructura fiable. Te lo contamos con todo detalle en nuestro revisión completa de Bright Data.
Apify

Apify es una plataforma en la nube de desarrollo de rascadores capaz de realizar extracciones a gran escala.
Su Rascador TikTok Recopila información detallada: perfiles de usuario, hashtags, música asociada a los vídeos y metadatos completos de las publicaciones. Los comentarios se extraen mediante una herramienta específica: el TikTok Comments Scraper.
Esta es la la solución más flexible, ideal cuando quieras personalizar tus extracciones o automatizar tareas recurrentes en la nube. Los datos se exportan a JSON Donde CSV directamente desde la interfaz. Para más detalles, consulta nuestra revisión completa de Apify.
Octoparse
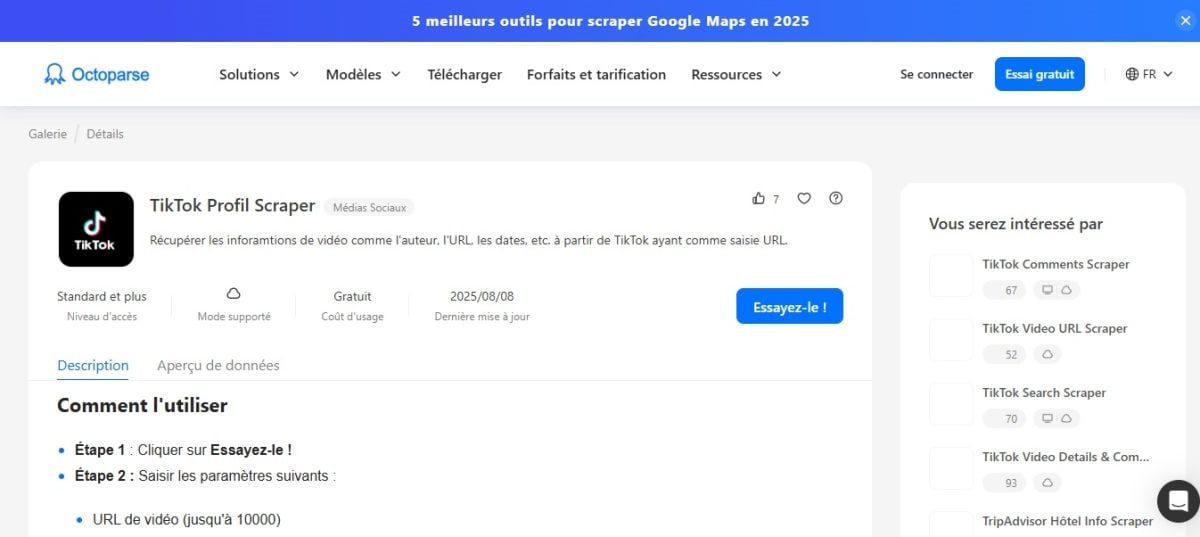
Octoparse es una solución sin código cuya interfaz gráfica te permite crear un scraper con unos pocos clics, sin escribir ni una sola línea de código. La herramienta también ofrece un plantilla TikTok Scraper listo para usar, que luego puedes personalizar según tus necesidades.
Es la opción más asequible para un principiante quien quiera extraer datos rápidamente. Para saber más, lee nuestro revisión completa de Octoparse.
2. Raspado de código con Python
la scraping con Python es un enfoque más técnico y personalizable, que requiere conocimientos básicos de programación. Es la solución ideal si quieres un control total sobre los datos que se van a extraer, los formatos de salida (JSON, CSV) y la frecuencia de las consultas. A continuación te explicamos cómo hacerlo, paso a paso.
Requisitos previos
Para empezar, instala algunas bibliotecas de Python:
pip install requests parsel jmespath selenium scrapfly-sdk
Este comando instala :
- Requests para Peticiones HTTP.
- Parsel para analizar el contenido HTML (selectores XPath).
- JMESPath para filtrar el JSON.
- Selenium para gestionar los páginas de JavaScript si es necesario.
- scrapfly-sdk, el SDK de ScrapFly (servicio de pago, con 1.000 créditos gratuitos para probarlo), que se utiliza más adelante para gestionar el sistema antibots y los proxies.
El método que se utiliza aquí se basa en la extracción de datos de un perfil o de un vídeo a través de la’análisis del JSON oculto en la página de TikTok.
TikTok inserta estos datos directamente en el código HTML de la página, dentro de una etiqueta , lo que evita tener que recurrir a una API oficial.
Paso 1: analizar la solicitud de red
- Ábrelos herramientas de desarrollo (F12) de tu navegador.
- En el Network, observa los solicitudes cargadas cuando visitas un perfil o un vídeo en tiktok.com.
- Localiza la fuente de los datos. En el caso de un perfil o un vídeo, se trata de la etiqueta , visible en el código fuente de la página (pestaña «Elementos»). En el caso de los comentarios, se trata de peticiones XHR dirigidas a una URL del tipo /api/comment/list/, visibles en la pestaña «Red». Su URL completa aparece en la pestaña «Encabezados».
- Para un perfil o un vídeo, solo tienes que utilizar la URL de la página; para los comentarios, la URL del punto final.
Paso 2: enviar la solicitud y recibir la respuesta
Una vez identificada la fuente, utiliza Python para realizar una consulta a la página y extraer el JSON que contiene.
import requests
from parsel import Selector
import json

url = "https://www.tiktok.com/@pseudo"  #: sustituye por la URL de destino
resp = requests.get(url, headers={
    "User-Agent": "Mozilla/5.0"
})
selector = Selector(resp.text)
data = selector.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
profile = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.user-detail"]["userInfo"]
print(profile)
La etiqueta __UNIVERSAL_DATA_FOR_REHYDRATION__ contiene el bloque JSON que TikTok inserta en las páginas de perfil y de vídeo. Este bloque contiene los metadatos del perfil: número de seguidores, número de cuentas a las que sigue, biografía e identificador de usuario. Este método se inspira en ejemplos concretos documentados por ScrapFly.
Paso 3: extraer los datos pertinentes
A continuación, puedes filtrar JSON para quedarnos solo con lo esencial: nombre de usuario, estadísticas de interacción y descripción. Aquí tienes un ejemplo con ScrapFly para los publicaciones de TikTok :
from scrapfly import ScrapeConfig, ScrapflyClient
import json, jmespath

SCRAPFLY = ScrapflyClient(key="TA_CLE")
CONFIG = {"asp": True, "country": "US"}

def parse_post(response):
    sel = response.selector
    data = sel.xpath("//script[@id='__UNIVERSAL_DATA_FOR_REHYDRATION__']/text()").get()
    post = json.loads(data)["__DEFAULT_SCOPE__"]["webapp.video-detail"]["itemInfo"]["itemStruct"]
    return jmespath.search(
 """{
 id: id,
 desc: desc,
 author: author.{uniqueId, nickname},
        stats: stats
 }""",
 post
    )

async def scrape_posts(urls):
    to_scrape = [ScrapeConfig(url, **CONFIG) for url in urls]
    results = []
    async for resp in SCRAPFLY.concurrent_scrape(to_scrape):
 results.append(parse_post(resp))
    return results
Este código muestra cómo analizar correctamente los datos clave de una publicación: nombre de usuario, descripción, autor y estadísticas de interacción (le gusta, comentarios, visualizaciones, veces que se ha compartido). El resultado se puede convertir después en CSV para tus análisis.
Paso 4: gestionar la iteración y la paginación
La API interna de TikTok suele devolver solo una pequeña parte de los resultados cada vez. Para obtener más comentarios, debes gestionar la paginación mediante un bucle. while, que sigue enviando solicitudes al punto final mientras queden datos por cargar.
cursor = 0
all_data = []
while True:
    params = {"count": 20, "cursor": cursor, "aweme_id": post_id}
    resp = requests.get(api_url, params=params)
    data = resp.json()
    comments = data.get("comments", [])
    all_data.extend(comments)
    if not data.get("total") or cursor >= data["total"]:
 break
    cursor += params["count"]
Código simplificado : sustituye «api_url» por «https://www.tiktok.com/api/comment/list/» y «post_id» por el ID del vídeo. En la práctica, TikTok también exige parámetros de sesión obtenidos del navegador, de ahí que sea recomendable utilizar ScrapFly o un navegador sin interfaz gráfica.
Aquí se utiliza el parámetro cursor para paginación a través del punto de acceso interno comentarios. Cada iteración recupera un lote de 20 resultados hasta que se agoten por completo los datos.
¿Por qué chatarra en TikTok?
Recopilar datos públicos de TikTok sirve para tomar mejores decisiones, tanto si te dedicas al marketing, al análisis de datos o a la investigación. A continuación te presentamos cinco casos prácticos en los que extraer datos de TikTok marca realmente la diferencia:
- El análisis de mercado: identificas los tendencias emergentes (hashtags de moda, sonidos populares, nichos de contenido). Al seguir las tendencias emergentes, detectas un tema antes de que se sature.
- El marketing de influencia: Identificas a los creadores más adecuados para tu marca comparando su número de seguidores, su tasa de compromiso el rendimiento real de sus publicaciones, en lugar de fiarte de las cifras que se muestran.
- El análisis de opiniones: Evalúas la percepción de una marca recopilando los comentarios debajo de los vídeos, para ver si las reacciones son positivas, negativas o neutras en general.
- La investigación académica: Los datos extraídos permiten estudiar fenómenos sociales o culturales que se observan en la plataforma, con ejemplos cuantificados y reproducibles.
- La vigilancia competitiva: Vigilas la estrategia de contenido de tus competidores analizando la frecuencia de sus publicaciones, los formatos que funcionan y los vídeos que generan más «me gusta» y visualizaciones.
En todos estos casos, el cumplimiento de las condiciones de uso de TikTok y de las RGPD Es tu responsabilidad, sobre todo cuando manejas información relacionada con usuarios identificables.
preguntas frecuentes
¿Es legal el web scraping en TikTok?
Es una cuestión con matices. En general, la extracción de datos públicos de TikTok no es ilegal en sí misma, pero debes respetar dos cosas: las condiciones de uso de TikTok, que prohíben la recopilación automatizada en sus condiciones de uso, y las leyes sobre protección de datos personales, como la RGPD en Europa.
En la práctica, extraer información pública (hashtags, tendencias, estadísticas agregadas) plantea menos problemas que recopilar datos personales (correos electrónicos, perfiles identificables). Si almacenas datos personales, asumes tu responsabilidad en virtud del RGPD. Para más detalles, lee nuestro artículo sobre la legalidad del web scraping.
¿Cuáles son las mejores herramientas y programas para el scraping de TikTok?
Todo depende de tus necesidades y de tus conocimientos técnicos.
- Para empezar sin programar: Octoparse es la solución más sencilla, gracias a su interfaz visual.
- Para proyectos de gran volumen: Bright Data destaca gracias a sus proxies integrados y a su infraestructura antibloqueo.
- Para automatizar en la nube: Apify ofrece un Rascador TikTok listo para usar con exportación a JSON Donde CSV.
Si prefieres programar tú mismo, Python con bibliotecas como Selenium o el SDK ScrapFly te ofrece un mayor control sobre tus extracciones. Para ver una comparación detallada (precios, ventajas, limitaciones), consulta nuestro artículo sobre las mejores herramientas de raspado web.
¿Qué datos pueden extraerse de TikTok?
Puedes extraer una gran variedad de información pública de TikTok:
- Perfiles de usuario: nombre, biografía, número de seguidores, número de cuentas a las que sigue, ID de usuario.
- Metadatos de los vídeos y las publicaciones: descripción, duración, fecha de publicación, música asociada
- Hashtags y tendencias del momento
- Estadísticas de interacción: le gusta, comparticiones, comentarios, visualizaciones
Todos estos datos se envían en un formato estructurado (JSON), fácil de convertir en CSV para tus análisis.
¿Cómo puedo evitar la protección anti-bot de TikTok?
TikTok está aplicando varias medidas para bloquear a los «scrapers», entre las que se incluyen el análisis del comportamiento de navegación, la huella técnica de las solicitudes (TLS, encabezados, cookies) y la reputación de las direcciones IP.
Estas medidas de protección siguen siendo manejables si se siguen las buenas prácticas:
- Utiliza proxies residenciales rotativos (las direcciones IP de los centros de datos se detectan rápidamente).
- Simular un navegador real con Selenium.
- Añadir retrasos aleatorios entre solicitudes para evitar sobrecargar los servidores.
Cuanto más rápido recopiles datos, mayor será el riesgo de que te detecten. Un ritmo razonable protege tanto a TikTok como tu propio acceso.







 FR
 RU
 EN
 ES
 IT
 DE
 ZH
 PT
 ID
 JA
 DA